Ein Roboter greift ein Metallteil aus einer Kiste und legt es in eine Schale. Eine andere Maschine soll Kaffee über einen Tisch tragen, ohne einen Laptop zu gefährden. Beide Aufgaben verlangen mehr als eine bewegliche Hand: Der Roboter muss erkennen, was für die Aufgabe zählt, und seine Bewegung darauf abstimmen.
Zwei aktuelle Forschungswege beleuchten verschiedene Seiten dieses Problems. Google DeepMind erprobt ein Modell für körperliche Fertigkeiten unter anderem in einer Autofabrik. Ein Team von MIT und New York University untersucht, wie sprachliche Korrekturen die Bewegungsplanung verändern können. Die Ansätze wurden nicht gemeinsam getestet. Gerade ihr Unterschied zeigt, warum eine eindrucksvolle Vorführung noch keine allgemeine Alltagstauglichkeit bedeutet.
Eine Hand braucht einen Plan
Ein Greifer kann nur dann ein Teil passend ablegen, wenn mehrere Schritte zusammenpassen: Das System muss das Objekt wahrnehmen, die Hand dorthin bewegen, es fassen und zum Ziel bringen. Ändert sich die Lage des Teils, genügt eine starr wiederholte Bewegung möglicherweise nicht mehr. Ein Robotermodell versucht deshalb, Beobachtungen und Anweisungen mit passenden Bewegungen zu verbinden.
Google nennt sein neues System Gemini Robotics 2.5 ein Vision-Language-Action-Modell. Vereinfacht verarbeitet es Bildinformationen und Anweisungen und erzeugt daraus Aktionen für den Roboter. Google berichtet, das Modell über mehr als 200 unterschiedliche Aufgaben hinweg geprüft zu haben. Dazu gehören laut Unternehmen auch der Umgang mit Werkzeugen und empfindlichen oder verformbaren Gegenständen.
Ein Teil der Erprobung fand laut Google mit dem humanoiden Roboter Apollo 2 von Apptronik an Produktionslinien von Mercedes-Benz in Sindelfingen und im ungarischen Kecskemét statt. Der Roboter sortierte metallische Halterungen aus Behältern in geordnete Schalen für die Fahrzeugproduktion. Ein weiteres Modell verfolgte dabei den Ablauf; das Aktionsmodell steuerte Arme und Hände.
Für diesen Machbarkeitsversuch nennt Google eine Erfolgsquote von 96 Prozent. Die Zahl bezieht sich auf die beschriebene Sortieraufgabe und stammt vom beteiligten Anbieter. Sie ist keine allgemeine Quote für alle Roboteraufgaben. Wie die Maschine bei anderen Teilen, in anderen Abläufen oder über lange Zeit abschneidet, lässt sich aus dieser Einzelangabe nicht ablesen.
Was ein Zuruf über die Aufgabe verrät
Eine andere Frage beschäftigt das Forschungsteam hinter FLEX: Was macht ein Roboter mit einer Korrektur, die nur einen Teil des eigentlichen Wunsches ausspricht? Wer sagt „Verschütte nichts auf dem Laptop“, meint in einer passenden Situation womöglich auch, dass ein danebenliegendes Telefon trocken bleiben soll.
Im vom MIT beschriebenen Kaffee-Beispiel bewegt sich ein virtueller Roboterarm mit einer Tasse über einen Tisch. Ein Mensch tippt eine Korrektur. FLEX nutzt ein Sprachmodell, um aus dem einzelnen Laptop eine allgemeinere Eigenschaft abzuleiten: Elektronik soll vor der Flüssigkeit geschützt werden. Die Bewegungsplanung kann dann auch das Telefon berücksichtigen.
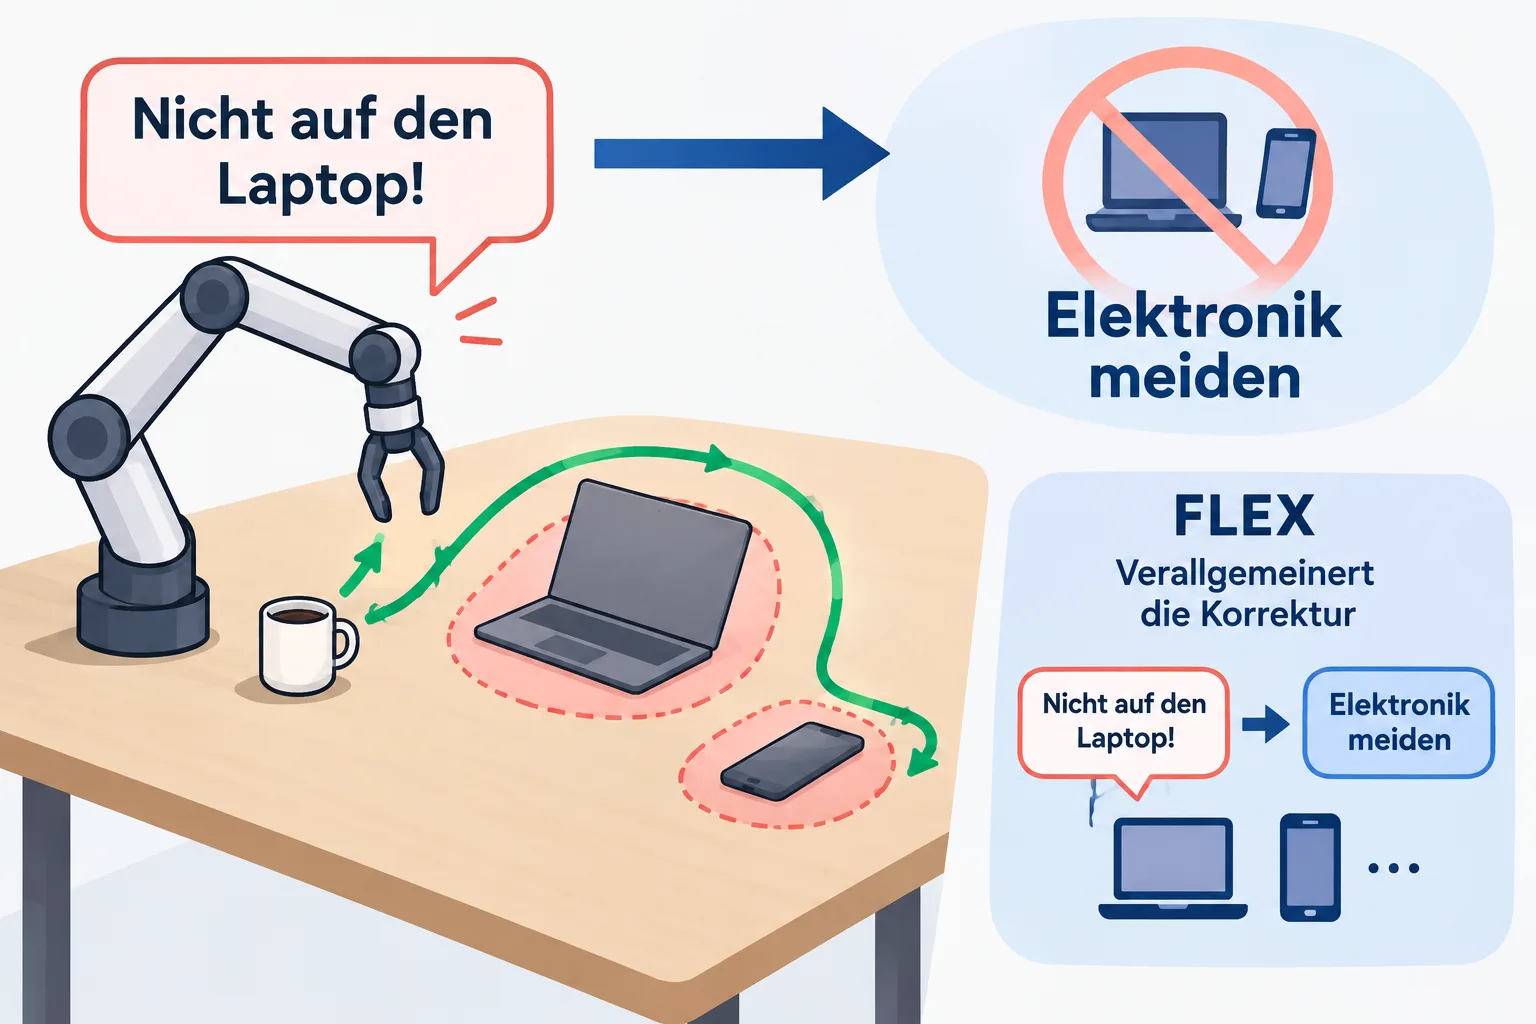
Die Methode verändert dafür die Liste der Merkmale, die bei einer Aufgabe zählen. Sie kann ein fehlendes Merkmal hinzufügen, eine zu enge Regel verallgemeinern und ein nicht mehr relevantes Merkmal ausblenden. Aus menschlichen Demonstrationen lernt das System zusätzlich, wie stark solche Merkmale bei der Wahl einer Bewegung berücksichtigt werden sollen.
Der Unterschied ist praktisch: Eine Liste, die nach jeder Korrektur nur länger wird, kann an einzelnen Gegenständen hängen bleiben. Eine allgemeinere Regel kann mehrere ähnliche Gegenstände erfassen. Sie muss aber zur Absicht des Menschen passen. Wer nur den Laptop meint, erwartet nicht zwingend, dass jedes elektronische Gerät zur Sperrzone wird. Sprache hilft also bei der Anpassung; sie beseitigt die Aufgabe nicht, die richtige Interpretation zu finden.
Simulation und Fabrikversuch beantworten verschiedene Fragen
Die FLEX-Studie untersucht zweidimensionale Navigation, simulierte Tischaufgaben mit einem Franka-Roboterarm und eine reale Studie mit natürlichen sprachlichen Korrekturen und Roboterdemonstrationen. Das Kaffee-Szenario ist eine Simulation. Das Forschungspapier beschreibt darüber hinaus reale Versuche; es wäre deshalb falsch, die gesamte Arbeit auf eine reine Simulation zu reduzieren.
Der Fabrikversuch und FLEX lassen sich nicht anhand einer einzigen Erfolgszahl gegeneinander aufrechnen. Sie verfolgen unterschiedliche Ziele: Im einen Fall geht es um das Ausführen einer konkreten Sortierarbeit, im anderen um die Anpassung einer Aufgabenbeschreibung und Bewegungsplanung an menschliche Rückmeldungen. Auch ein erfolgreich gewählter Weg beantwortet noch nicht jede Frage zur physischen Ausführung, etwa wie zuverlässig eine Hand einen bestimmten Gegenstand hält.
Umgekehrt sagt ein gut trainierter Griff für sich genommen noch nicht, welche Dinge der Mensch in einer neuen Situation schützen möchte. In einer Fabrik können Aufgabe und Umgebung vergleichsweise klar umrissen sein. Im Haushalt wechseln Gegenstände, Wege und persönliche Vorlieben. Ein nützlicher Helfer müsste deshalb Wahrnehmung, Bewegung und Korrekturen zusammenbringen und mit Unklarheit umgehen können.
Fortschritt lässt sich an der Aufgabe erkennen
Schon im Juli hatte Google Robotics 2 vorgestellt. Damals zeigte das Unternehmen Aufgaben mit unterschiedlichen Robotertypen und bezeichnete feinmotorische Tätigkeiten mit mehreren Fingern weiterhin als schwierig. Die neue Generation soll laut Google breiter und geschickter arbeiten. Für die Einordnung zählt, welche konkrete Aufgabe unter welchen Bedingungen tatsächlich geprüft wurde.
Die beiden aktuellen Ansätze ergänzen sich als Forschungsfragen: Ein Roboter muss Dinge bewegen können und verstehen, welche Eigenschaften seiner Umgebung für den Auftrag wichtig sind. Der Weg vom Sortieren einer Halterung oder einer simulierten Kaffeefahrt zu einer Vielzahl wechselnder Alltagssituationen besteht aus vielen solchen Einzelschritten. Ob sie zuverlässig zusammenspielen, müssen weitere praktische Einsätze zeigen.
Quellen
- Google DeepMind: Gemini Robotics 2.5, 10. November 2026
- Lee und andere: Flexible Language-Guided Representation Editing for Adaptive Robot Behavior, 2026
- MIT News: AI-assisted learning platform helps robots reason beyond literal commands, 9. November 2026
- Google DeepMind: Gemini Robotics 2, 30. Juli 2026
Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft.