Ein Klimamodell mit absichtlich ungewöhnlichen Emissionsverläufen zu trainieren, klingt zunächst widersinnig. Doch genau solche künstlichen Kurven könnten schnellen KI-Modellen helfen, unbekannte Klimaszenarien besser nachzubilden. Ein Forschungsteam um Christopher Womack hat dafür Trainingsdaten gezielt optimiert und in Modellversuchen mit herkömmlichen Szenarien verglichen.
Das Ergebnis: Bei einem einfachen Klimamodell übertraf ein Emulator, der mit einem einzigen optimierten Szenario trainiert wurde, einen Vergleichsemulator mit sechs üblichen Szenarien. Auch bei einem Modell mittlerer Komplexität verbesserte sich der Emulator. Ein Test mit einem vollständigen Erdsystemmodell steht allerdings noch aus, wie das MIT berichtet.
Warum ein schneller Stellvertreter gebraucht wird
Forschende möchten wissen, wie sich Temperatur oder andere Eigenschaften des Klimas unter verschiedenen Annahmen über künftige Emissionen entwickeln könnten. Dafür nutzen sie komplexe Erdsystemmodelle, die viele Vorgänge und Wechselwirkungen rechnerisch darstellen. Ein einzelner Durchlauf kann auf leistungsfähigen Rechnern lange dauern. Wer viele mögliche Entwicklungen vergleichen will, braucht deshalb viel Rechenzeit.
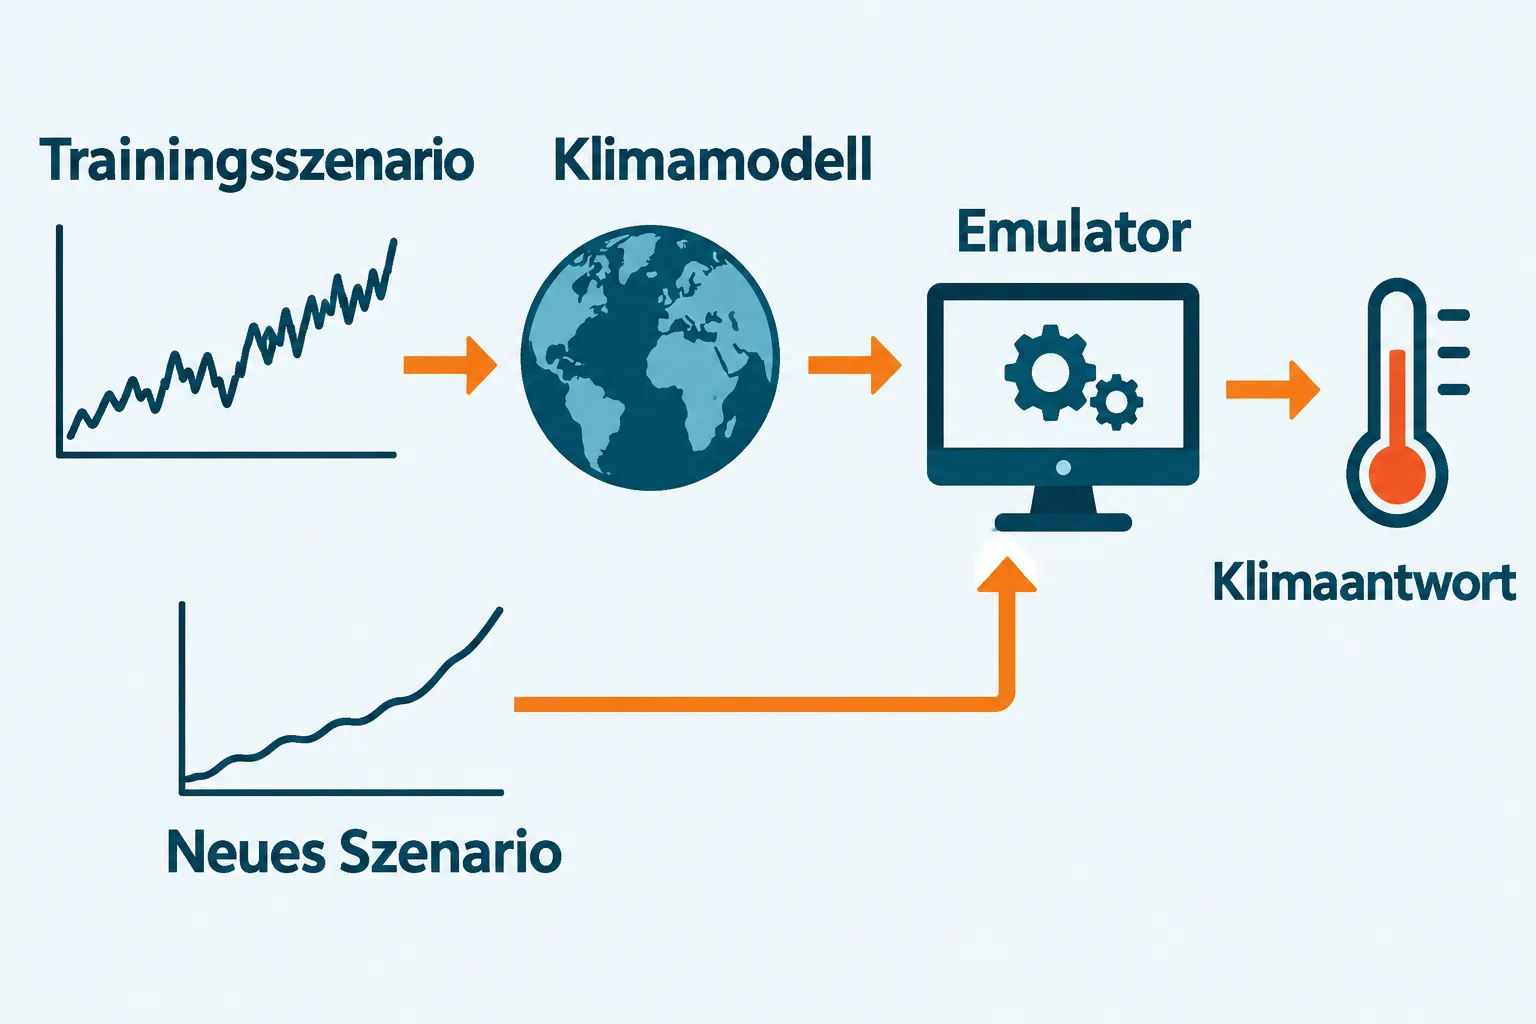
Ein Klimaemulator übernimmt eine andere Aufgabe: Er lernt, das Verhalten eines solchen Modells näherungsweise nachzuahmen. Nach dem Training kann er neue Eingaben sehr schnell auswerten. Er ersetzt damit nicht die Beobachtung der realen Erde, sondern ahmt einen bestimmten rechnerischen Zusammenhang nach. Seine Antworten hängen davon ab, was er aus den Trainingsdaten gelernt hat.
Üblicherweise entstehen diese Daten aus mehreren Emissionsszenarien, die durch ein Klimamodell gerechnet werden. Die Szenarien beschreiben plausible Entwicklungen über die Zeit. Das Problem: Ähneln sich ihre Verläufe zu stark, lernt der Emulator möglicherweise nicht genug über Situationen, die anders aussehen als seine Beispiele.
Ungewöhnliche Kurven als Trainingsmaterial
Das Team wählt deshalb einen anderen Weg. Es lässt ein Verfahren die Trainingsszenarien schrittweise verändern und prüft, wie sich diese Änderungen auf den Fehler des Emulators auswirken. Ziel sind Eingaben, aus denen der Emulator möglichst viel über das simulierte System lernen kann. Die Kurven müssen dafür keine wahrscheinliche Zukunft beschreiben.
Ein gedachtes Beispiel macht den Unterschied sichtbar: Statt einen langsamen Anstieg der Emissionen zu zeigen, könnte eine Trainingskurve zunächst stark steigen und später abrupt fallen. Solche Wechsel helfen dem Modellversuch zufolge, unterschiedliche Reaktionen des Klimasystems auseinanderzuhalten. Die künstliche Kurve ist hier ein Lernwerkzeug und keine Vorhersage, dass die Emissionen tatsächlich so verlaufen werden.
Was der Vergleich zeigt
In der veröffentlichten Studienfassung beschreibt das Team den Vergleich mit sechs standardisierten Szenariopfaden. Im einfachen Modell erzielte das Training mit einem optimierten Szenario eine höhere Vorhersagegüte für die untersuchten, zuvor nicht gesehenen Verläufe. Dabei gelang es dem Emulator laut Studie, unterschiedliche Einflüsse etwa von Treibhausgasen und Aerosolen zu unterscheiden, ohne für jeden Einfluss einen gesonderten Trainingslauf zu benötigen.
Die Forschenden übertrugen anschließend die mit dem einfachen Modell optimierten Szenarien auf ein Klimamodell mittlerer Komplexität. Auch dort lieferten die so erzeugten Trainingsdaten einen leistungsfähigeren Emulator als die verglichenen Standardpfade. Das Ergebnis spricht dafür, die Auswahl der Trainingsdaten selbst als Teil der Modellgestaltung zu behandeln.
Für die praktische Anwendung ist die Abgrenzung entscheidend. Die Studie vergleicht Emulatoren anhand bestimmter Modelle und Tests. Sie beweist nicht, dass ein einzelner künstlicher Verlauf für jede Klimafrage genügt oder dass ein Emulator die Unsicherheit der zugrunde liegenden Modelle beseitigt. Nach Angaben des MIT möchte das Team das Verfahren künftig mit einem vollständigen Erdsystemmodell erproben.
Wenn sich der Ansatz dort bewährt, könnten Forschende mit weniger aufwendigen Trainingsläufen schnellere Werkzeuge für den Vergleich vieler Annahmen erstellen. Bis dahin zeigt die Arbeit vor allem einen Weg, aus begrenzter Rechenzeit mehr geeignete Trainingsinformation zu gewinnen.
Quellen
- Womack und Mitautoren: Optimal scenario design for climate emulation, Forschungsfassung 2026
- MIT News: New research could lead to faster, trustworthy AI models for climate prediction, 12. November 2026
Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft.