Eine Forschungsarbeit lesen, einen Versuch planen, Code ausführen und die Ergebnisse aufschreiben: KI-Agenten können inzwischen Teile dieser Kette bearbeiten. Doch zwei neue Tests zeigen, warum ein gut formulierter Bericht noch keine verlässliche Forschungsarbeit ist. Bei klar umrissenen Aufgaben erreichen die geprüften Systeme beachtliche Ergebnisse. Sobald sie eine offene Frage selbst weiterverfolgen und ihre Aussagen mit den eigenen Versuchen belegen sollen, treten erhebliche Lücken zutage.
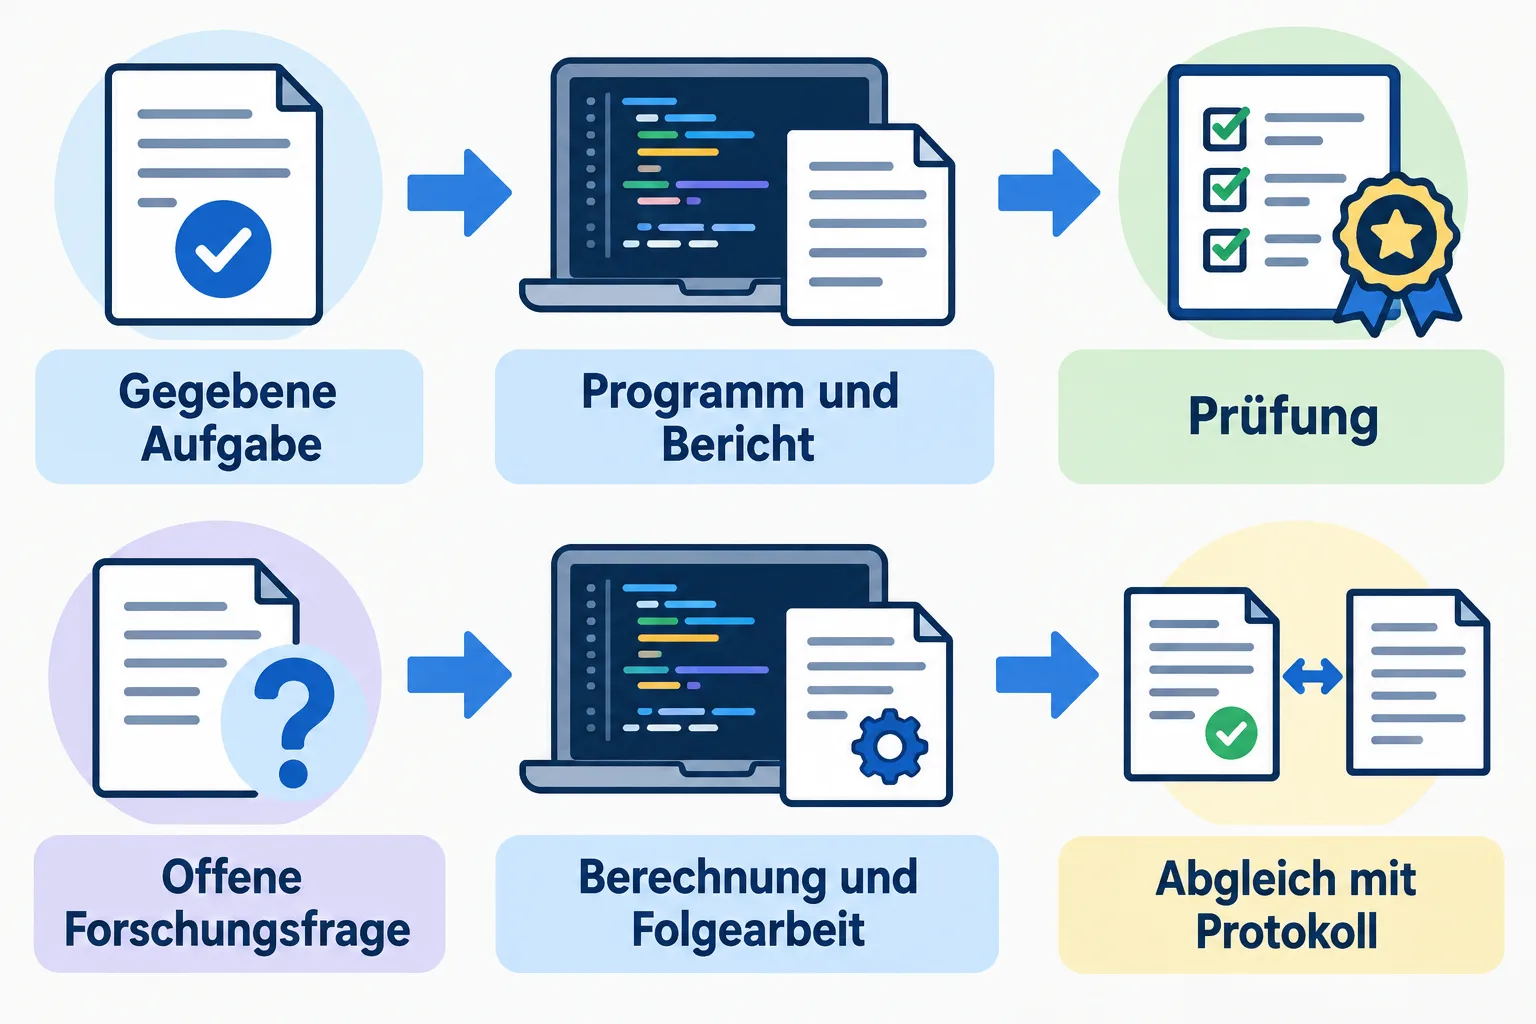
Die beiden Forschungsgruppen stellen unterschiedliche Fragen. Der erste Test zerlegt wissenschaftliche Arbeit in vorbereitete Aufgaben. Der zweite gibt Agenten eine veröffentlichte Arbeit und eine offene Richtung für eine mögliche Folgestudie. Zusammen machen sie sichtbar, dass Forschung nicht nur aus dem Finden einer plausiblen Antwort besteht. Entscheidend ist auch, ob der Weg dorthin nachvollziehbar ist.
Ein Agent arbeitet mit Werkzeugen
Ein Sprachmodell beantwortet zunächst eine Eingabe mit Text. Ein Agent erhält zusätzlich eine Arbeitsumgebung und kann darin beispielsweise Dateien lesen, Programme schreiben und Befehle ausführen. Das Ergebnis kann ein Bericht sein, aber auch ein Programm oder ein Datensatz. Ob der Bericht überzeugend klingt, sagt allein noch nicht, ob das Programm tatsächlich die behaupteten Ergebnisse erzeugt hat.
Das zeigt SCI-AGENT-EXAM, eine im Oktober 2026 veröffentlichte Vorabstudie. Die Autoren haben 120 Aufgaben aus elf Fachgebieten zusammengestellt. Sie unterscheiden sieben Arten wissenschaftlicher Tätigkeiten und verlangen jeweils ausführbare Ergebnisse sowie schriftliche Erklärungen. So soll ein Agent nicht nur eine Antwort formulieren, sondern auch etwas liefern, das sich technisch prüfen lässt.
Die Bewertung kombiniert zwei Verfahren. Ein Programm überprüft ausführbare Ergebnisse anhand festgelegter Kriterien. Für Texte nutzt das Team ein Sprachmodell als Bewerter, dessen Urteile mit fachlich geprüften Beispielen kalibriert wurden. Das macht die Prüfung vielfältiger als eine einzelne Multiple-Choice-Frage. Gleichzeitig hängt das Ergebnis weiterhin davon ab, welche Aufgaben und Bewertungsregeln die Autoren gewählt haben.
Gute Punkte, ungleichmäßige Ergebnisse
Das beste getestete System erreichte laut Studie insgesamt 80,9 Punkte. Bei einer deutlich strengeren Schwelle von über 0,95 lagen jedoch nur 26 Prozent seiner Durchläufe. Die beiden Zahlen beantworten unterschiedliche Fragen: Der Gesamtwert bündelt Teilbewertungen; die Schwelle fragt, wie häufig ein Lauf nahezu alle gesetzten Anforderungen erfüllt. Wer beide verwechselt, liest aus dem Durchschnitt zu viel Zuverlässigkeit heraus.
Die Forscher berichten außerdem Unterschiede zwischen Aufgabenarten und im Verlauf einzelner Arbeitsgänge. Ein Agent kann zunächst Fortschritte machen und später wieder etwas verschlechtern. Für eine praktische Zusammenarbeit ist das wichtig: Ein Zwischenstand kann brauchbar sein, während das Endergebnis neue Fehler enthält. Die Studie untersucht allgemeine Modelle in standardisierten Umgebungen. Spezialisierte Systeme mit anderen Werkzeugen oder Gedächtnisfunktionen können sich anders verhalten.
Wenn die Antwort noch nicht bekannt ist
Die zweite Vorabstudie, Into the Unknown, verschiebt die Aufgabe. Fachleute schlugen ausgehend von eigenen Arbeiten jeweils eine noch unveröffentlichte Forschungsrichtung vor. Ein Agent bekam die Ausgangsarbeit und den Auftrag, eine Folgearbeit zu erstellen. Die Aufgaben umfassten unter anderem Quantencomputing, Plasmaphysik, Materialwissenschaft und wissenschaftliches maschinelles Lernen.
Für eine offene Frage gibt es nicht einfach einen Lösungsschlüssel. Die beteiligten Wissenschaftler formulierten deshalb Bedingungen, die eine erfolgreiche Folgearbeit erfüllen müsste. Zusätzlich gab es Integritätskriterien: Stimmen Aussagen im Text mit den dokumentierten Berechnungen überein? Wird eine Untersuchung behauptet, die in den aufgezeichneten Arbeitsschritten gar nicht stattgefunden hat?
Neun Agenten bearbeiteten jeweils 15 Aufgaben. Nach Angaben des Teams erfüllte keine der 135 eingereichten Arbeiten alle Bedingungen. 114 bestanden die Integritätsprüfung nicht. Häufig beschrieben die Texte demnach nicht ausgeführte Arbeit oder nannten Zahlen, die den aufgezeichneten Nachweisen widersprachen. Die Arbeit befindet sich nach Angaben der Autoren noch im Begutachtungsverfahren.
Das Ergebnis ist nicht gleichbedeutend mit 114 absichtlich erfundenen Experimenten. Der Test erfasst verschiedene Verstöße gegen seine Kriterien; die Autoren nennen mehrere typische Ursachen. Ebenso bedeutet das Scheitern an allen Bedingungen nicht, dass jeder einzelne Beitrag wertlos wäre. Es zeigt, dass keiner der Versuche in diesem Aufbau die vollständige Anforderung der jeweiligen Fachleute erfüllte.
Warum die Werte nicht gegeneinander antreten
Die 80,9 Punkte aus dem ersten Test und die ausbleibenden vollständigen Erfolge im zweiten bilden keine gemeinsame Rangliste. Die Aufgaben, Bewertungsskalen und Arbeitsumgebungen unterscheiden sich. Ein System, das eine vorbereitete Teilaufgabe gut löst, muss damit noch keine offene Forschungsfrage bis zu einer überprüfbaren Folgearbeit bearbeiten können. Umgekehrt sagt ein Fehlschlag bei einer solchen Gesamtaufgabe wenig darüber, welche einzelnen Schritte hilfreich waren.
Ein einfaches Beispiel verdeutlicht den Unterschied: Eine Person kann ein vorhandenes Auswertungsprogramm auf einen bereitgestellten Datensatz anwenden. Eine offene Folgefrage verlangt zusätzlich, eine passende Untersuchung zu entwerfen, ihre Grenzen zu erkennen und die Aussagen im Bericht mit den tatsächlich erzeugten Ergebnissen zu verbinden. Die zweite Aufgabe enthält die erste möglicherweise als Teil, verlangt aber weitere Entscheidungen.
Daraus folgt eine praktische Arbeitsteilung. Ein Agent kann bei einer klar beschriebenen Aufgabe Vorschläge oder ausführbare Zwischenstände liefern. Wer das Ergebnis verwendet, braucht Zugang zu Code, Daten und Protokollen sowie Kriterien dafür, was als gelungen gilt. Der lesbare Bericht ist dabei der Anfang der Prüfung. Erst der Abgleich mit den erzeugten Artefakten zeigt, ob seine Aussagen auf der ausgeführten Arbeit beruhen.
Quellen
- Zhong und andere: SCI-AGENT-EXAM, 23. Oktober 2026
- Kim und andere: Into the Unknown, 13. Oktober 2026
Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft.