32 Minuten können im Labor gerade reichen, um einen Versuch vorzubereiten. In einer neuen Arbeit von OpenAI, PerturbAI und Scripps Research genügte diese Zeit für Tausende parallel arbeitende KI-Agenten, um bereits erhobene Daten aus Millionen Gehirnzellen von Mäusen auszuwerten und mit Fachliteratur zu verbinden. Das Team stellte der Laufzeit einen geschätzten menschlichen Aufwand von Monaten bis zu einem Jahr gegenüber. Eine eindrucksvolle Zahl. Für ihr Verständnis kommt es darauf an, wo die Stoppuhr beginnt.
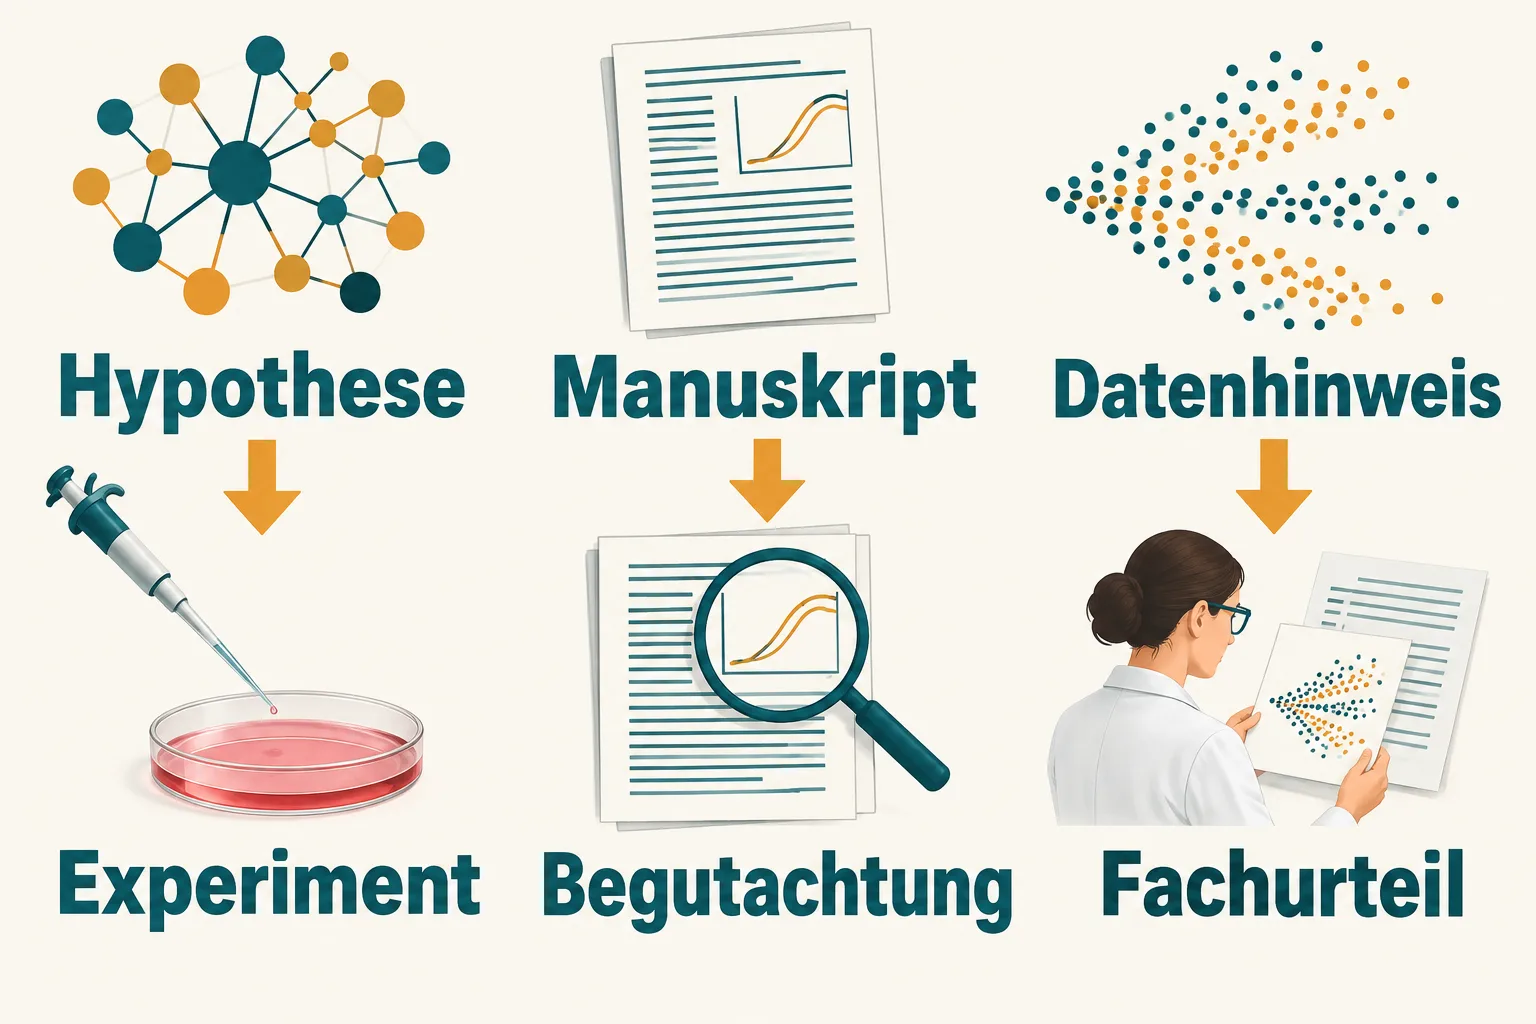
Die Zellen waren untersucht, die Daten vorhanden. Beschleunigt wurde ihre Interpretation. Diese Unterscheidung führt zu einer größeren Entwicklung: KI-Systeme übernehmen inzwischen sehr verschiedene Teile wissenschaftlicher Arbeit. Google lässt sie Hypothesen entwickeln, Sakana AI hat vollständige Manuskripte begutachten lassen, OpenAI und seine Partner erschließen große biologische Datensätze. Was dabei als Erfolg zählt, hängt vom erzeugten Ergebnis ab. Die These dieses Vergleichs lautet: Mit der Geschwindigkeit der Ideenproduktion wächst die Bedeutung der Prüfung, die zu jeder einzelnen Ergebnisart passt.
Wo die 32 Minuten anfangen
Die am 21. Oktober 2026 veröffentlichte OpenAI-Projektbeschreibung nennt den Ansatz verteiltes biologisches Schlussfolgern. Einzelne Agenten untersuchen Veränderungen nach Eingriffen in Gene, suchen passende Veröffentlichungen und schlagen Erklärungen vor. Anschließend werden die Berichte zu einem gemeinsamen Wissensatlas verbunden. So lässt sich ein großer Bestand auf viele überschaubare Aufgaben verteilen.
Man kann sich das wie die Auswertung eines umfangreichen Archivs vorstellen. Eine Person arbeitet Akte für Akte durch. Viele Bearbeiter können gleichzeitig anfangen, müssen ihre Ergebnisse anschließend aber sinnvoll zusammenführen. Die kurze verstrichene Zeit beschreibt dann die parallele Bearbeitung; der gesamte Aufwand verteilt sich auf viele Beteiligte. Bei KI übernehmen Rechenressourcen diese Rolle.
Im Originalpreprint von Sun und Kollegen, auf bioRxiv am 16. Oktober eingestellt, steht die Rechenbasis des menschlichen Vergleichs: 15 Minuten zur Interpretation eines einzelnen Geneingriffs und zehn Minuten pro gelesenem Paper. Daraus entstehen illustrative Schätzungen für serielle menschliche Arbeit. Die Zahl stammt also aus einer Modellrechnung mit angenommenen Arbeitsschritten; ein Forschungsteam wurde dafür nicht monatelang beim Erledigen derselben Aufgabe gestoppt.
Für den praktischen Wert ist das durchaus interessant. Eine breite Vorrecherche kann sich lohnen, selbst wenn nur wenige ihrer Hinweise später weiterverfolgt werden. Der passende Anschlussvergleich wäre, wie viel nachvollziehbare und brauchbare Information Forschende nach der Prüfung tatsächlich erhalten. Laufzeit, Rechenaufwand und nachträgliche Kontrolle beschreiben dabei verschiedene Seiten derselben Arbeit.
Wenn eine gute Idee das Ergebnis ist
Ein anderes Arbeitsstück stellte Google bereits im Februar 2025 mit dem AI co-scientist vor. Forschende geben ein Ziel vor. Spezialisierte Agenten erzeugen, kritisieren, vergleichen und überarbeiten Hypothesen. Das System organisiert damit eine Art digitales Forschungsgespräch, in dem verschiedene Vorschläge gegeneinander antreten.
Google verwendet für diese internen Vergleiche eine Elo-Wertung, ähnlich dem Prinzip einer Schachrangliste. Wer in Vergleichen häufiger gewinnt, steigt auf. Der Vergleich entscheidet, welcher Vorschlag innerhalb des Systems stärker erscheint. Für den Übergang zur Wissenschaft muss zusätzlich eine andere Frage beantwortet werden: Welche Beobachtung würde für diese Erklärung sprechen, welche gegen sie?
Google berichtete auch über ausgewählte Laborprüfungen, unter anderem an Zelllinien, sowie über die Wiederentdeckung eines Mechanismus des bakteriellen Gentransfers. Im letzteren Fall hatten Forschende den Mechanismus zuvor experimentell untersucht; das System sollte ihn ohne Kenntnis der unveröffentlichten Entdeckung herleiten. Solche Prüfungen verbinden die rechnerische Ideenbildung mit einem Gegenstand außerhalb der eigenen Bewertungsschleife.
Eine Hypothese ist deshalb bereits ein sinnvoller Beitrag. Sie muss nicht sämtliche späteren Forschungsschritte enthalten. Ihr Wert liegt darin, eine konkrete Untersuchung zu ermöglichen: Welchen Faktor verändert man, was misst man, und welches Ergebnis würde die Erklärung erschüttern? Eine elegante Formulierung gewinnt an wissenschaftlicher Bedeutung, sobald sie einen solchen Unterschied im Experiment macht.
Ein Manuskript trifft auf Gutachter
Sakana AI prüfte 2025 einen anderen Teil der Kette. Der AI Scientist-v2 sollte eine Idee entwickeln, Rechenexperimente durchführen, Ergebnisse darstellen und ein Manuskript schreiben. Laut Projektbericht vom 12. März wählten Menschen drei erzeugte Arbeiten für einen Workshop bei der ICLR 2025 aus. Eine davon erhielt Bewertungen oberhalb der Annahmeschwelle, zwei erreichten sie nicht.
Für das Experiment war vereinbart, erfolgreiche KI-Manuskripte vor der Veröffentlichung zurückzuziehen. Eine zusätzliche abschließende Meta-Begutachtung fand bei der zurückgezogenen Arbeit nicht statt. Das Ergebnis beschreibt damit eine konkrete Workshopprüfung. Die drei eingereichten Texte waren zudem eine menschliche Auswahl aus erzeugten Arbeiten; aus dem Verhältnis eins zu drei lässt sich keine allgemeine Erfolgsquote des Systems berechnen.
Technisch interessant ist, wie das System seine Experimente organisiert. Der im April veröffentlichte technische Bericht beschreibt eine Baumstruktur verschiedener Programm- und Experimentvarianten. Ein Agent verfolgt den Fortschritt und entscheidet über weitere Schritte. So kann die Software mehrere Richtungen erkunden und vielversprechende Ansätze weiterbearbeiten, statt lediglich einen vorgegebenen Text auszufüllen.
Die Arbeit mit den guten Workshopbewertungen hatte dabei ein negatives Ergebnis: Der untersuchte Zusatz zum Training neuronaler Netze brachte keine überzeugende Verbesserung und verschlechterte die Leistung teilweise. Das ist wissenschaftlich keineswegs nutzlos. Eine sauber untersuchte Sackgasse kann anderen Zeit sparen. Die Gutachter würdigten diesen Beitrag, benannten aber auch Erklärungs- und Methodenschwächen. Die Autoren selbst sahen zusätzlichen Entwicklungsbedarf für das Niveau einer Hauptkonferenz.
Ein Fachurteil beantwortet eine andere Frage als ein Versuch
Beim aktuellen biologischen Wissensatlas ließen die Forschenden ihre Berichte durch Fachleute bewerten. Der Preprint beschreibt 30 promovierte biologische Experten, die 60 Berichte unter anderem nach Neuheit, Belegstützung und Priorität für weitere Forschung beurteilten. In einem gesonderten paarweisen Vergleich standen Auswertungen verteilter Agenten denen eines einzelnen Agenten gegenüber.
OpenAI nennt dafür eine Präferenz von 75 Prozent zugunsten der verteilten Berichte. Diese Zahl beschreibt, welche Auswertung die Bewertenden bevorzugten. Sie ist keine Trefferquote bestätigter biologischer Entdeckungen. Das Fachurteil hilft hier vor allem bei einer kostbaren Entscheidung: Welcher Hinweis verdient die nächste aufwendige Untersuchung?
Der naheliegende Einwand gegen all diese Unterscheidungen ist berechtigt: Forschung besteht ohnehin aus vielen kleinen Beiträgen. Wer nur eine fertige Therapie oder einen großen Durchbruch gelten lässt, würde auch menschliche Vorarbeiten unfair bewerten. Gute Ideen, negative Rechenresultate und erschlossene Daten können unmittelbar nützlich sein. Gerade deshalb verdienen sie eine Beschreibung, die ihren jeweiligen Beitrag erkennbar macht.
Aus den drei Ansätzen entsteht keine Rangliste der besten KI-Forscher. Dafür unterscheiden sich Aufgaben, Datengrundlagen und Prüfungen zu stark. Sichtbar wird vielmehr eine Arbeitsteilung: Systeme können den Raum möglicher Erklärungen vergrößern, Experimente im Rechner organisieren und vorhandenes Wissen zusammenführen. Forschende entscheiden an den Übergängen, was daraus folgt und welche Prüfung als Nächstes Information bringt.
Die produktivste Frage nach einer Meldung über rasante KI-Forschung lautet daher: Was liegt nach Ablauf der genannten Zeit auf dem Tisch? Ein prüfbarer Vorschlag, ein nachvollziehbares Rechenexperiment oder ein priorisierter Datenhinweis verlangt jeweils einen anderen nächsten Schritt. Erst wenn dieser Schritt gelingt, wird aus schneller Bearbeitung ein belastbarer Erkenntnisgewinn.
Quellen
- OpenAI: Using thousands of AI agents to uncover new leads in biological data, 21. Oktober 2026.
- Alexander Sun et al.: Distributed AI agents enable comprehensive discovery of biological insights at scale, bioRxiv-Preprint, eingestellt am 16. Oktober 2026.
- Juraj Gottweis und Vivek Natarajan, Google Research: Accelerating scientific breakthroughs with an AI co-scientist, 19. Februar 2025.
- Sakana AI: The AI Scientist Generates its First Peer-Reviewed Scientific Publication, 12. März 2025, ergänzt am 7. April 2025.
- Yutaro Yamada et al.: The AI Scientist-v2: Workshop-Level Automated Scientific Discovery via Agentic Tree Search, arXiv, 10. April 2025.
Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft.