Eine KI kann das Wetter für die nächsten Stunden gut nachbilden und trotzdem nach vielen Rechenschritten aus der Kurve fliegen. Kleine Fehler gehen in die nächste Berechnung ein, werden erneut verarbeitet und können sich aufschaukeln. Für Modelle, die langfristige Muster der Atmosphäre untersuchen sollen, ist das ein Problem: Irgendwann beschreibt das Ergebnis nicht mehr die Welt, sondern einen Rechenfehler.
Ein Team am Massachusetts Institute of Technology (MIT) hat deshalb eine mathematische Leitplanke entwickelt. Sie hält die Verläufe bestimmter KI-Modelle in einem begrenzten Bereich, ohne ihnen jede Unregelmäßigkeit auszutreiben. Die Forschenden zeigen das zunächst an vereinfachten chaotischen Systemen. Ein vollständiges Klimamodell haben sie damit noch nicht erprobt. Der Ansatz macht aber eine zentrale Frage sichtbar: Wie viel Physik braucht ein lernendes Modell, damit seine langen Simulationen brauchbar bleiben?
Wenn der nächste Schritt den Fehler mitnimmt
Eine Simulation beginnt mit einem Zustand: etwa einer Verteilung von Temperatur und Luftbewegung. Aus diesem Zustand berechnet das Modell den nächsten und daraus wiederum den übernächsten. Ein lernendes Verfahren kann solche Übergänge anhand vorhandener Daten nachbilden. Sein Vorteil liegt darin, komplexe Zusammenhänge aus Beispielen zu erfassen, statt jede Einzelheit ausdrücklich vorzugeben.
Doch die Maschine begegnet bei einem langen Lauf Zuständen, die von ihren Trainingsbeispielen abweichen. Trifft sie dort eine leicht falsche Entscheidung, wird diese zum Ausgangspunkt für den nächsten Schritt. Selbst wenn jede einzelne Abweichung klein wirkt, kann der gesamte Verlauf schließlich in Bereiche geraten, die für das modellierte System keinen Sinn ergeben.
Das ist von der normalen Unvorhersagbarkeit chaotischer Systeme zu unterscheiden. Bei chaotischer Dynamik können winzige Unterschiede am Anfang zu sehr unterschiedlichen späteren Zuständen führen. Die genauen Wege sind schwer vorherzusagen, obwohl sich das System weiterhin innerhalb eines charakteristischen Bereichs bewegt. Ein Modell sollte diese Vielfalt zulassen, ohne künstlich ins Unbegrenzte zu wachsen.
Eine Grenze, die das Modell mitlernt
Genau dort setzt die Studie von Sunbochen Tang, Themistoklis Sapsis und Navid Azizan an. Das Team lässt das neuronale Netz nicht nur die Dynamik aus Daten lernen, sondern auch eine energieähnliche Größe und einen zugehörigen begrenzten Bereich. Eine zusätzliche Rechenschicht verändert die vorhergesagte Entwicklung so, dass diese Größe außerhalb des Bereichs abnimmt.
Anschaulich ist das wie eine Rückführung in ein Spielfeld: Innerhalb darf der Verlauf kompliziert und unregelmäßig bleiben. Entfernt er sich zu weit, wirkt die mathematische Bedingung einer weiteren ungebremsten Entfernung entgegen. Die Grenze ist dabei keine willkürlich eingestellte Höchsttemperatur. Sie entsteht mit dem Modell aus den Daten und der gewählten Struktur.
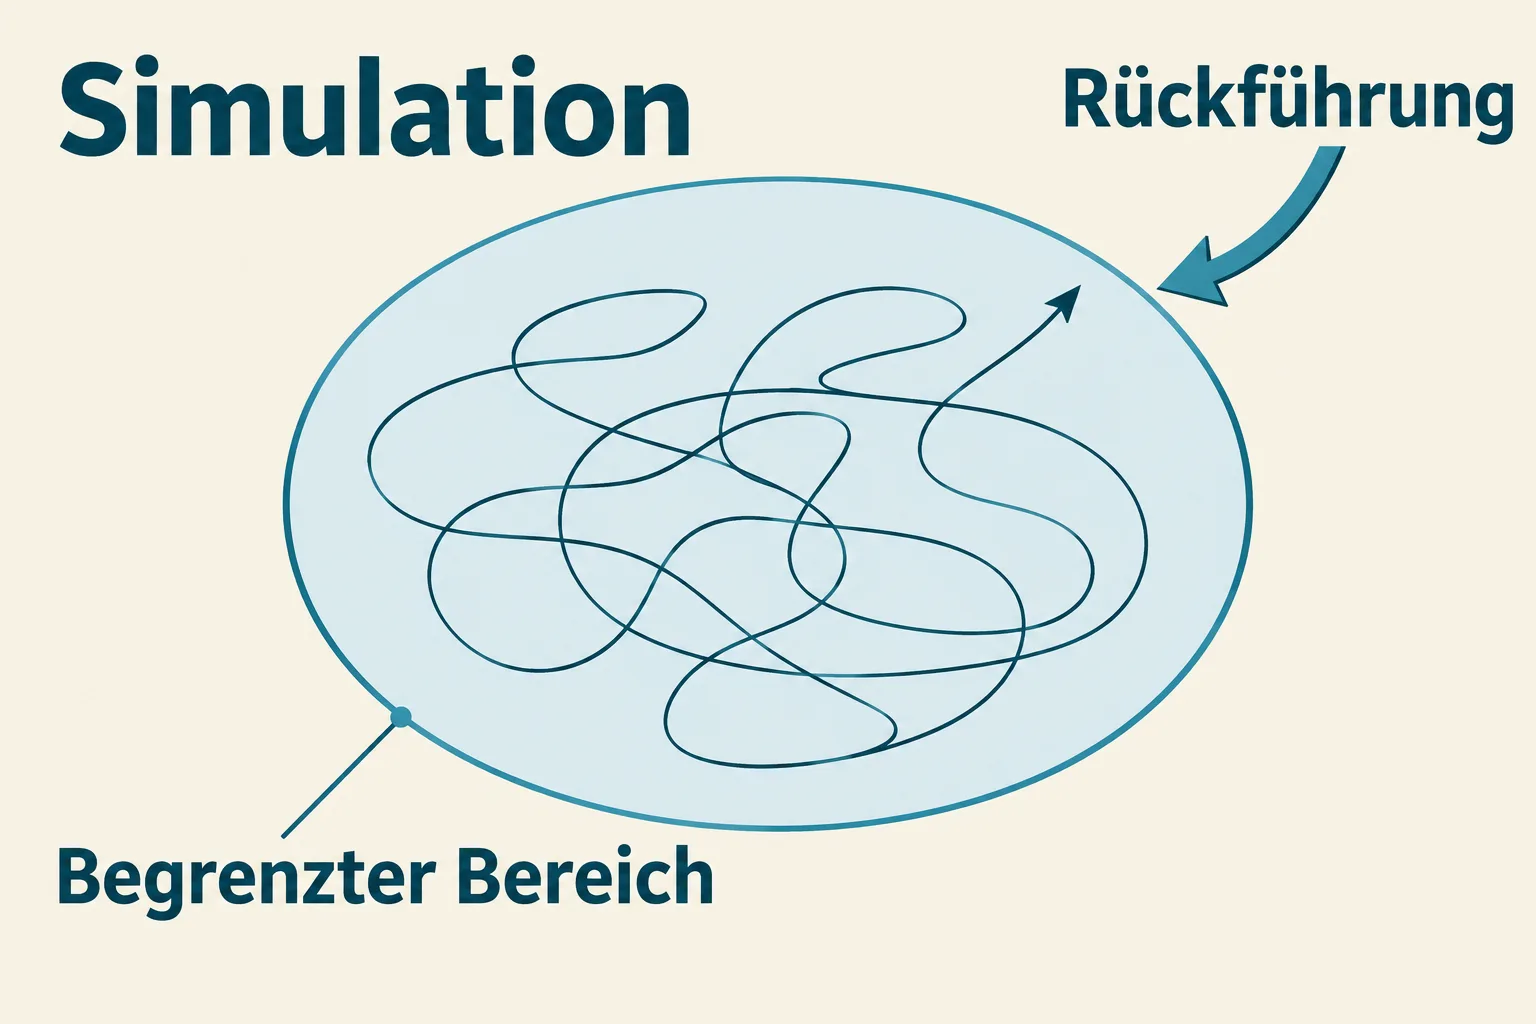
Das unterscheidet eine feste Bedingung von einer bloßen Trainingsstrafe. Bei einer Strafe wird ein Verstoß während des Lernens unattraktiver gemacht. Das allein garantiert laut MIT nicht, dass das fertige Modell bei neuen Eingaben die Regel immer einhält. Die zusätzliche Schicht des Teams ist dagegen so konstruiert, dass die Beschränktheit aus dem Aufbau folgt.
Was die Versuche tatsächlich zeigen
Die Forschenden prüften den Rahmen an mehreren dynamischen Systemen, darunter Lorenz 96 und einer vereinfachten Fassung einer Gleichung für komplexe Strömungsmuster. Solche Modelle sind nützliche Testumgebungen, weil sie chaotisches Verhalten zeigen und dennoch überschaubarer sind als die gesamte Erdatmosphäre. In den untersuchten Fällen erzeugte das Verfahren laut Studienzusammenfassung begrenzte lange Verläufe und bewahrte dabei statistische Eigenschaften der Systeme.
Diese Statistik beantwortet eine andere Frage als die exakte Wettervorhersage für einen bestimmten Tag. Statt jeden späteren Zustand punktgenau zu treffen, lässt sich etwa untersuchen, welche Zustände ein System über längere Zeit wie häufig annimmt. Wenn ein Modell unbeschränkt davonläuft, wird eine solche Auswertung wertlos. Ein begrenzter Verlauf schafft erst die Voraussetzung, seine Langzeitstatistik sinnvoll zu beurteilen.
Das Umgekehrte gilt allerdings nicht automatisch: Eine Kurve kann innerhalb einer Grenze bleiben und trotzdem die falschen Zustände zu oft erzeugen. Beschränktheit ist eine überprüfbare Eigenschaft, keine allgemeine Garantie für korrekte Ergebnisse. Ob die gelernten Muster zu Beobachtungen und zur jeweiligen Fragestellung passen, muss weiterhin gesondert untersucht werden.
Ein anderer Weg verbindet Physik und Lernen
Dass physikalisches Vorwissen und lernende Komponenten zusammenarbeiten können, zeigt ein unabhängiges Projekt aus dem Jahr 2024. NeuralGCM von Google Research und dem europäischen Wetterzentrum ECMWF verbindet ein physikbasiertes Atmosphärenmodell mit maschinellem Lernen. Die physikalische Komponente beschreibt großräumige Bewegungen; gelernte Teile helfen bei Prozessen, die auf der gewählten Modellauflösung nicht vollständig aufgelöst werden.
Das Team untersuchte sowohl Wettervorhersagen als auch längerfristige Simulationen vergangener atmosphärischer Bedingungen. Google betonte zugleich, dass NeuralGCM damals noch kein vollständiges Klimamodell war. Die Ergebnisse betreffen also konkrete Tests und machen aus dem System keine fertige Antwort auf jede Klimafrage.
Die beiden Arbeiten lösen außerdem nicht dasselbe Problem auf dieselbe Weise. NeuralGCM kombiniert bewährte Modellbausteine mit gelernten Komponenten. Der MIT-Ansatz ergänzt lernende Dynamik um eine mathematische Bedingung für begrenzte Verläufe. Ein direkter Leistungsvergleich zwischen ihnen liegt aus diesen Quellen nicht vor.
Der nächste Schritt ist größer als die Leitplanke
Gerade der Unterschied erklärt, weshalb eine gute Vorhersage für den nächsten Schritt und ein stabiler langer Lauf getrennt geprüft werden müssen. Ein kurzfristig überzeugendes Modell kann später entgleisen. Ein stabiles Modell kann umgekehrt dauerhaft eine verzerrte Verteilung liefern. Für Klimafragen zählen deshalb sowohl die physikalische Plausibilität als auch die Übereinstimmung der relevanten Muster mit Daten und geeigneten Vergleichsmodellen.
Das MIT-Team will den Ansatz nach eigenen Angaben an größeren und realistischeren Wettersystemen weiter untersuchen. Bis dahin ist die wichtigste Einsicht keine fertige Klimaprognose, sondern ein Bauprinzip: Lernen aus Daten gewinnt an Aussagekraft, wenn ein Modell zugleich Eigenschaften einhält, die für das untersuchte System notwendig sind. Welche zusätzlichen Bedingungen und Tests für eine konkrete Anwendung nötig sind, bleibt Teil der Forschung.
Quellen
- Tang, Sapsis und Azizan: Learning dissipative chaotic dynamics with boundedness guarantees, PNAS, 12. Oktober 2026 (Zusammenfassung eingesehen).
- MIT: New approach enables physically consistent AI models of chaotic systems, 20. November 2026.
- Google Research: Fast, accurate climate modeling with NeuralGCM, 22. Juli 2024.
Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft.