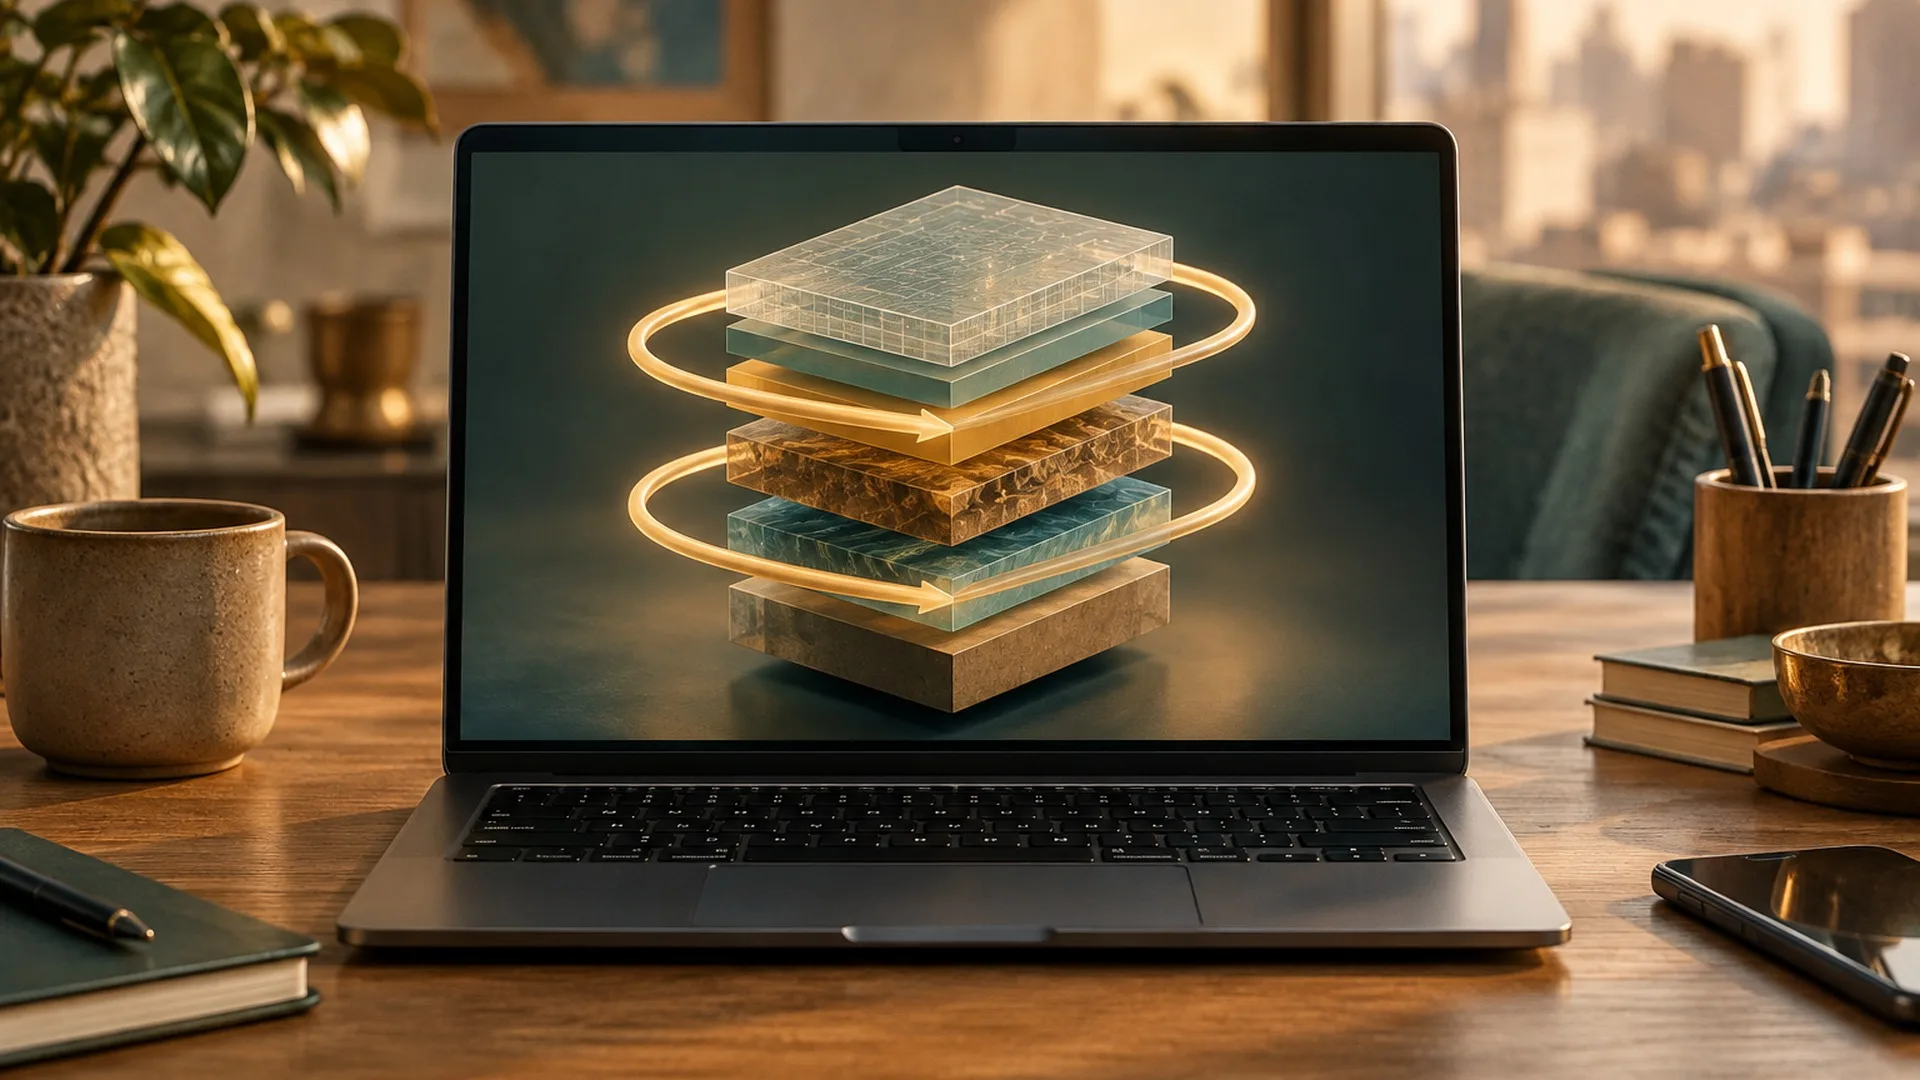
Ein KI-Modell muss nicht für jeden zusätzlichen Rechenschritt neue Schichten speichern. Thinking Machines Lab lässt bei seinem neuen Inkling 2 Mini einen Teil des Modells mehrfach arbeiten: Dieselben mittleren Schichten werden für jedes verarbeitete Token dreimal durchlaufen. Das soll zusätzliche Berechnung ermöglichen, während die dafür genutzten Gewichte nur einmal abgelegt werden.
Das Unternehmen hat das Modell am 20. November mit offenen Gewichten veröffentlicht. Es verarbeitet Text und Bilder als Eingabe und erzeugt Text. Laut Vorstellung des Herstellers umfasst die gespeicherte Modellfassung rund 20 Gigabyte. Das macht einen lokalen Betrieb auf entsprechend ausgestatteten Rechnern möglich. Wie viel Speicher der Rechner insgesamt braucht, ist damit aber noch nicht gesagt.
Ein Block arbeitet dreimal
Sprachmodelle zerlegen Text in kleine Einheiten, sogenannte Token. Bei der Verarbeitung laufen diese durch aufeinanderfolgende Schichten eines neuronalen Netzes. Jede Schicht verändert die interne Darstellung, mit der die nächste weiterarbeitet. Die dabei verwendeten Gewichte sind Zahlen, die das Modell beim Training gelernt hat.
Inkling 2 Mini besitzt nach Angaben des Entwicklers 24 gespeicherte Schichten. Die ersten sechs werden einmal ausgeführt, die mittleren zwölf dreimal und die letzten sechs wieder einmal. Das ergibt 48 Schichtanwendungen pro Token. Die mittleren zwölf existieren dabei nicht dreifach als getrennte Gewichtssätze: Das Modell verwendet dieselben Gewichte bei jedem Durchlauf erneut.
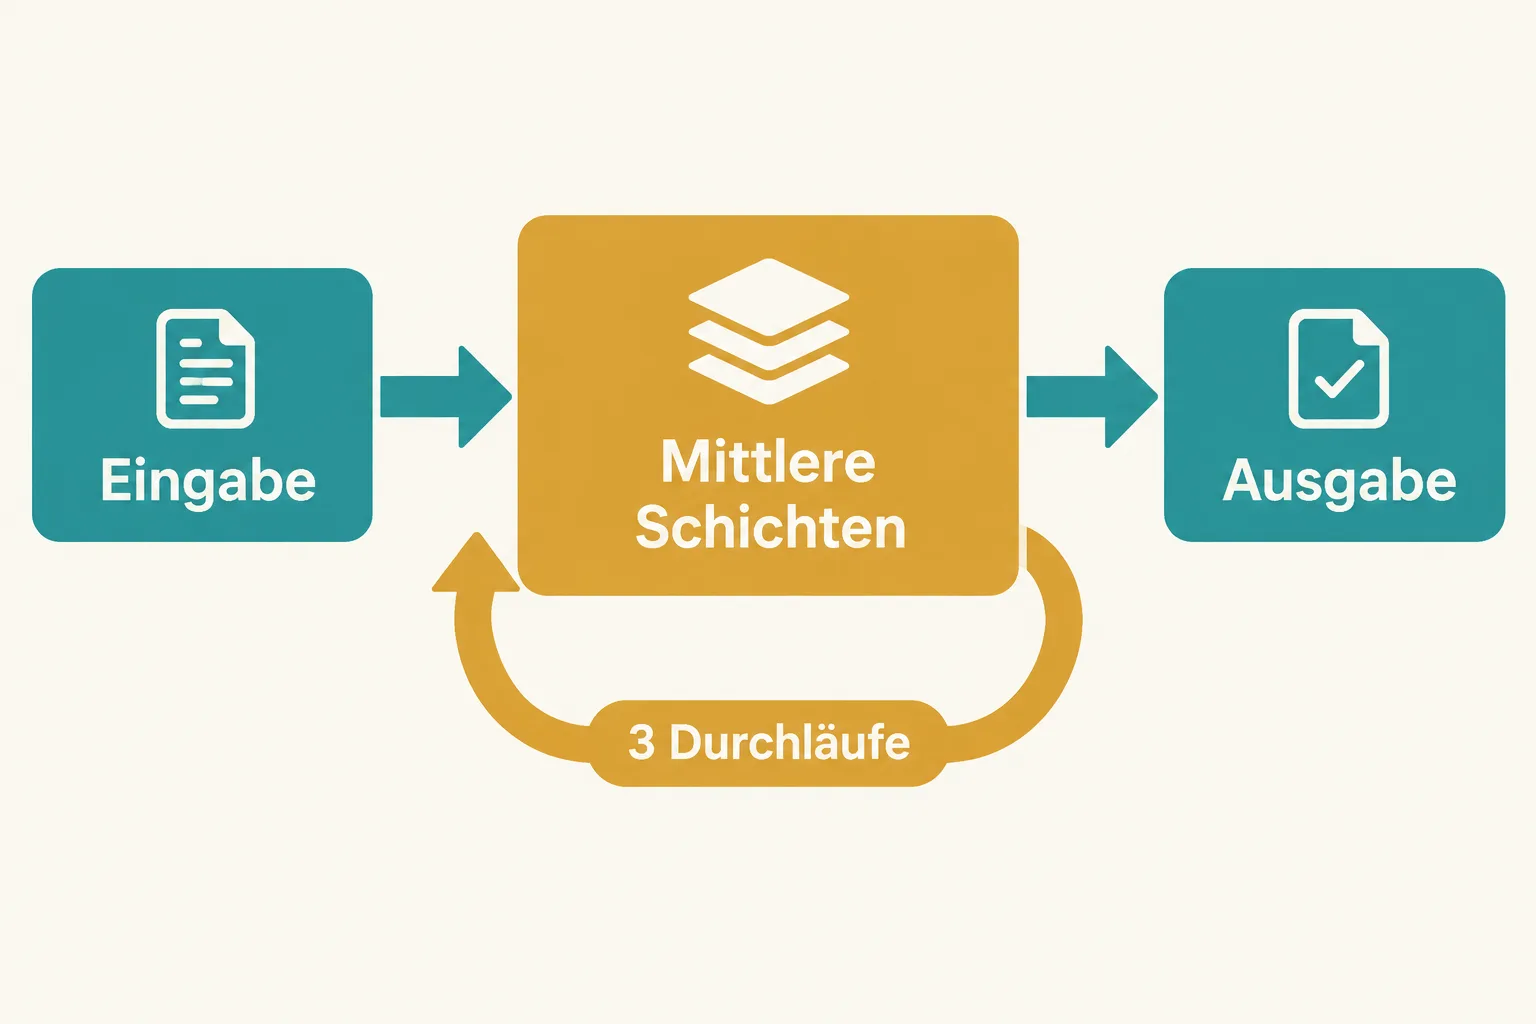
Man kann sich das wie eine Werkbank vorstellen, an der ein Werkstück mehrmals bearbeitet wird. Die Werkzeuge müssen nicht für jeden Durchgang erneut im Raum stehen. Kostenlos ist der zusätzliche Durchgang trotzdem nicht: Die Werkbank wird länger beansprucht. Ebenso benötigt das Modell für die wiederholten Anwendungen zusätzliche Rechenarbeit.
Die Idee wiederholter Schichten ist keine Erfindung dieses Modells. Bereits die Forschungsarbeit zu Universal Transformers untersuchte wiederkehrende Verarbeitung in Transformer-Netzen. Inkling 2 Mini setzt sie in einer konkreten Architektur ein. Ob das Modell damit bei einer bestimmten Aufgabe besser abschneidet, hängt von Aufgabe und Vergleich ab.
Was die Parameterzahlen bedeuten
Der Hersteller nennt insgesamt 26,4 Milliarden Parameter. Das Modell verwendet eine Architektur namens Mixture of Experts: Bei einem Verarbeitungsschritt wird nur ein Teil spezialisierter Komponenten ausgewählt. Deshalb sind nach der Modellkarte 3,4 Milliarden Parameter aktiv. Diese Zahl beschreibt aber nicht einfach den benötigten Speicherplatz.
Denn die Gewichte der anderen Experten gehören weiterhin zum Modell und müssen für ihre mögliche Verwendung verfügbar sein. Außerdem werden die mittleren Schichten wiederholt ausgeführt. Zählt man diese wiederholten Anwendungen mit, spricht die Modellkarte von 5,4 Milliarden effektiven Parameteraktivierungen pro Token. Gesamtzahl, aktive Parameter und Rechenarbeit beantworten also unterschiedliche Fragen.
Für den Speicher spielt zusätzlich eine Rolle, wie genau die Zahlen abgelegt werden. Thinking Machines verwendet beim veröffentlichten Modell überwiegend ein platzsparendes Zahlenformat mit wenigen Bits. Der Hersteller beziffert die Modellfassung auf etwa 20 Gigabyte. Für den Betrieb kommen je nach Software und Aufgabe weitere Anforderungen hinzu; die Dateigröße ist keine Mindestangabe für den gesamten Rechner.
Was für den lokalen Einsatz nötig ist
Die Modellkarte nennt Apple-Silicon-Geräte mit mindestens 32 Gigabyte gemeinsamem Speicher. Für andere Grafikprozessoren empfiehlt sie mindestens 32 Gigabyte Videospeicher; außerdem führt sie eine unterstützte NVIDIA-DGX-Spark-Konfiguration auf. Die Geschwindigkeit hängt laut Hersteller von Hardware und Laufzeitsoftware ab. Das Modell passt damit nicht automatisch auf jeden Laptop.
Die Gewichte sind auf Hugging Face unter Apache 2.0 ausgewiesen. Entwickler können sie herunterladen und mit unterstützter Software einsetzen. Ein lokaler Einsatz kann auch ohne laufende Verbindung funktionieren, wenn die benötigten Dateien und Programme bereits vorhanden sind. Die Demonstration des Herstellers zeigt das Modell auf einem MacBook Pro mit 48 Gigabyte Speicher im Flugmodus.
Mehr Rechenschritte lösen nicht jedes Problem
Thinking Machines berichtet eigene Ergebnisse für Programmier- und andere Aufgaben. Die Vergleichsbedingungen unterscheiden sich allerdings zwischen Modellen und Tests; aus einzelnen Herstellerwerten lässt sich keine allgemeine Rangfolge für jeden Einsatz ableiten. Bei längeren Gesprächen und Anweisungen mit vielen Bedingungen nennt das Unternehmen selbst Schwächen.
Auch die Risikobeschreibung weist auf mögliche falsche Aussagen und unzuverlässige Werkzeugnutzung hin. Bei Programmieraufgaben könne das Modell wiederholt seine Arbeit prüfen, ohne voranzukommen. Wer es mit Dateien oder Werkzeugen verbindet, sollte daher Ausgaben und Handlungsspielraum kontrollieren. Die Schleife beschreibt, wie das Modell rechnet; sie garantiert nicht, dass seine Antwort stimmt.
Quellen
- Thinking Machines Lab: Introducing Inkling 2 Mini, 20. November 2026
- Thinking Machines Lab: Inkling 2 Mini, Modellkarte und Gewichte
- Thinking Machines Lab: Inkling 2 Mini Model Card
- Dehghani und andere: Universal Transformers, 2018
Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft.