OpenAI will verhindern, dass fremde Entwickler die Fähigkeiten seiner KI-Modelle ohne Erlaubnis auf eigene Systeme übertragen. Das Unternehmen beschreibt dazu mehrere Schutzschichten: Sie sollen verborgene Zwischenschritte einer KI abschirmen und koordinierte Abfragen vieler Konten erkennen. In einem internen Test gelang es Angreifern nach Angaben von OpenAI deutlich seltener, solche Denkspuren aus einem neueren Modell auszulesen. Der Vergleich betrifft allerdings unterschiedliche Modelle und Schutzstände.
Der am 20. November veröffentlichte Bericht von OpenAI dreht sich um eine Technik namens Destillation. Sie kann helfen, ein kleineres KI-Modell mit den Antworten eines leistungsfähigeren zu trainieren. Das Verfahren ist für sich genommen ein normales Werkzeug der KI-Entwicklung. OpenAI befasst sich mit Fällen, in denen Ausgaben ohne Erlaubnis gesammelt und zum Training eines anderen Modells verwendet werden.
Wie ein Modell vom anderen lernen kann
Das erste System übernimmt dabei die Rolle eines Lehrers: Es beantwortet viele Aufgaben. Die Antworten werden zu Beispielen, mit denen ein zweites Modell, der Schüler, trainiert wird. Der Schüler erhält dadurch nicht einfach eine vollständige Kopie des Lehrers. Er lernt aus dem Material, das ihm vorliegt, und kann dessen Fähigkeiten in unterschiedlichem Umfang nachbilden.
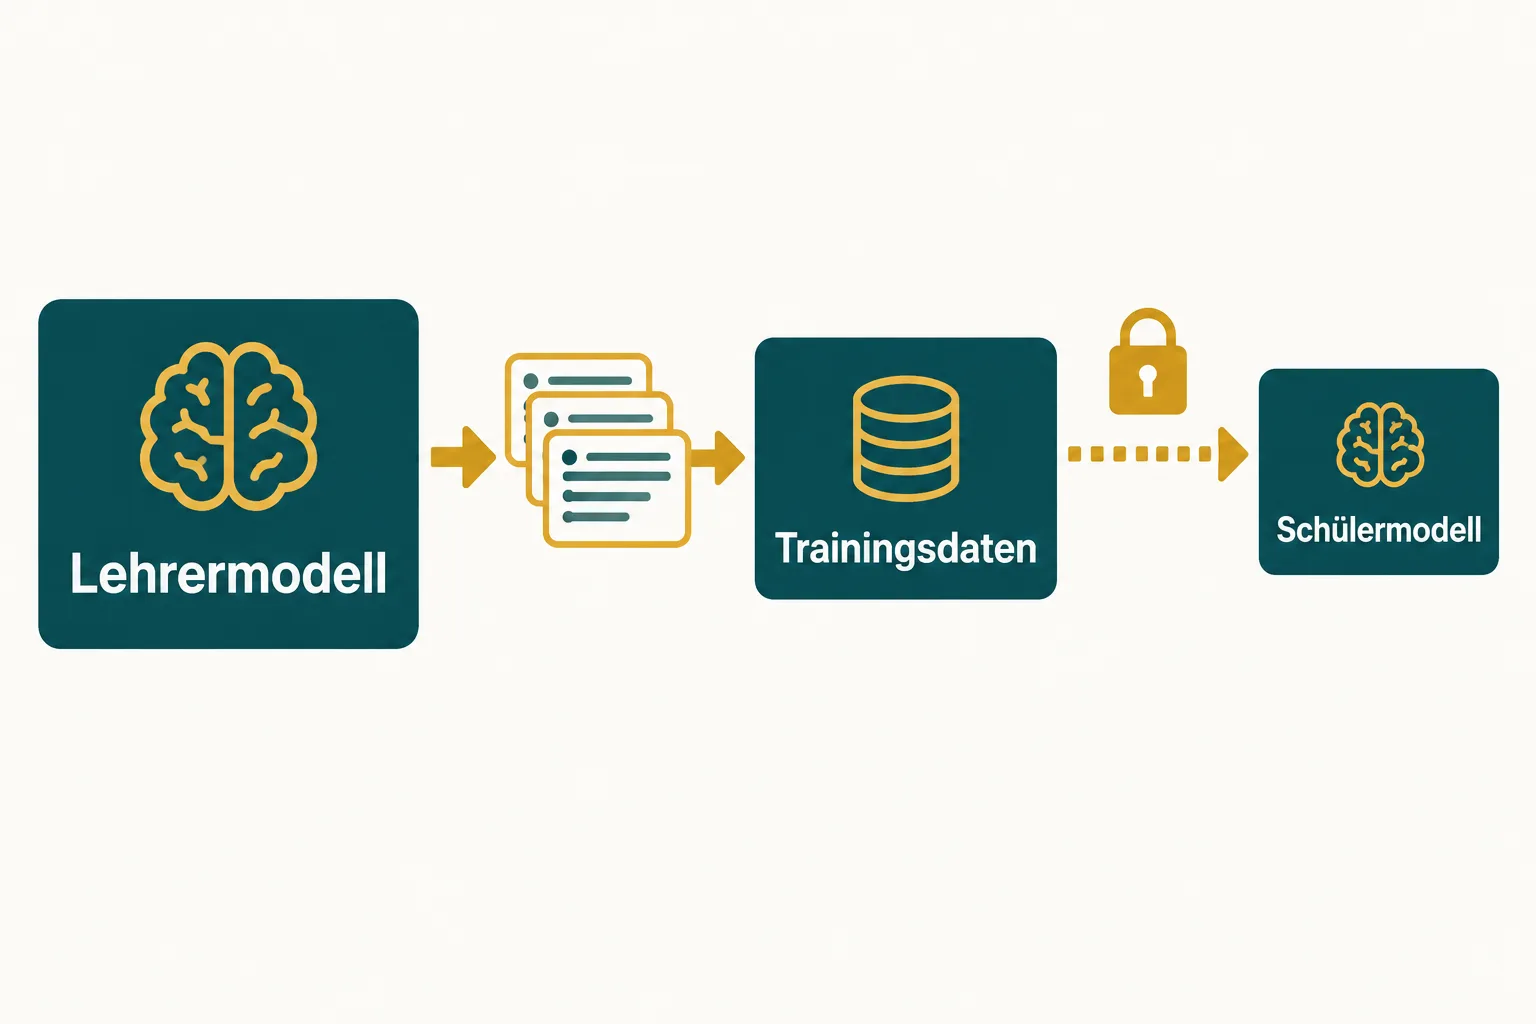
Besonders wertvoll können ausführliche Zwischenschritte sein, die ein Modell beim Bearbeiten einer Aufgabe erzeugt. Sie enthalten unter Umständen Informationen, die in der abschließenden Antwort nicht erscheinen. OpenAI bezeichnet diese geschützten Zwischenschritte als Denkspuren. Das Unternehmen befürchtet, dass ein damit trainiertes Modell Fähigkeiten übernimmt, ohne die Schutzvorkehrungen des ursprünglichen Dienstes zu behalten.
Als Beispiel nennt OpenAI die Computersicherheit. Ein System kann bei der Suche nach Schwachstellen helfen; ähnliche Fähigkeiten könnten aber auch missbraucht werden. Ob und wie stark solche Fähigkeiten übertragen werden, hängt von den Trainingsdaten und dem verwendeten Schülermodell ab. OpenAI berichtet über eigene Versuche, in denen Modelle mit vollständigen Denkspuren oder kürzeren Zusammenfassungen trainiert und anschließend geprüft wurden. Die Ergebnisse unterschieden sich je nach Test und verfügbarer Rechenzeit.
Mehrere Kontrollen greifen ineinander
OpenAI beschreibt Schutz auf zwei Ebenen. Bei einzelnen Anfragen soll das Modell lernen, Versuche zur Offenlegung geschützter Denkspuren abzulehnen. Zusätzliche Klassifikatoren prüfen Eingaben und Ausgaben, also Programme, die Muster erkennen und verdächtige Inhalte markieren. Auch Argumente an Werkzeuge werden laut OpenAI berücksichtigt: Eine Information könnte schließlich nicht nur in der sichtbaren Antwort, sondern auch in einem Werkzeugaufruf auftauchen.
Auf API-Ebene schränkt das Unternehmen ein, wie geschützte Denkspuren zwischen Gesprächen und Modellfamilien wiederverwendet werden können. Bei GPT-6.2 Astra und GPT-6.2 Sol seien sie an den Gesprächsverlauf gebunden, der sie erzeugt hat. Wird eine frühere Nachricht geändert, verwirft die Schnittstelle nach Unternehmensangaben die danach entstandene geschützte Denkspur.
Daneben untersucht OpenAI Muster über einzelne Konten hinweg. Das soll koordinierte Kampagnen sichtbar machen, die aus vielen Anfragen Trainingsmaterial gewinnen wollen. Das Unternehmen berichtet von wöchentlichen Maßnahmen gegen Tausende bis Zehntausende Konten. Wie viele Versuche unentdeckt bleiben, geht aus dieser Zahl nicht hervor.
Was die Testzahlen zeigen
In einem adaptiven internen Black-Box-Test ließ OpenAI automatisierte Angreifer versuchen, geschützte Denkspuren aus einer früheren Anfrage zu gewinnen. Die durchschnittliche Erfolgsrate sank nach Unternehmensangaben von 54,0 Prozent bei GPT-6 Astra mit ursprünglichen Schutzmaßnahmen auf 0,2 Prozent bei GPT-6.2 Astra mit aktualisierten Schutzmaßnahmen. Für Denkspuren aus der aktuellen Anfrage nennt OpenAI 22,9 beziehungsweise 0,9 Prozent.
Der Vergleich zeigt ein Ergebnis unter den beschriebenen Testbedingungen, keine allgemeine Wahrscheinlichkeit für einen erfolgreichen Angriff im Alltag. Da sowohl das Modell als auch die Schutzmaßnahmen wechseln, lässt sich aus den Zahlen allein nicht bestimmen, welcher Teil der Veränderung auf welche Maßnahme entfällt. Eine unabhängige Bestätigung dieser konkreten Werte liefert der Bericht nicht.
Dass verborgene Denkspuren ein eigenes Sicherheitsproblem darstellen, wird auch außerhalb des Unternehmens untersucht. Der Konkurrent Anthropic beschreibt ebenfalls Angriffe auf verborgene Zwischenschritte und eigene Abwehrmaßnahmen. Eine Forschungsarbeit untersucht die Rekonstruktion solcher Spuren; sie prüft allerdings nicht die neuen OpenAI-Zahlen. Beide Hinweise zeigen, warum der Schutz Gegenstand laufender Forschung ist, ersetzen aber keinen unabhängigen Test des neuen Systems.
Quellen
- OpenAI: Combatting adversarial distillation, 20. November 2026
- Anthropic: Strengthening our defenses against distillation attacks, 12. Oktober 2026
- Hidden Thoughts Are Not Secret: Reasoning Trace Exposure in LLMs, Preprint
Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft.