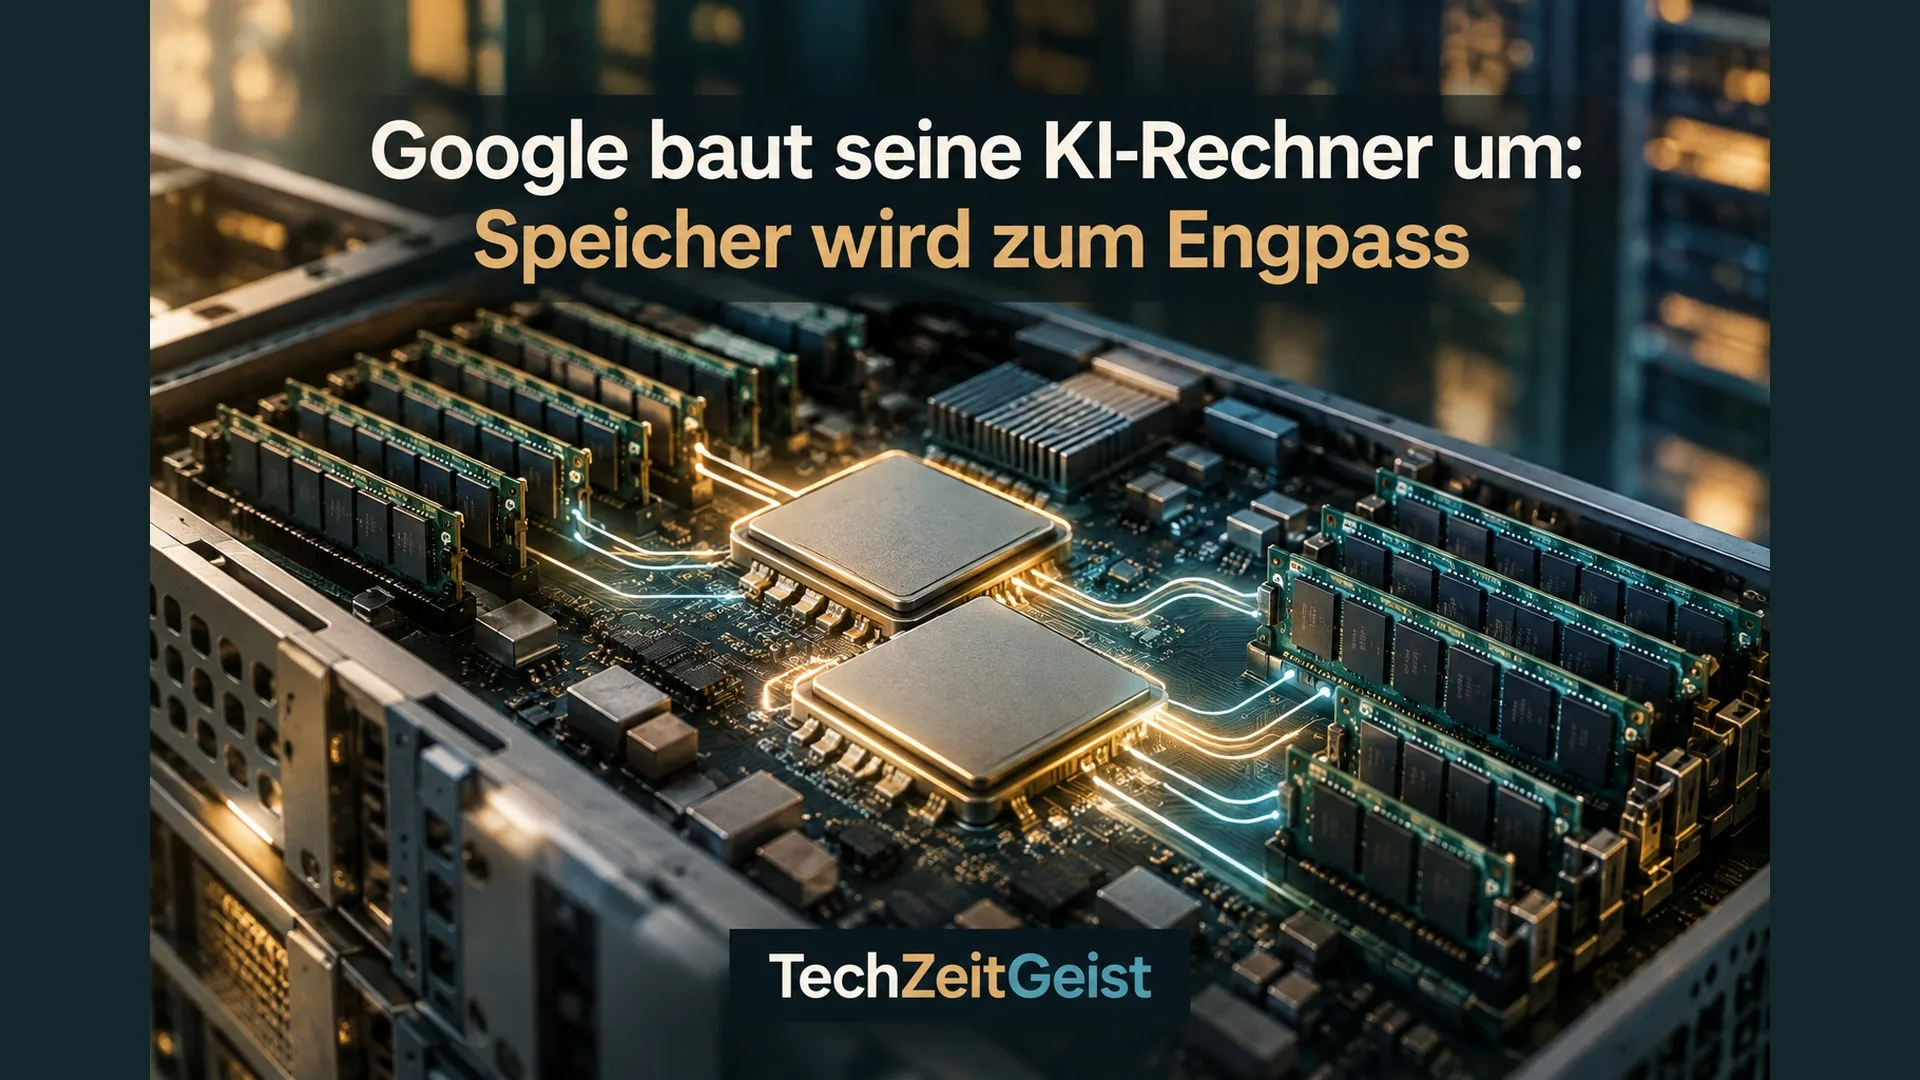
Google erweitert seine KI-Rechner um zwei Systeme, die unterschiedliche Engpässe angehen. Die am 9. November angekündigte TPU 8tx soll sensible Daten auch während der Verarbeitung schützen. Die TPU 8i Max richtet sich dagegen an große Arbeitszusammenhänge, bei denen viel Information schnell zum Rechenkern gelangen muss. Der gemeinsame Gedanke: Die Leistungsfähigkeit einer KI hängt auch davon ab, wie Speicher und Verbindungen um den Chip herum organisiert sind.
Zwei neue Systeme aus vorhandenen Bausteinen
Eine TPU ist ein auf KI-Berechnungen ausgelegter Beschleuniger. Laut Google nutzt die 8tx dasselbe Silizium wie die TPU 8t und kombiniert es mit AMD-EPYC-Prozessoren sowie einer auf kurze Verzögerungen ausgelegten Vernetzung. Der Schutz soll Daten und Modellparameter auch im laufenden Betrieb umfassen. Das ist eine andere Aufgabe als das Verschlüsseln einer gespeicherten Datei.
Für die 8i Max kombiniert Google zwei 8i-Chips in einem gemeinsamen Gehäuse, einem sogenannten Package. Das Unternehmen nennt jeweils eine Verdoppelung von Rechenleistung, internem SRAM-Speicher und HBM-Speicherbandbreite gegenüber der 8i. Bandbreite bedeutet hier, wie viele Daten pro Zeit übertragen werden können. Daraus folgt keine automatische Verdoppelung der Geschwindigkeit jeder Anwendung. Welche Komponente vorher bremste, entscheidet über den Nutzen.
Warum eine KI auf Daten warten kann
Ein KI-Agent arbeitet oft über mehrere Schritte an einer Aufgabe. Er liest Material, nutzt Werkzeuge und greift später auf vorherigen Kontext zurück. Dabei entstehen Zwischenergebnisse, die für folgende Berechnungen benötigt werden. Ein Teil davon wird in einem sogenannten KV-Cache abgelegt. Dieser Zwischenspeicher bewahrt bereits berechnete Informationen über den verarbeiteten Kontext.
Mit TPU Sync stellt Google dafür eine quelloffene Softwarebibliothek vor. Sie soll den schnellen Speicher am Beschleuniger, den Arbeitsspeicher des zugehörigen Rechners und weitere Speicherstufen zusammen nutzbar machen. Daten werden zwischen diesen Bereichen verschoben, während andere Berechnungen weiterlaufen können.
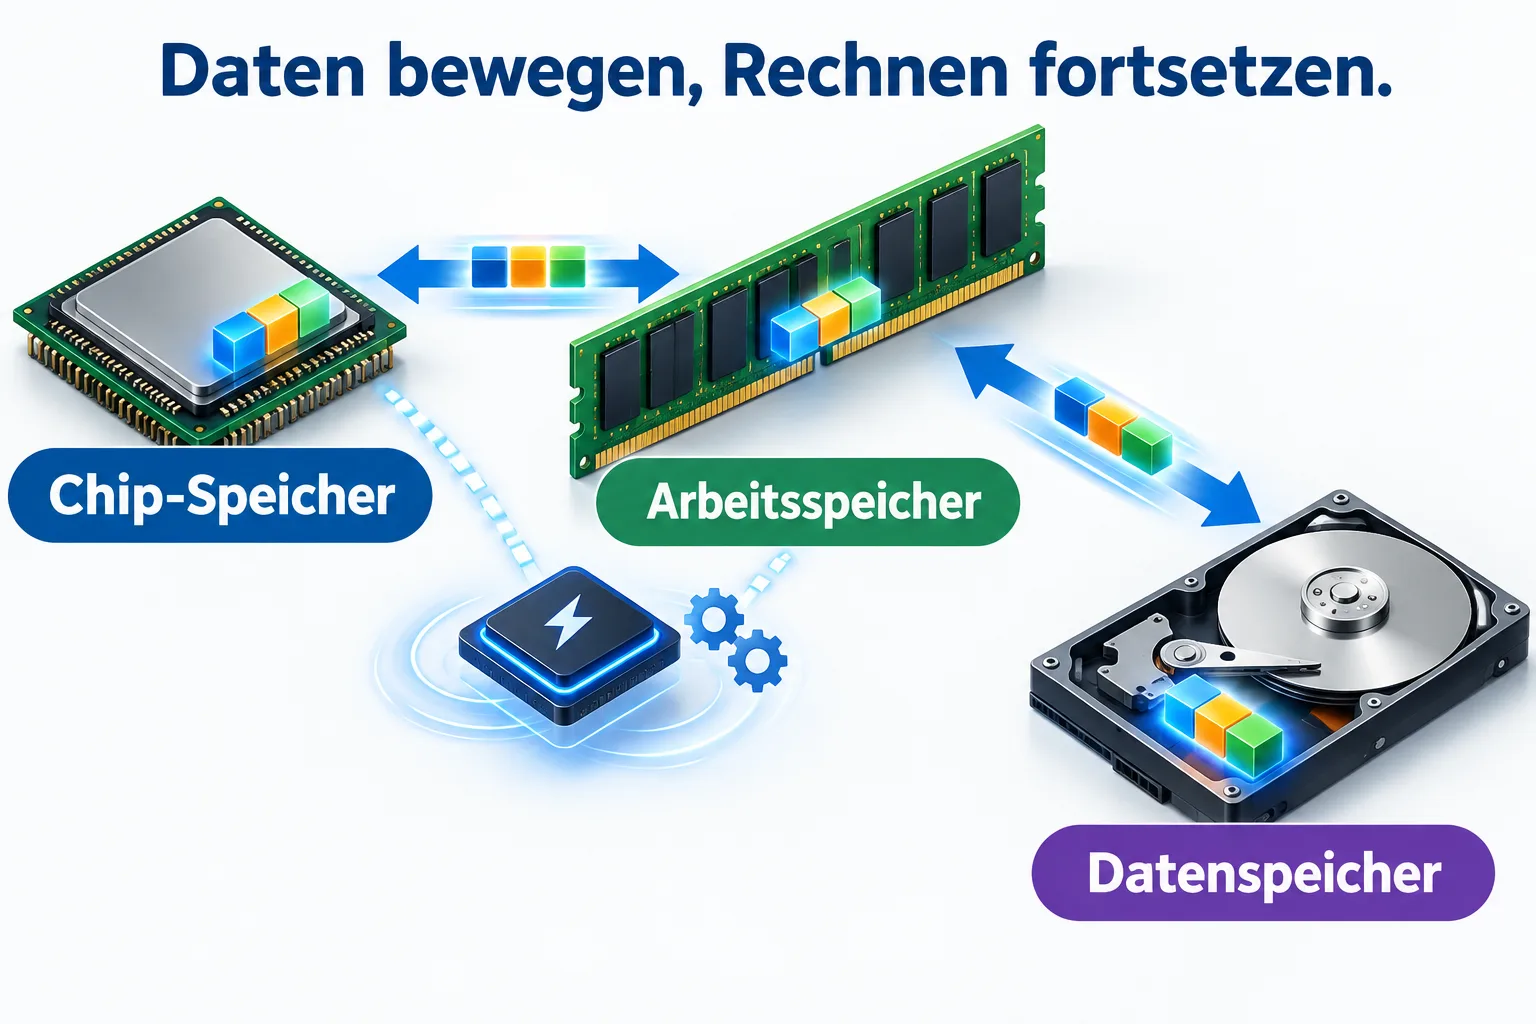
Das ist besonders dann interessant, wenn mehrere Anfragen dieselben längeren Anweisungen oder Dokumente verwenden. Bereits berechnete Teile können wiederverwendet werden, statt jedes Mal erneut durch das Modell zu laufen. Google beschreibt außerdem den Transport zwischen Rechnern, die zunächst die Eingabe verarbeiten, und Rechnern, die anschließend die Antwort Stück für Stück erzeugen. Teile für zusätzliche Speicherablagen und bestimmte Trainingsabläufe sind noch experimentell.
Auch die Größe einer Rechnergruppe wird beweglicher
Ein weiterer Teil des Ansatzes betrifft die Frage, wie viele Beschleuniger gemeinsam an einem Auftrag arbeiten. In seiner Dokumentation zu Dynamic Slicing beschreibt Google zwei Richtungen: Mehrere vorbereitete TPU-Gruppen können zu einem größeren Verbund zusammengeschaltet werden. Umgekehrt kann eine Gruppe in kleinere, voneinander getrennte Einheiten für unterschiedliche Aufgaben zerlegt werden.
Die Verbindung größerer Gruppen erfolgt über optische Schalter. Sie ändern die Verknüpfungen zwischen den Hardwareblöcken. Für das darauf laufende Programm erscheint der zusammengeschaltete Verbund als ein zusammenhängendes Netz. Beim Aufteilen können etwa mehrere Versuche oder Anpassungen eines Modells parallel auf kleineren Einheiten laufen. Die unterstützten Varianten hängen von Hardware und Softwareversion ab.
Anschaulich lässt sich der Unterschied an einem gedachten Rechenzentrum erklären: Ein großer Trainingsauftrag benötigt viele gemeinsam arbeitende Beschleuniger. Mehrere kleinere Versuche brauchen dagegen jeweils nur einen Teil davon. Eine veränderbare Aufteilung passt die vorhandenen Ressourcen an diese unterschiedlichen Aufgaben an. Sie erzeugt keine zusätzliche Hardware, kann aber deren Zuteilung verändern.
Die Ankündigungen betreffen damit verschiedene Ebenen desselben Problems: Daten müssen geschützt verarbeitet, rechtzeitig bereitgestellt und auf passend zusammengeschalteten Rechnern bearbeitet werden. Für den praktischen Nutzen reicht der Blick auf die Rechenleistung eines einzelnen Chips deshalb nicht aus.
Quellen
- Google: TPU 8tx und 8i Max, 9.11.2026
- Google: TPU Sync, 9.11.2026
- Google Cloud: Dynamic Slicing, technische Dokumentation
Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft.