Wer hat am Ende einer langen Geschichte den Schlüssel? Für Menschen klingt das nach einer einfachen Frage. Ein Sprachmodell muss dafür aber jede Übergabe im Text berücksichtigen. Ein neuer Test des Forschungsinstituts Ai2 zeigt, dass selbst leistungsfähige Modelle bei langen Ketten solcher Veränderungen den Überblick verlieren können.
Der am 3. November vorgestellte StateBench untersucht genau diese Fähigkeit: Informationen über Personen, Gegenstände oder Variablen aktuell zu halten, während sich deren Zustand verändert. Die Ergebnisse hängen dabei stark davon ab, welche Art von Veränderung verfolgt werden muss.
Vom Nachschlagen zum Mitrechnen
Ein einfaches Beispiel: Anna gibt Ben einen Schlüssel, Ben reicht ihn an Clara weiter. Wer die letzte Frage beantworten will, muss die Übergaben in der richtigen Reihenfolge verfolgen. Das Beispiel ist erfunden, veranschaulicht aber die Aufgabe: Ein früher richtiger Zustand kann später überholt sein.
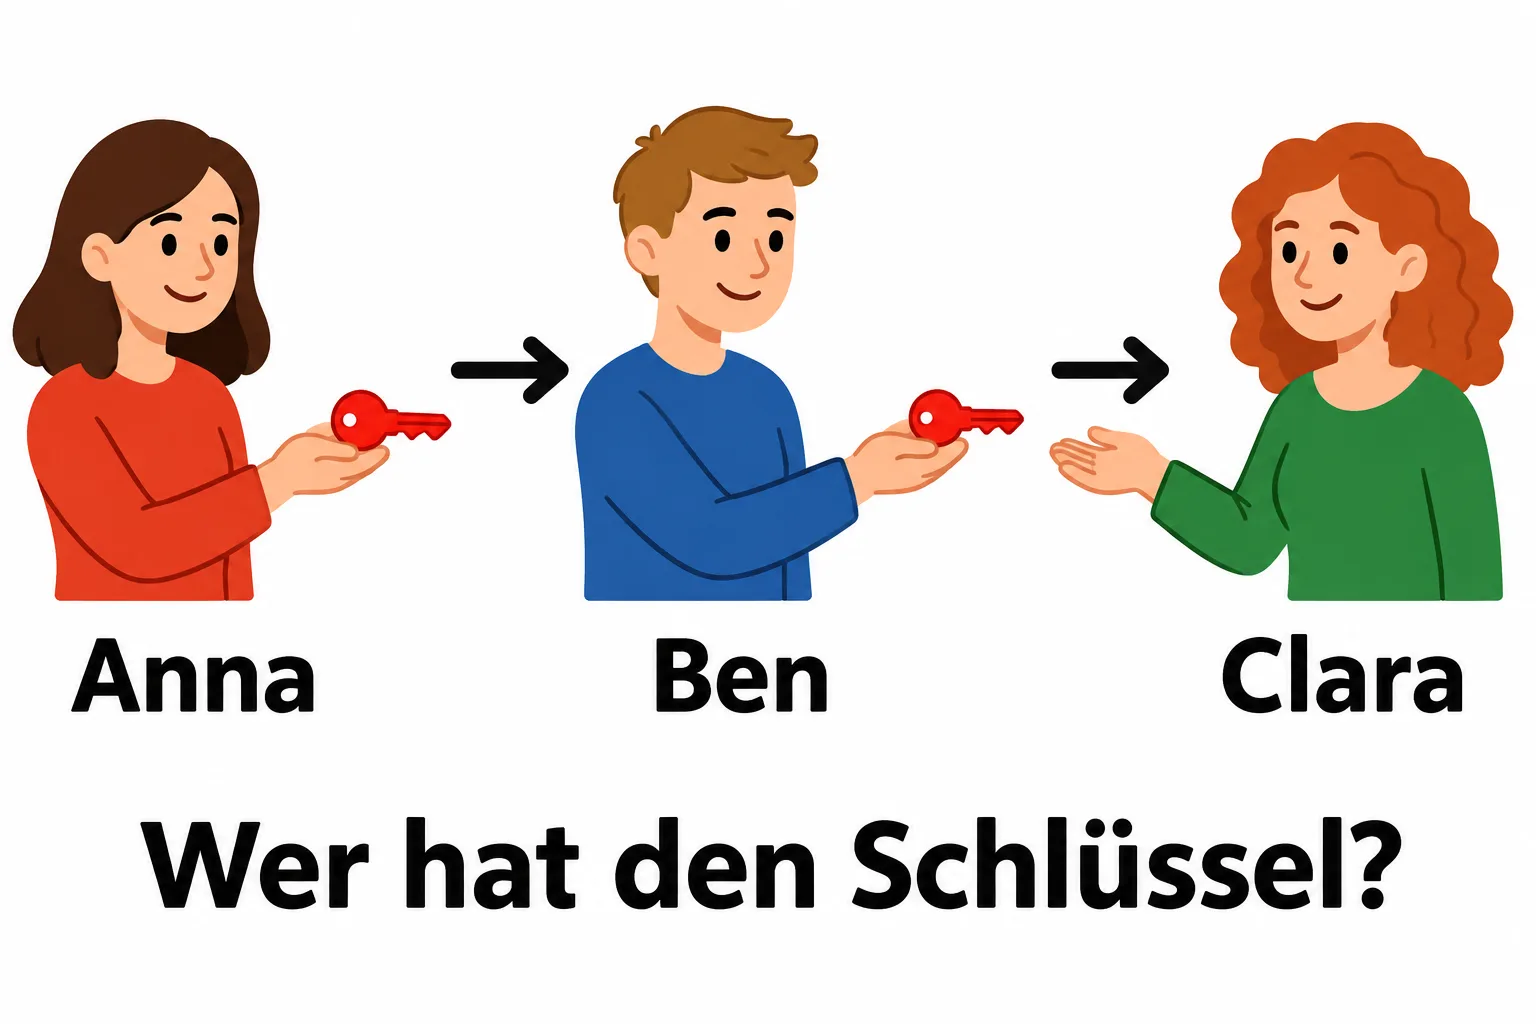
StateBench teilt solche Aufgaben in vier Stufen ein. Auf der einfachsten bleibt ein Wert unverändert: Das Modell muss ihn lediglich wiederfinden. Auf der nächsten darf ein Wert überschrieben werden. Dann zählt die jüngste gültige Angabe, etwa die zuletzt eingestellte Temperatur eines Thermostats.
Schwieriger wird es, wenn jede Änderung auf dem vorherigen Stand aufbaut. Bei einem Spielstand muss jeder hinzugefügte Punkt berücksichtigt werden. In der anspruchsvollsten Stufe hängen Werte voneinander ab: Ein Objekt kann den Besitzer wechseln, weil eine andere Person etwas weitergibt. Wer einen Schritt verpasst, kann die spätere Frage falsch beantworten, obwohl alle Informationen im Text stehen.
Wo die getesteten Modelle scheiterten
Ai2 prüfte offene vortrainierte Modelle und vier besonders leistungsfähige Systeme, darunter Gemini 3.8 Flash, Claude Opus 5.5 sowie GPT-6 Sol und Luna. Bei einfachen Aufgaben schnitten die vier gut ab. Bei längeren Folgen mit selbstbezogenen oder voneinander abhängigen Änderungen sank die Genauigkeit laut Ai2 deutlich. Bei den längsten Aufgaben der schwersten Stufe erreichten sie höchstens 13 Prozent.
Diese Zahl beschreibt die Aufgaben und Auswertung des Forschungsteams. Sie ist keine allgemeine Fehlerquote für Chatbots im Alltag. Die Forschenden ließen die Modelle den Endwert jeder Variablen aus Folgen von Zuweisungen ableiten. Mit wachsender Länge können mehr einzelne Schritte das Ergebnis beeinflussen.
Auch die Form der Aufgabe spielte eine Rolle. Bei einem kleineren offenen Modell funktionierte das Wiederfinden eines unveränderten Werts in einem Testformat fast perfekt, während dasselbe Grundproblem als Tabellenbearbeitung nahe am Zufallsniveau lag. Die Fähigkeit lässt sich also nicht allein aus einer einzigen Darstellung ablesen.
Training und Bauweise machen einen Unterschied
In einem weiteren Versuch trainierte Ai2 kleinere Modelle gezielt auf StateBench-Aufgaben. Die Trainingsfolgen umfassten höchstens 256 Zuweisungen; getestet wurde anschließend mit bis zu 64.000. Einige hybride und rekurrente Modelle lösten die einfacheren Stufen auch bei sehr viel längeren Folgen nahezu fehlerfrei. Diese Modelltypen führen Informationen über Verarbeitungsschritte hinweg in einem Zustand weiter; hybride Modelle verbinden solche Verfahren mit anderen Bausteinen.
Die untersuchten Transformer-Varianten lernten die einfacheren Aufgaben ebenfalls, verloren bei längeren Folgen aber an Genauigkeit. Die schwerste Stufe lernten sie in diesem Versuch nicht. Bei der Interpretation ist der Rahmen entscheidend: Direkt auf eine Aufgabe trainierte kleine Modelle und bereits vortrainierte große Assistenten wurden in unterschiedlichen Versuchen untersucht. Aus den Ergebnissen folgt keine pauschale Rangfolge aller KI-Systeme.
Die Forschungsarbeit ist als Preprint veröffentlicht. StateBench arbeitet mit einer festen Anzahl von Variablen. In echten Gesprächen können dagegen neue Personen oder Gegenstände auftauchen, die erst aufgenommen werden müssen. Genau diesen Fall deckt der aktuelle Rahmen noch nicht ab. Der Test macht damit eine konkrete Schwachstelle sichtbar und hilft zu unterscheiden, welche Veränderungen ein Modell zuverlässig nachverfolgen kann.
Quellen
- Ai2: StateBench, 3. November 2026
- Petty, Merrill und Sabharwal: A Fine-Grained Hierarchy and Benchmark for State Tracking in Language Models, Preprint, 2. November 2026
Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft.