Wer mit einer Software ein Gespräch in Text verwandelt, möchte nicht erst seine Aussprache an ein Programm anpassen. Ob eine Spracherkennung unterschiedliche Stimmen zuverlässig versteht, lässt sich aber nur beurteilen, wenn die Tests mehr als eine vertraute Aussprache abdecken. Eine verbreitete Vergleichsplattform ergänzt dafür nun zwei weitere englische Akzente.
Das Open ASR Leaderboard nimmt spontane Gespräche mit ägyptisch und nigerianisch geprägtem Englisch in seine private Testauswertung auf. Die Daten stammen von Liva AI, wie das Team am 6. November mitteilte. Der eine Datensatz umfasst 1,34 Stunden, der andere 1,55 Stunden. Sie sollen sichtbar machen, wie sich Spracherkennungsmodelle bei diesen Sprechweisen schlagen.
Vom Gespräch zum vergleichbaren Ergebnis
Automatische Spracherkennung wandelt eine Audioaufnahme in geschriebenen Text um. Das kann bei Untertiteln helfen oder Gesprächsnotizen vorbereiten. Für einen Test reicht es nicht, den erzeugten Text flüchtig anzusehen: Er wird mit einer Referenz verglichen, die festhält, was in der Aufnahme gesagt wurde. So lassen sich fehlende, ersetzte oder zusätzlich erkannte Wörter zählen.
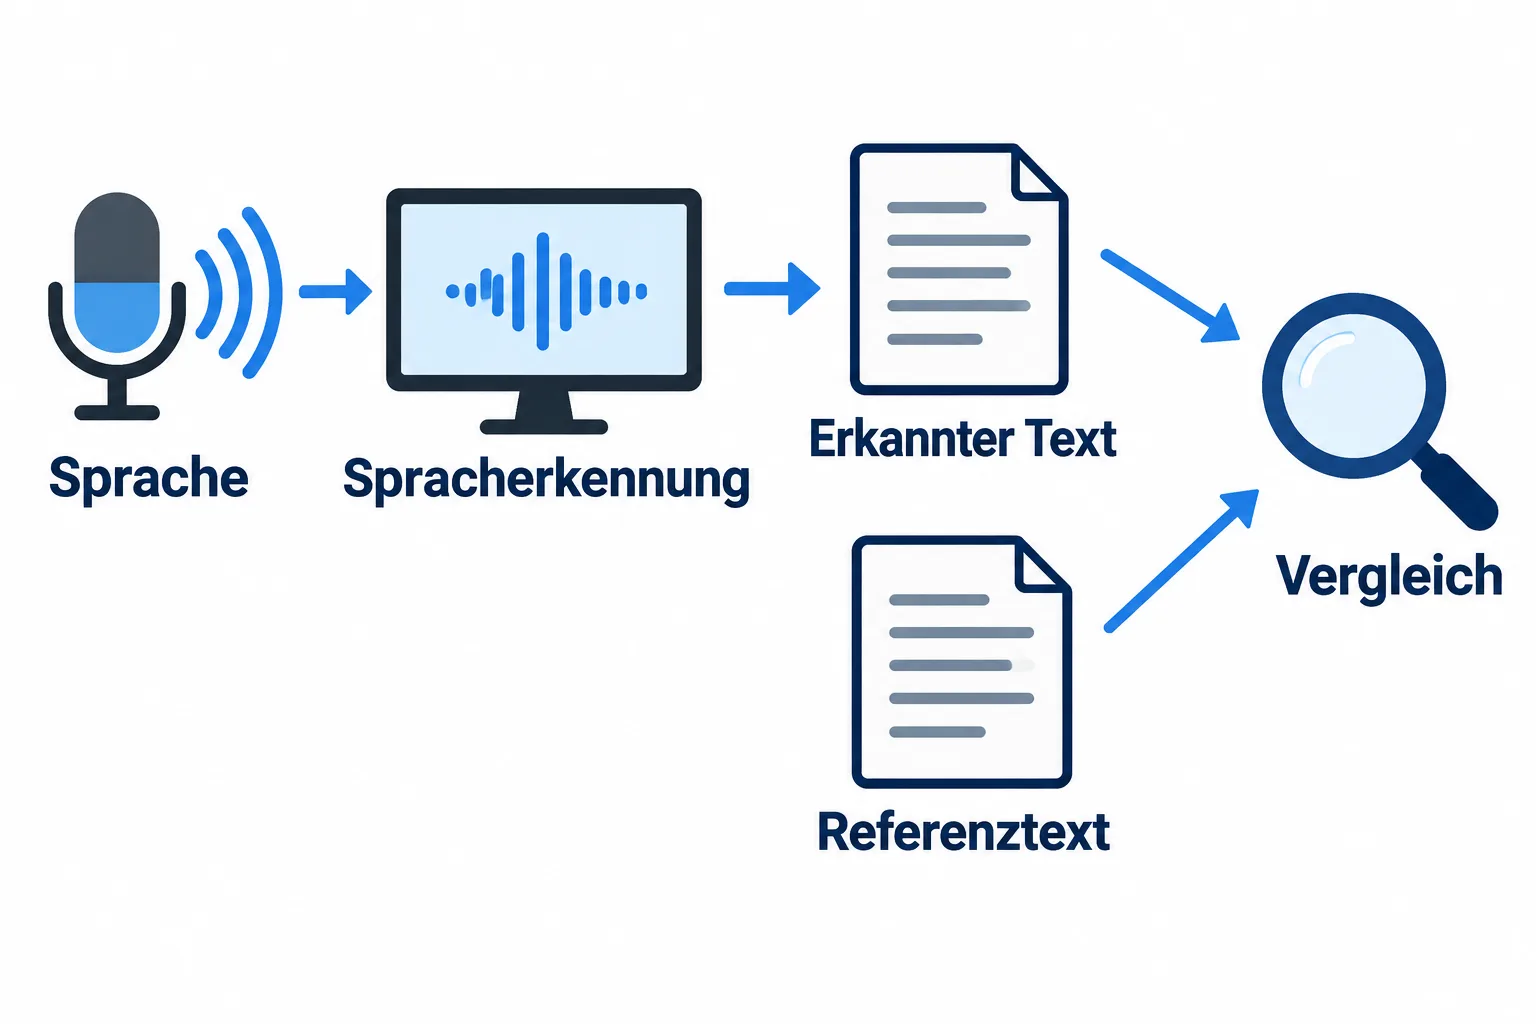
Eine gebräuchliche Kennzahl ist die Wortfehlerrate: Sie setzt solche Abweichungen ins Verhältnis zur Zahl der Wörter im Referenztext. Je niedriger sie ausfällt, desto näher liegt die Ausgabe nach diesem Maß an der Vorlage. Was in einem konkreten Gespräch missverstanden wurde, ist damit allerdings noch nicht vollständig beschrieben. Ein falsch erkanntes einzelnes Wort kann für den Sinn wichtiger sein als ein anderes.
Das Leaderboard vergleicht nach einer Beschreibung der Betreiber sowohl die Genauigkeit als auch die Verarbeitungsgeschwindigkeit. Diese beiden Eigenschaften beantworten verschiedene Fragen: Ein schnelles Modell ist nicht automatisch das genaueste, und ein guter Wert auf einem Datensatz muss nicht für jede Gesprächssituation gelten.
Warum die Aufnahmen zurückgehalten werden
Die beiden neuen Datensätze stehen im privaten Teil der Auswertung. Die Aufnahmen werden also für die Prüfung zurückgehalten, statt als frei bekannte Testbeispiele zu dienen. Der Gedanke dahinter: Wenn Entwickler die genauen Prüfungsfragen nicht kennen, können sie ihre Systeme nicht einfach auf diese Beispiele zuschneiden. Das soll einen aussagekräftigeren Vergleich unterstützen.
Laut Ankündigung handelt es sich um spontane Gespräche. Die Referenztexte enthalten neben Großschreibung und Satzzeichen auch sprachliche Unflüssigkeiten. Das ist für die Einordnung wichtig: Ein frei geführtes Gespräch verläuft anders als ein vorgelesener Satz. Menschen unterbrechen sich, setzen neu an oder verwenden Füllwörter. Der Prüftext muss festlegen, wie solche Stellen abgebildet werden, damit ein Vergleich überhaupt möglich ist.
Zu den bisherigen privaten Daten gehörten nach Angaben des Teams bereits verschiedene Akzente, darunter indisch geprägtes Englisch. Mit den Ergänzungen weist die Plattform ihre privaten Ergebnisse nun auch nach Gruppen aus, etwa US-amerikanisches gegenüber nicht US-amerikanischem Englisch. Solche Aufteilungen können Unterschiede sichtbar machen, die in einem einzigen Durchschnittswert verschwinden würden.
Was die neuen Tests aussagen können
Die Erweiterung ist zunächst eine Änderung am Messwerkzeug. Sie macht ein Modell nicht von selbst besser. Sie kann aber zeigen, wo ein bestimmtes System bei den bereitgestellten Aufnahmen häufiger vom Referenztext abweicht und wo Entwickler genauer hinsehen sollten.
Die verfügbaren Gesprächszeiten sind überschaubar. Die Ankündigung nennt für die beiden neuen Datensätze keine Sprecherzahl und belegt nicht, dass sie die Vielfalt aller Menschen aus Ägypten oder Nigeria abbilden. Ein Landesname steht hier für eine Testgruppe, nicht für eine einheitliche Art zu sprechen. Wer ein System auswählen will, sollte deshalb auch eigene Aufnahmen und die Bedingungen des geplanten Einsatzes berücksichtigen.
Der praktische Gewinn liegt in der zusätzlichen Perspektive: Ein Vergleich kann nun zwei weitere Sprechweisen ausdrücklich berücksichtigen. Wie gut ein konkretes Modell in einem bestimmten Gespräch funktioniert, zeigt erst dessen Ergebnis unter passenden Bedingungen.
Quellen
- Hugging Face: Egyptian and Nigerian English join the Open ASR Leaderboard, 6. November 2026.
- Hugging Face: Open ASR Leaderboard: Trends and Insights, 21. November 2025.
Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft.