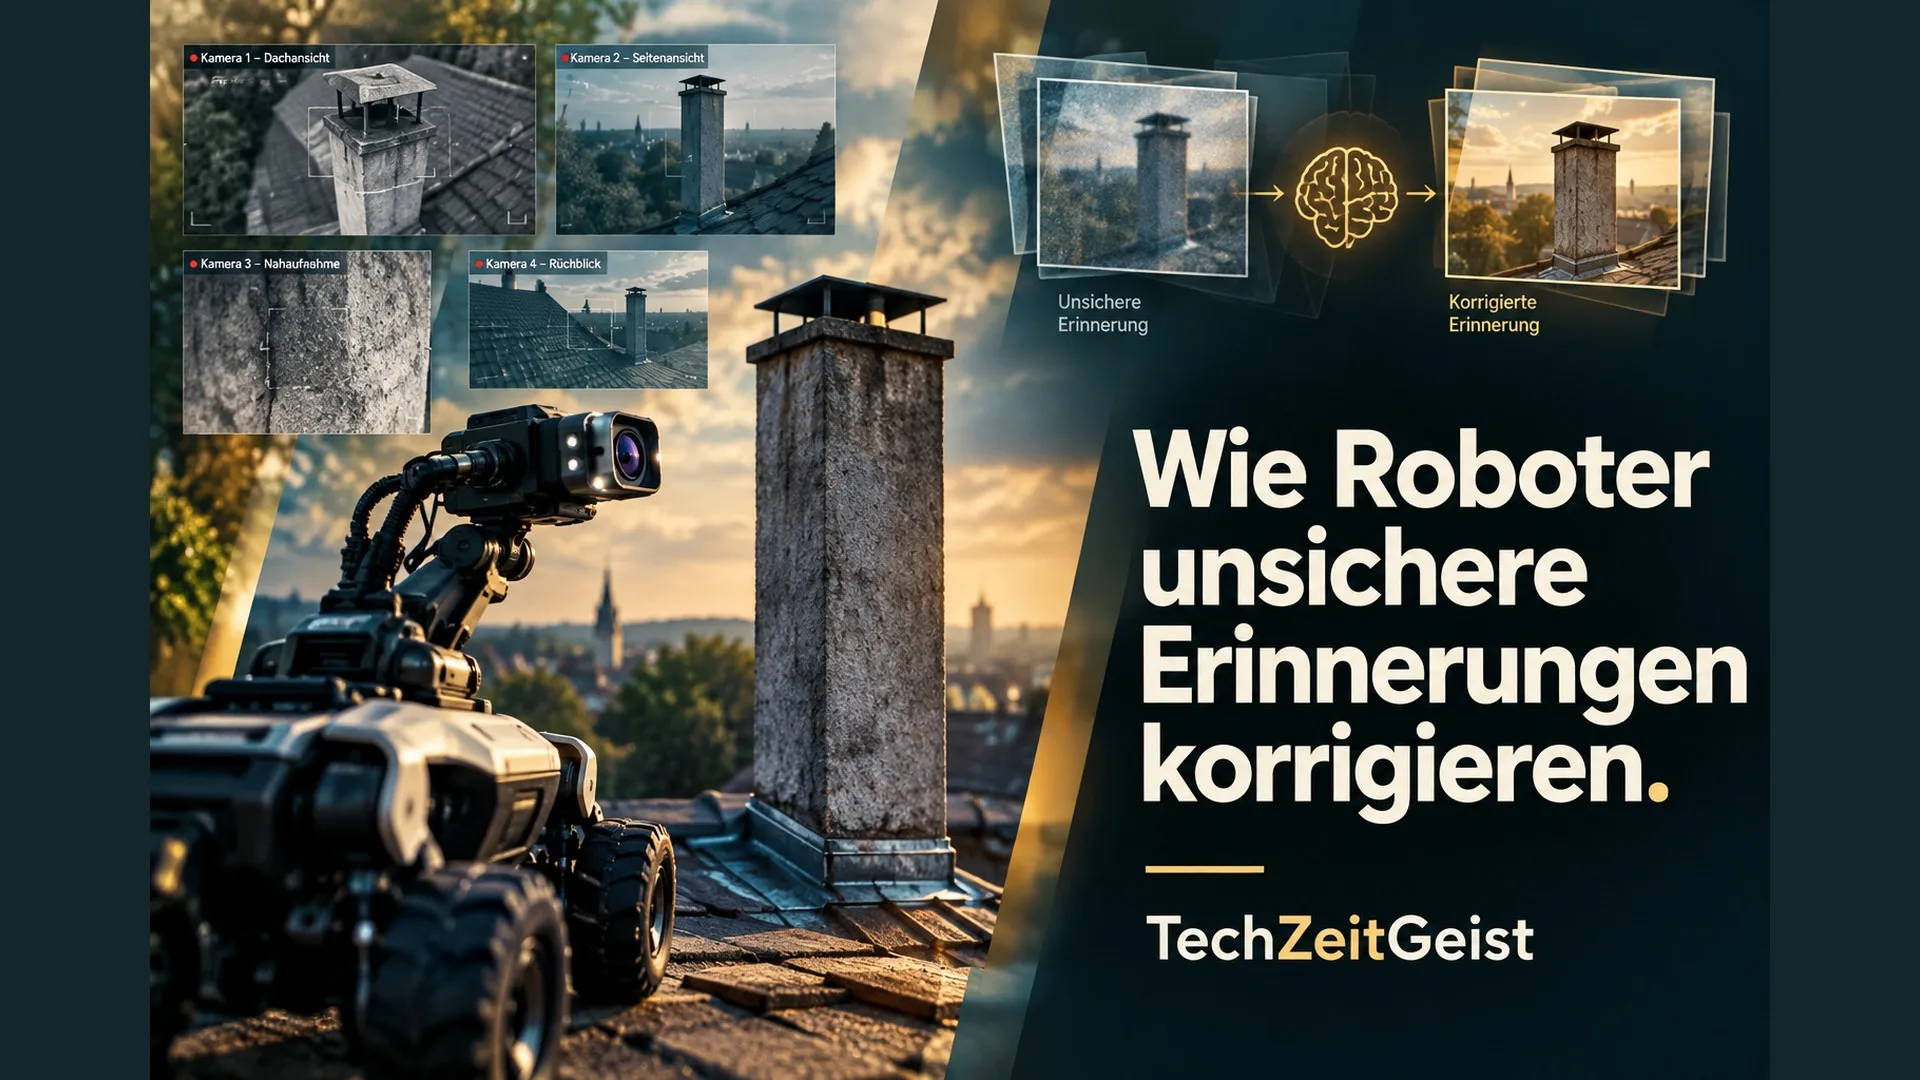
Ein Roboter sieht einen dunklen Gegenstand auf einem Dach und speichert ihn zunächst als Eichhörnchen. Später zeigen weitere Aufnahmen: Es handelt sich um einen Schornstein. Forschende des Massachusetts Institute of Technology (MIT) haben ein Verfahren entwickelt, das solche unsicheren Einträge im künstlichen Gedächtnis erkennt und mit zusätzlichen Ansichten überarbeitet.
Das System heißt UQ-DAAAM. Es vergleicht Beschreibungen desselben Gegenstands aus mehreren Blickwinkeln und sucht gezielt nach besseren Bildern. In einem Benchmark sank dadurch bei vielen zunächst unsicheren Objekten der berechnete Unsicherheitswert. Für einen späteren Einsatz von Robotern ist das interessant: Wer einen Gegenstand finden soll, braucht nicht nur eine Karte seiner Umgebung, sondern auch verlässliche Informationen darüber, was dort steht.
Eine Karte mit Beschreibungen
Die Arbeit baut auf DAAAM auf, einem System für ein räumliches und zeitliches Robotergedächtnis. Es verbindet Kamerabilder mit einer dreidimensionalen Darstellung der Umgebung. Zu erkannten Objekten legt es Beschreibungen ab, die ein Bild-Sprach-Modell erzeugt: eine KI, die Bildausschnitte in Worte fasst. Später lassen sich Fragen stellen, etwa wo ein bestimmter Gegenstand gesehen wurde.
Das Problem beginnt schon bei der ersten Aufnahme. Ein Objekt kann weit entfernt, verdeckt oder schlecht beleuchtet sein. Das Modell liefert dann unter Umständen eine überzeugend klingende, aber falsche Beschreibung. Wird sie gespeichert und nie überprüft, bleibt der Fehler Teil der Karte. Das MIT zeigt in seiner Mitteilung das Beispiel eines Schornsteins, der zunächst für ein Eichhörnchen gehalten wurde.
Was mehrere Blickwinkel verraten
UQ-DAAAM betrachtet mehrere Beschreibungen desselben Objekts. Stimmen sie in ihrer Bedeutung schlecht überein oder ist eine Beschreibung in sich unsicher, steigt ein berechneter Unsicherheitswert. Überschreitet er eine festgelegte Schwelle, kann das System weitere bereits verfügbare Ansichten auswählen. Es bevorzugt Bilder, auf denen der Gegenstand gut sichtbar und ausreichend groß ist.
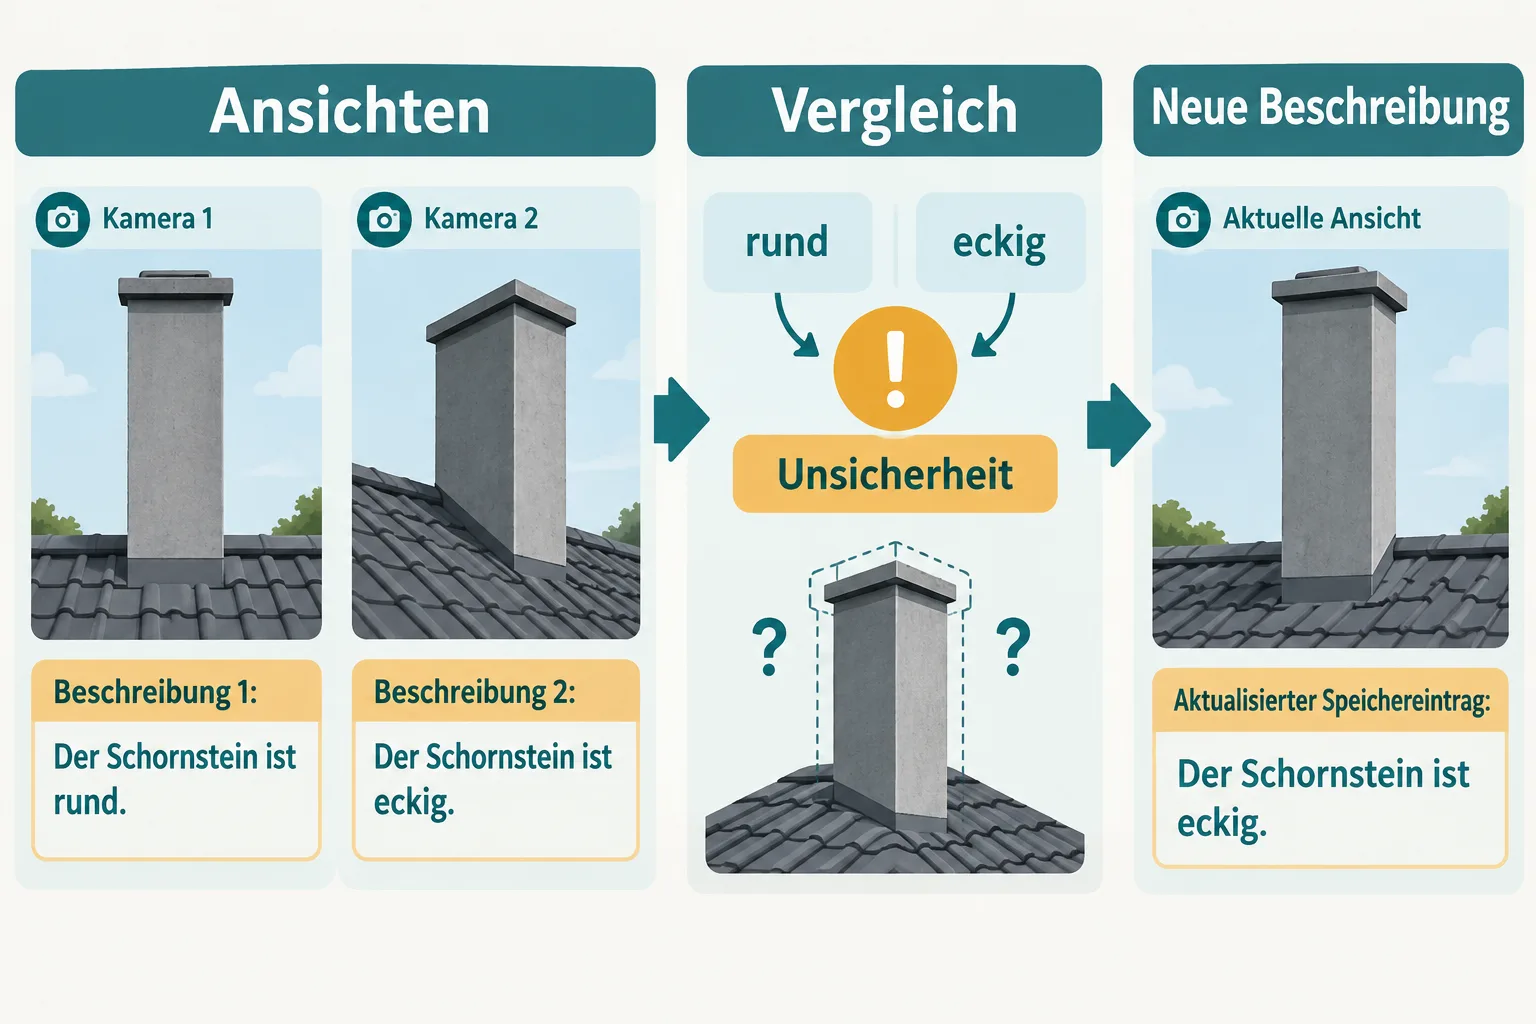
Aus den zusätzlichen Aufnahmen entstehen weitere Beschreibungen. Ein Sprachmodell führt sie zu einem Eintrag zusammen, wobei neuere und weniger mehrdeutige Hinweise stärker berücksichtigt werden. Der Roboter muss dafür nicht jedes mögliche Bild vollständig neu auswerten: Die Auswahl nutzt eine einfachere Bewertung der Bildqualität. Die mathematische Begründung dafür gilt unter bestimmten Annahmen; sie garantiert keine richtige Erkennung in jeder Situation.
Was der Test tatsächlich misst
In ihrem wissenschaftlichen Preprint prüfen die Forschenden das Verfahren mit dem Benchmark OC-NaVQA. Dabei geht es um Fragen zu beobachteten Gegenständen sowie deren Ort und Zeitpunkt. Verglichen wurden verschiedene Verfahren auf derselben Grundlage und mit einem begrenzten Budget zusätzlicher Bildabfragen.
Bei zwei zusätzlichen Ansichten fiel der Unsicherheitswert für 92,3 Prozent der anfangs als unsicher markierten Objekte unter die gesetzte Schwelle. Zum Vergleich erreichten zwei andere Verfahren in diesem Test 34,2 beziehungsweise 5,6 Prozent. Die Zahl sagt also, wie oft das interne Maß die Schwelle unterschritt. Sie bedeutet nicht, dass 92,3 Prozent aller Gegenstände richtig erkannt wurden.
Auch bei den Fragen zum gespeicherten Geschehen schnitt das neue Verfahren im untersuchten Benchmark besser ab. Das ist ein Hinweis darauf, dass die Auswahl zusätzlicher Ansichten für diese Aufgabe nützlich sein kann. Der Versuch belegt aber noch keinen zuverlässigen Einsatz eines Haushaltsroboters im Alltag.
Weniger Zweifel heißt nicht automatisch richtig
Die Forschenden nennen eine entscheidende Grenze selbst: Mehrere Bilder können dieselbe falsche Deutung nahelegen. Dann stimmen die Beschreibungen womöglich überein, obwohl sie falsch sind. Das Verfahren hängt außerdem von der Qualität des verwendeten Bild-Sprach-Modells ab. Zusätzliche Abfragen und gespeicherte Beschreibungen kosten Rechenzeit und Speicherplatz.
Die MIT-Mitteilung beschreibt eine laufende Aktualisierung während der Bewegung. In der beschriebenen Studienimplementierung erfolgt die Verfeinerung dagegen asynchron beim Beenden der Verarbeitung. Für die Praxis bleibt deshalb zu klären, wie sich das Verfahren unter engen Zeitvorgaben und auf unterschiedlichen Robotern einsetzen lässt. Als nächstes wollen die Forschenden unter anderem untersuchen, wie Roboter selbst unsichere Orte erneut aufsuchen können.
Quellen
- MIT News: Clearing up a robot’s fuzzy memory, 5. November 2026.
- Zhang, Gorlo und Carlone: Remember with Confidence: Uncertainty Quantification for Spatio-temporal Memory with Probabilistic Guarantees, Preprint.
Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft.