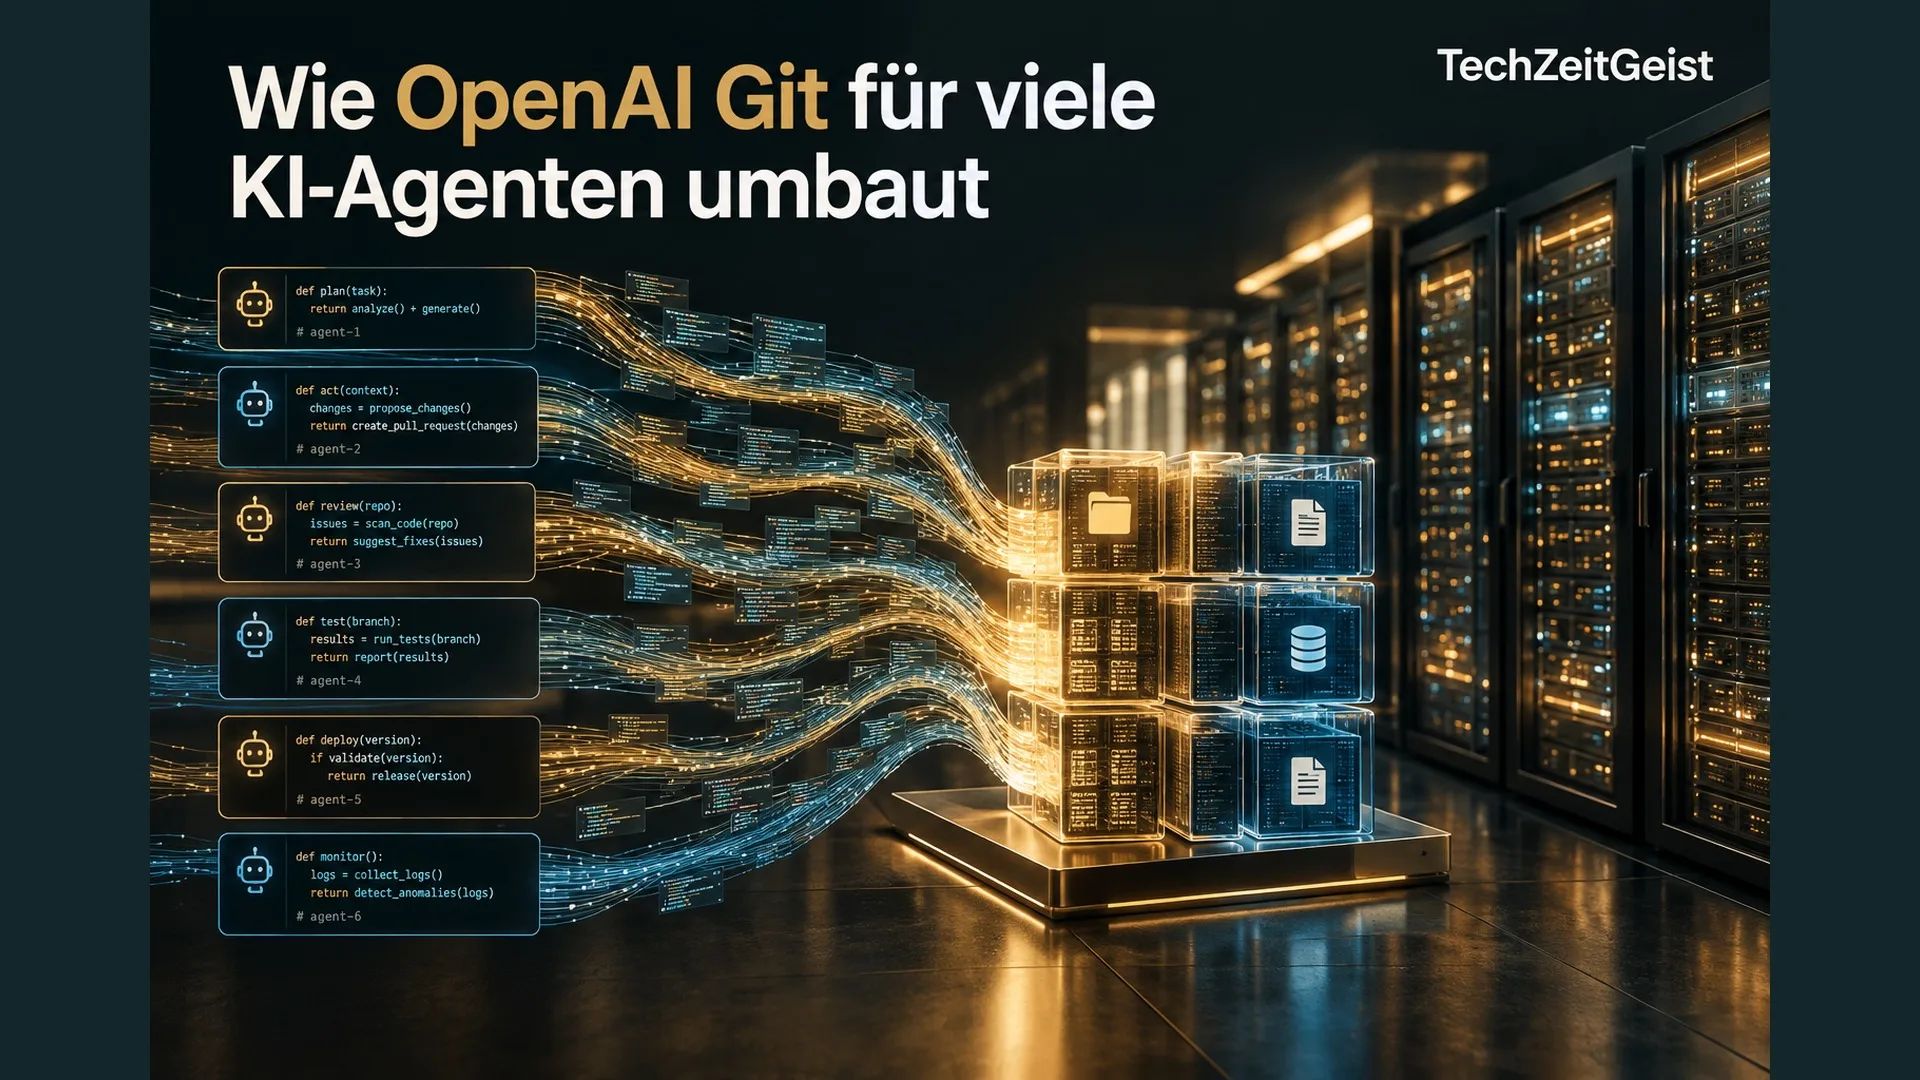
Wenn viele KI-Agenten gleichzeitig Software bearbeiten, wächst nicht nur die Zahl der Codeänderungen. Auch das System, das diese Änderungen speichert und verteilt, muss mehr Arbeit bewältigen. OpenAI hat dafür ein neues Backend namens Pando entwickelt. Es arbeitet mit dem verbreiteten Versionsverwaltungssystem Git zusammen und versorgt laut Unternehmen inzwischen die Entwicklung im eigenen zentralen Codebestand.
Das Ziel: Viele unabhängige Änderungen sollen gleichzeitig ankommen, während andere Arbeitsumgebungen dieselben Daten schnell herunterladen können. Dafür organisiert Pando Entwicklungszweige getrennt und verwendet Datenpakete mehrfach. Ein wichtiger Kompromiss betrifft die gemeinsame Sicht auf mehrere Zweige.
Warum parallele Arbeit das System belastet
Git hält fest, wie sich Dateien im Lauf eines Projekts verändern. Entwicklerinnen und Entwickler können auf getrennten Entwicklungszweigen arbeiten, bevor Änderungen zusammengeführt werden. Ein solcher Zweig verweist auf einen bestimmten Stand der gespeicherten Arbeit. Die Git-Dokumentation beschreibt ihn als beweglichen Verweis auf einen Commit, also einen gespeicherten Änderungsstand.
Ein gemeinsamer Projektbestand liegt typischerweise auch auf einem Server. Wer eine Änderung hochlädt, führt einen „Push“ aus; beim „Fetch“ holt eine Arbeitsumgebung neue Daten ab. Wenn viele Menschen und Agenten gleichzeitig arbeiten, steigen beide Arten von Zugriffen. Hinzu kommen automatisierte Prüfungen, die nach einer Änderung ebenfalls den passenden Stand benötigen.
OpenAI berichtet in seiner technischen Beschreibung vom 2. November, dass sein zentraler gemeinsamer Codebestand stark gewachsen sei. Langsame Übertragungen und fehlgeschlagene Zusammenführungen hätten gezeigt, dass die bisherige Infrastruktur mit der Last zu kämpfen hatte. Das Unternehmen wollte die gewohnte Git-Arbeitsweise erhalten und die Serverseite neu gestalten.
Getrennte Zweige und wiederverwendbare Pakete
Pando koordiniert Aktualisierungen verschiedener Zweige unabhängig voneinander. Zwei Änderungen an unterschiedlichen Zweigen müssen damit nicht allein deshalb aufeinander warten, weil sie zum selben Projektbestand gehören. Treffen dagegen gleichzeitige Änderungen auf denselben Zweig, müssen sie weiterhin miteinander abgestimmt werden.
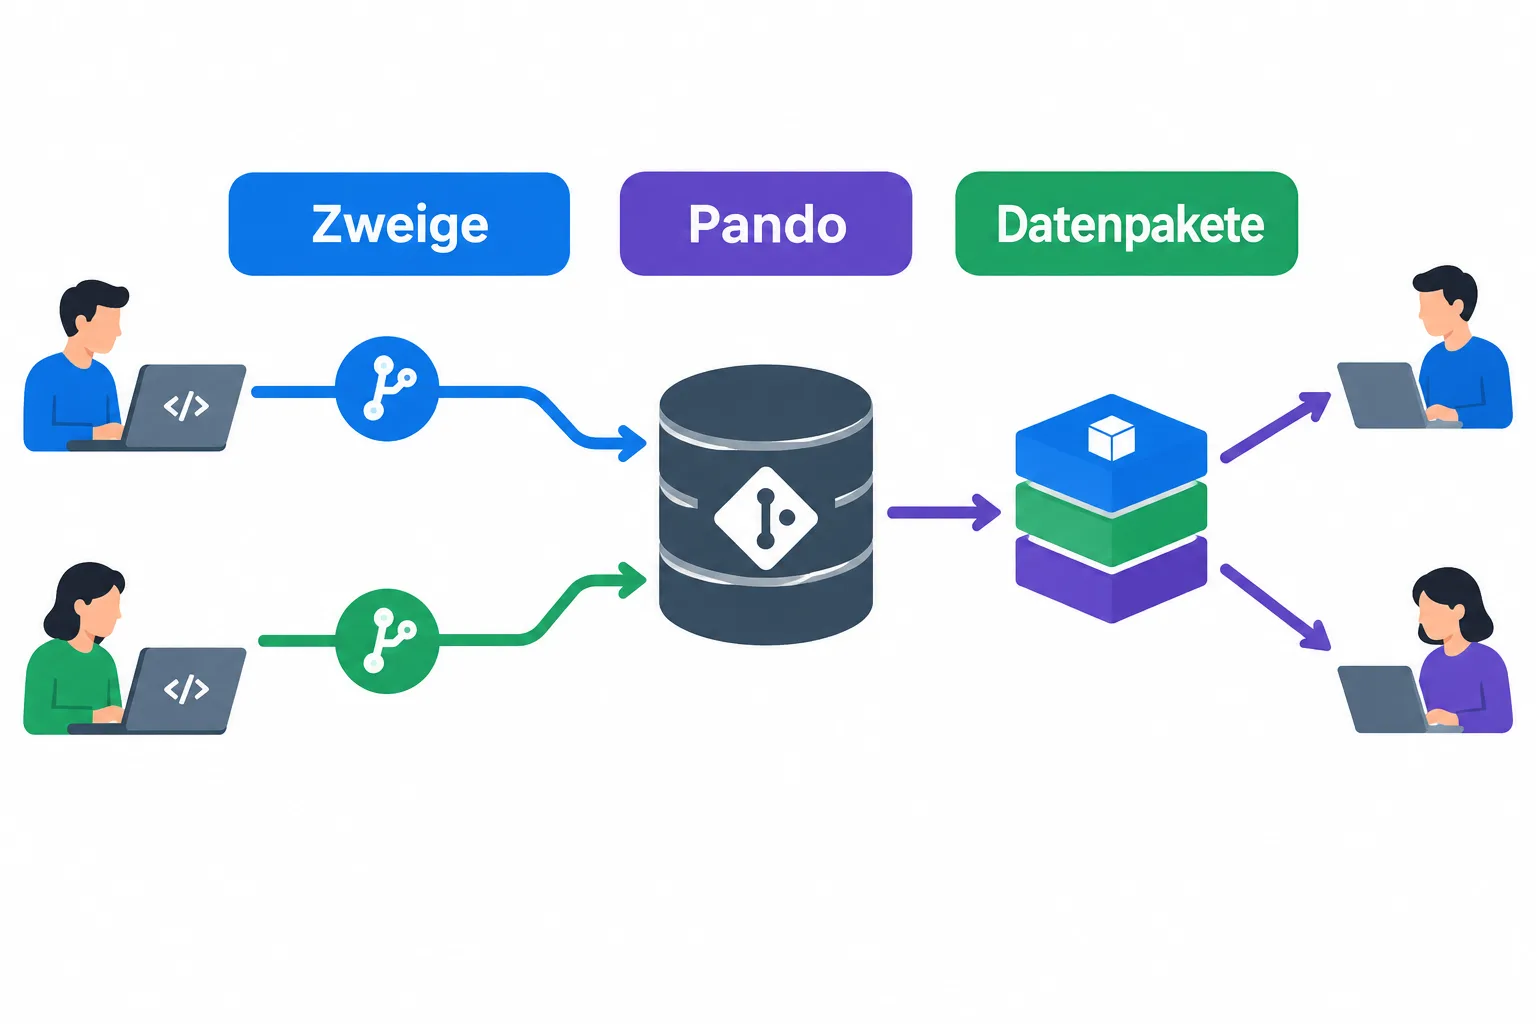
Beim Abrufen setzt das System außerdem auf bereits gespeicherte Datenpakete. Statt für jede anfragende Arbeitsumgebung alle Inhalte erneut individuell zusammenzustellen, können dieselben Pakete mehrfach ausgeliefert und zwischengespeichert werden. Das verringert die Arbeit auf der Serverseite. Als Gegenleistung kann eine Arbeitsumgebung Daten erhalten, die sie bereits besitzt.
Eine weitere Entscheidung betrifft die Daten, die beim Hochladen als gemeinsame Grundlage bekannt gegeben werden. Pando begrenzt diese Auswahl. Dadurch lassen sich Pakete leichter erneut für spätere Abrufe verwenden. Laut OpenAI können wiederholte Änderungen an einem Zweig so allerdings auch redundante Daten übertragen. Das Unternehmen bezeichnet diesen zusätzlichen Netzwerkverkehr für seinen Einsatz als vertretbaren Tausch.
Was die schnellere Verarbeitung kostet
Die getrennte Behandlung der Zweige hat eine praktische Folge: Wer mehrere Zweige betrachtet, erhält nicht unbedingt eine gemeinsame Momentaufnahme aller Zweige zum selben Zeitpunkt. Der eine kann bereits einen neueren Stand zeigen, während bei einem anderen noch ein früherer Stand sichtbar ist. Für den einzelnen Zweig werden konkurrierende Aktualisierungen dagegen weiterhin geordnet.
Dieser Unterschied ist wichtig, weil Geschwindigkeit hier aus einer bewussten Einschränkung entsteht. Das System muss nicht jede Änderung im gesamten Projektbestand in eine einzige gemeinsame Reihenfolge zwingen. Stattdessen sorgt es dafür, dass die zum Abruf eines bestimmten Stands benötigten Abhängigkeiten verfügbar sind.
OpenAI zufolge sank die typische Push-Latenz im Produktivbetrieb auf etwa ein Fünftel des früheren Werts; das Unternehmen nennt dafür den Median, also den mittleren Wert der Messreihe. Pando liefere mittlerweile fast ein Petabyte Git-Daten pro Tag aus. Beide Zahlen beschreiben OpenAIs eigene Umgebung und sind keine allgemeine Leistungszusage für andere Projekte.
Für die Beteiligten bleibt der gewohnte Git-Client erhalten. Pando ersetzt damit nicht die Versionsverwaltung selbst, sondern verändert die Infrastruktur dahinter. Das Beispiel zeigt, wie die zusätzliche Parallelität von KI-Werkzeugen auch Systeme betrifft, die Softwareteams bisher vor allem als selbstverständlich verfügbare Grundlage wahrgenommen haben.
Quellen
Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft.