Eine passende Kita finden, einen Einkauf planen oder Unterlagen für einen Behördengang ordnen: Solche Aufgaben sollen zeigen, wie hilfreich KI im Alltag sein kann. OpenAI hat dafür am 2. November den Test LifeVal vorgestellt. Er soll erfassen, wie gut die Modelle des Unternehmens bei praktischen Aufgaben helfen, für die Menschen einen persönlichen Assistenten nutzen möchten.
Die Auswahl beruht nach Angaben von OpenAI auf Studien zur Zeitverwendung und einer zusätzlichen Befragung. Das Unternehmen zeigt Beispiele mit hohen Prozentwerten. Wie diese Werte genau zustande kommen und wie sie sich auf echte Alltagssituationen übertragen lassen, bleibt in der zugänglichen Darstellung jedoch offen.
Vom Tagesablauf zur Testaufgabe
Für den Ausgangspunkt untersuchte OpenAI nach eigener Darstellung zwei Erhebungen dazu, womit Menschen ihre Zeit verbringen: den American Time Use Survey und die internationale Multinational Time Use Study. Sie liefern einen Katalog von Tätigkeiten aus unterschiedlichen Lebenssituationen. Ergänzend ließ das Unternehmen 3.995 Menschen befragen, bei welchen Aufgaben sie sich besonders Unterstützung durch einen persönlichen Assistenten wünschen.
Aus dieser Kombination entstanden Aufgaben aus Bereichen wie Betreuung, Gesundheit, Bildung, Haushaltsorganisation, persönlichen Finanzen, Einkauf und Behördendiensten. Der Gedanke dahinter: Ein Test soll nicht allein Wissen abfragen, sondern Aufgaben aufgreifen, die für Menschen einen erkennbaren Nutzen haben könnten.
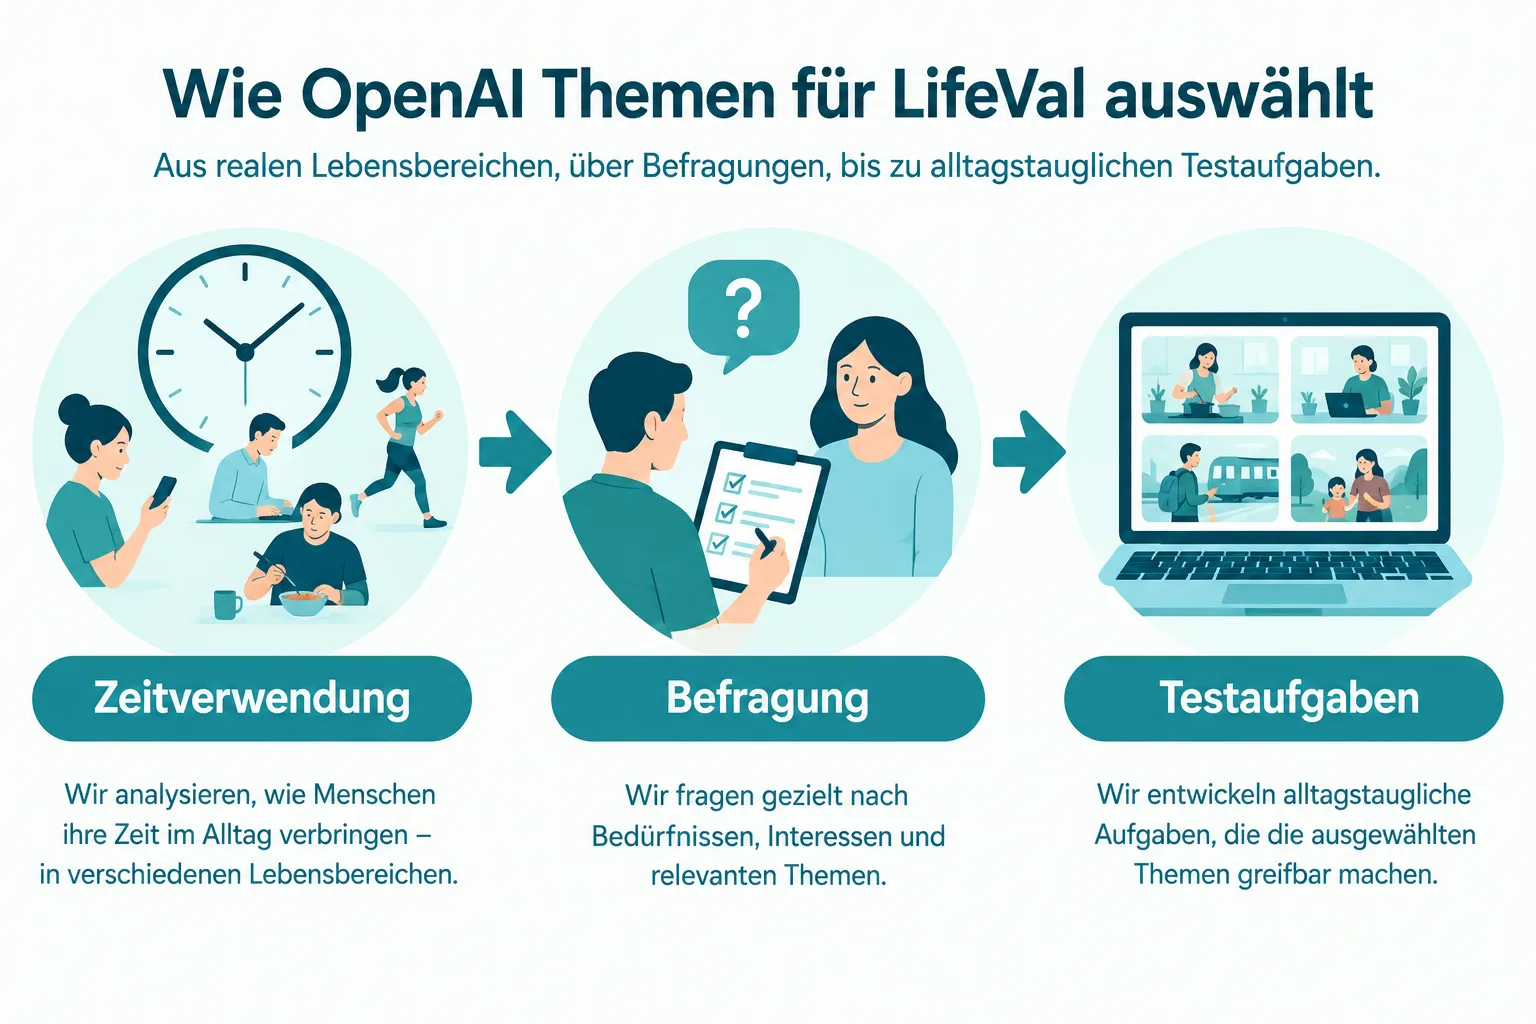
Ein Beispiel auf der LifeVal-Seite betrifft die Suche nach einer Kita nach einem Umzug. Der Assistent soll Einrichtungen vergleichen und eine Vorauswahl mit Anmeldedetails zusammenstellen. Andere Beispiele reichen von der Organisation freiwilliger Hilfe vor einem Hochwasser bis zur Planung von Mahlzeiten für einen Angehörigen mit neuer Diabetesdiagnose.
Gerade an solchen Aufgaben wird der Unterschied zwischen einer allgemeinen Antwort und einer konkreten Unterstützung sichtbar. Eine Liste mit Tipps zur Kita-Suche kann ein Gespräch beginnen. Eine brauchbare Vorauswahl müsste zusätzlich zu den Vorgaben der Familie passen und Angaben so ordnen, dass Menschen eine Entscheidung treffen können. Im dargestellten Beispiel bleiben Präferenzen zur Entscheidung durch die Nutzer offen.
Was die Prozentwerte verraten – und was nicht
OpenAI zeigt bei mehreren Beispielen Prozentwerte. Die zugängliche Seite erklärt aber nicht ausreichend, wie die Aufgaben bewertet wurden, wie viele Aufgaben der gesamte Test enthält oder wie sich die Werte unabhängig nachvollziehen lassen. Ein hoher Wert neben einem Beispiel ist daher keine belegte Wahrscheinlichkeit, mit der ein Assistent eine beliebige Kita-Suche im wirklichen Leben erfolgreich erledigt.
Für die Einordnung wäre unter anderem entscheidend, welche Informationen und Werkzeuge dem Modell zur Verfügung standen und welches Ergebnis als gelungen zählt. Eine gut formulierte Zusammenfassung, eine passende Vorauswahl und ein tatsächlich abgeschlossener Vorgang sind unterschiedliche Ergebnisse. Auch die Frage, ob Angaben aktuell und für den jeweiligen Ort zutreffend sind, gehört zur praktischen Nutzung.
OpenAI erklärt, den Test im vergangenen Jahr genutzt zu haben, um die Entwicklung seiner Modelle bei Alltagsaufgaben zu verfolgen. Das Unternehmen entwickelt zugleich die Systeme, die es damit misst. Die Beispiele zeigen somit, was OpenAI untersuchen möchte; sie sind für sich genommen kein unabhängiger Vergleich mit anderen Anbietern.
Warum lange Aufgaben schwierig zu messen sind
Ein persönlicher KI-Assistent muss für manche Aufträge mehrere Schritte verbinden: Informationen finden, Bedingungen berücksichtigen, Optionen ordnen und gegebenenfalls eine Entscheidung an den Menschen zurückgeben. Ein Fehler an einer Stelle kann die folgenden Schritte beeinflussen. Deshalb ist neben einer einzelnen Antwort auch der Weg zum Ergebnis relevant.
Wie anspruchsvoll solche Abläufe für Computertests sind, zeigt ein anderer Forschungsansatz: Die Autoren von OSWorld 2.0 untersuchen 108 längere Arbeitsabläufe aus Alltag und Beruf. Sie wollen damit Schwierigkeiten sichtbar machen, die kürzere Tests übersehen können. Die beiden Tests haben unterschiedliche Aufgaben und sind nicht direkt vergleichbar.
LifeVal setzt den Schwerpunkt auf Situationen, bei denen Menschen nach Unterstützung fragen. Offen bleibt, wie verlässlich die gezeigten Ergebnisse außerhalb der jeweiligen Testbedingungen sind. Wer eine KI bei einer wichtigen Entscheidung einsetzt, muss deshalb nachvollziehen können, welche Angaben der Vorschlag verwendet und welche Entscheidung weiterhin beim Menschen liegt.
Quellen
- OpenAI: LifeVal, 2. November 2026
- OSWorld 2.0: Benchmarking Computer Use Agents on Long-Horizon Real-World Tasks, 2026
Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft.