Eine KI soll bei einem Umzug helfen: passende Kindergärten finden, Angaben vergleichen und offene Entscheidungen markieren. Wenn sie diese Aufgabe in einem Test gut löst, klingt das nach einem verlässlichen Assistenten. Doch ein zweiter Test stellt eine andere Frage: Behält das Modell auch dann den Überblick, wenn sich Informationen über viele Schritte verändern?
Die Antwort hängt davon ab, was genau geprüft wird. OpenAIs Alltagstest LifeVal und der Forschungsbenchmark StateBench von Ai2 zeigen zwei Seiten derselben Herausforderung. Der eine prüft praktische Aufgaben, der andere isoliert eine Grundfähigkeit. Zusammen machen sie sichtbar, warum ein hoher Wert für eine bestimmte Prüfung noch keine allgemeine Garantie für einen KI-Assistenten ist.
Ein Test beginnt mit einer Entscheidung
Ein Benchmark ist eine Sammlung von Aufgaben mit Regeln für die Bewertung. Er macht Leistungen unter bestimmten Bedingungen vergleichbar. Welche Bedingungen gewählt werden, entscheidet aber darüber, was der Wert aussagt. Ein Test mit kurzen Wissensfragen kann zeigen, ob ein Modell Antworten findet. Er verrät viel weniger darüber, ob eine längere Aufgabe mit mehreren Entscheidungen gelingt.
LifeVal setzt bei Aufgaben an, bei denen Menschen Unterstützung wünschen. OpenAI nutzte dafür Zeitnutzungsstudien und eine eigene Befragung von 3.995 Personen. Daraus entstanden Aufgaben aus Bereichen wie Betreuung, Bildung, Haushalt und Finanzen. Das Unternehmen nennt etwa die Vorauswahl von Kindergärten nach einem Umzug. Eine gute Antwort soll passende Möglichkeiten zusammenstellen und deutlich machen, welche Vorlieben noch geklärt werden müssen.
Der Ansatz hat einen Vorteil: Eine Prüfung kann sich an einem Ziel orientieren, das Menschen tatsächlich wichtig finden. Ein Assistent muss nicht nur einzelne Fakten nennen, sondern eine nützliche Antwort für eine konkrete Aufgabe zusammenstellen. OpenAI berichtet für ausgewählte Beispiele hohe Werte und beschreibt, dass es LifeVal auch zur Verbesserung eigener Modelle nutzt.
Gerade deshalb muss man die Zahlen im Zusammenhang lesen. Die Aufgaben, Bewertungsregeln und die getestete Ausführung bestimmen, was ein Ergebnis bedeutet. Die Werte einzelner Beispiele sind keine Fehlerquote für alle Haushalte, Länder oder zukünftigen Aufträge. OpenAI prüft zudem Systeme, die das Unternehmen selbst entwickelt. Das macht die veröffentlichten Angaben aufschlussreich für den beschriebenen Test, ersetzt aber keine unabhängige Aussage über jede praktische Nutzung.
Was eine Schlüsselübergabe sichtbar macht
Ai2 geht mit StateBench anders vor. Das Institut untersucht, wie Sprachmodelle Zustände in langen Folgen verfolgen: Wer hat einen Gegenstand nach mehreren Übergaben, oder welchen Wert besitzt eine Variable nach verschiedenen Änderungen? Eine Variable ist hier ein Platzhalter, dessen Wert sich im Verlauf ändern kann.
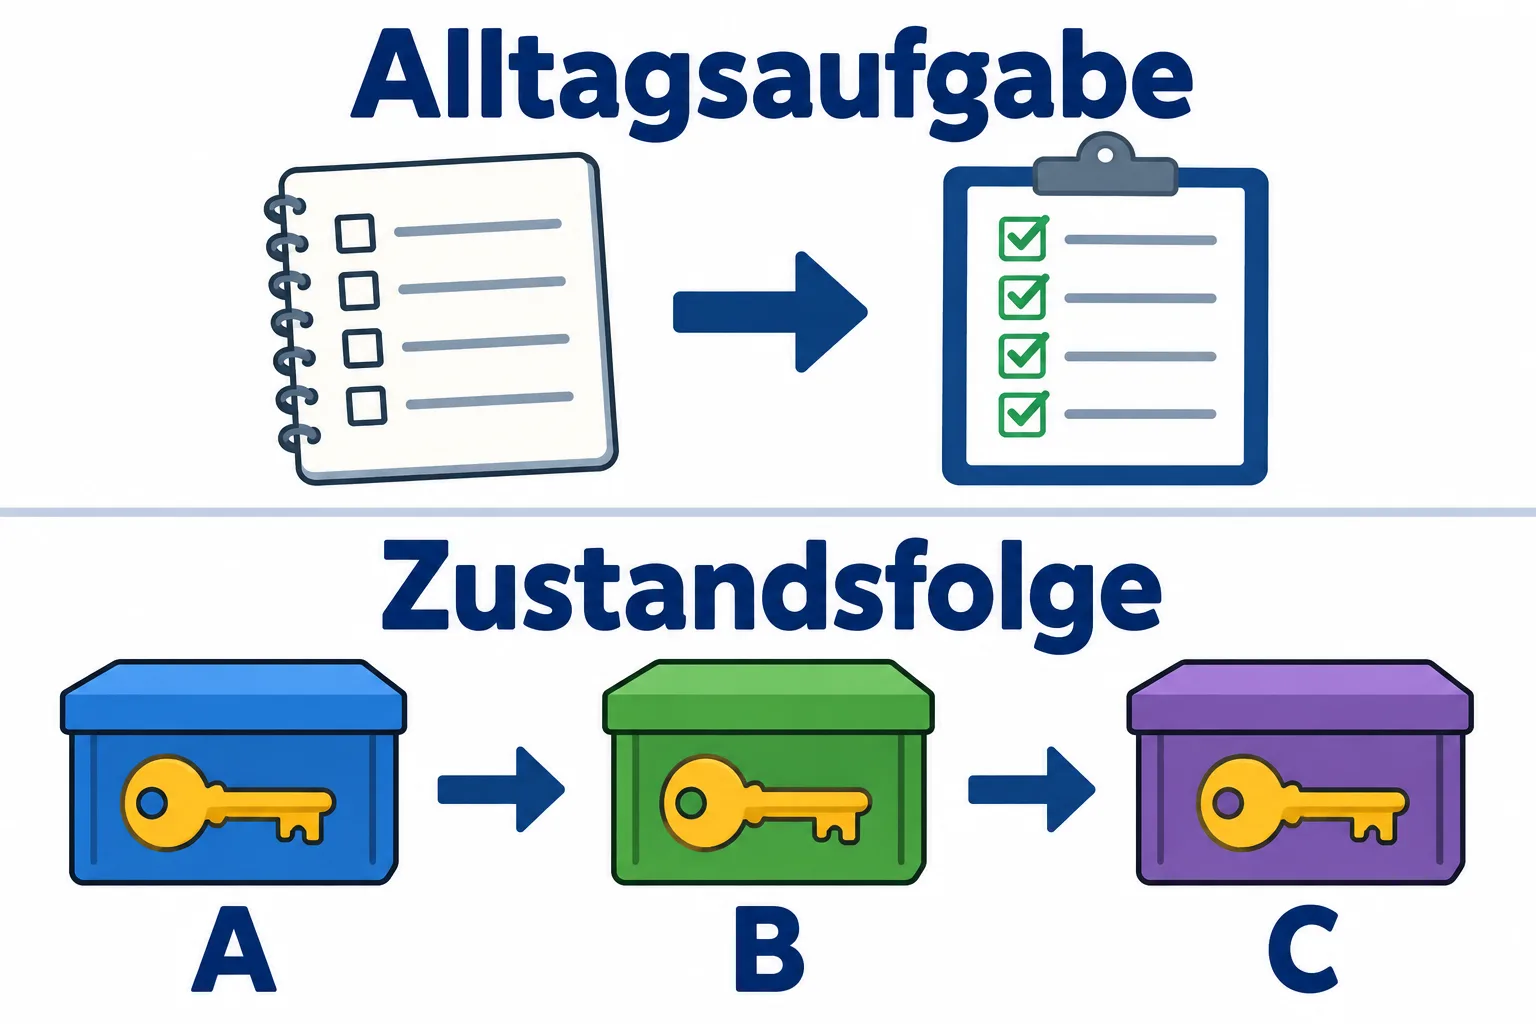
Ein gedachtes Beispiel macht die Schwierigkeit greifbar: Anna gibt Ben einen Schlüssel, Ben gibt ihn an Clara weiter. Die Antwort auf die Frage nach dem aktuellen Besitzer hängt von der Reihenfolge ab. Wer nur die erste Übergabe findet, nennt Ben, obwohl Clara den Schlüssel inzwischen hat. Bei längeren Ketten kann schon eine übersehene Änderung die spätere Antwort verfälschen.
StateBench staffelt solche Aufgaben. Manche Werte bleiben gleich, andere werden überschrieben. Schwieriger wird es, wenn eine Änderung auf dem bisherigen Wert aufbaut oder mehrere Werte voneinander abhängen. Ai2 ließ vier leistungsfähige Modelle Folgen von Zuweisungen auswerten. Bei den längsten Aufgaben der schwierigsten Klasse erreichten sie laut Institut höchstens 13 Prozent Genauigkeit. Bei einfacheren Klassen schnitten sie gut ab.
Die Zahl beschreibt genau diese künstlichen Aufgaben. Sie lässt sich nicht mit den LifeVal-Werten verrechnen und sagt nicht, dass ein Assistent im Alltag in 87 Prozent der Fälle scheitert. Umgekehrt zeigt ein Erfolg bei einer praktischen Aufgabe nicht automatisch, dass jede lange Kette abhängiger Änderungen beherrscht wird. Die Prüfungen setzen unterschiedliche Schwerpunkte.
Warum die Form der Aufgabe zählt
Selbst dieselbe Grundfähigkeit kann je nach Darstellung unterschiedlich aussehen. Ai2 berichtet, dass kleinere offene Modelle bei einer einfachen Wiederfindeaufgabe in einem Format fast perfekt waren, bei einer Darstellung als Tabellenbearbeitung aber nahe am Zufallsniveau lagen. Wer nur eine Punktzahl sieht, erkennt diesen Unterschied nicht. Eine aussagekräftige Prüfung muss deshalb auch zeigen, wie eine Aufgabe gestellt wurde und wo Fehler auftreten.
Es gibt zugleich einen wichtigen Gegenbefund gegen die Vorstellung, solche Fehler seien unvermeidlich. Ai2 trainierte kleinere Modelle gezielt auf StateBench-Aufgaben und testete sie anschließend an erheblich längeren Folgen. Einige rekurrente und hybride Bauweisen, die Informationen über Verarbeitungsschritte hinweg weiterführen, lösten einfachere Aufgabentypen auch bei langen Folgen nahezu fehlerfrei. Die direkt trainierten kleinen Modelle und die bereits vortrainierten großen Assistenten wurden allerdings in unterschiedlichen Versuchen untersucht. Aus den Ergebnissen folgt keine allgemeine Rangliste.
Auch der künstliche Test hat Grenzen. StateBench arbeitet mit einer festen Zahl von Variablen. In einem Gespräch können neue Menschen, Gegenstände oder Bedingungen hinzukommen. Die aktuelle Prüfung bildet diesen Fall nach Angaben von Ai2 noch nicht ab. Sie legt eine Schwachstelle unter kontrollierten Bedingungen frei; sie bildet nicht den gesamten Alltag nach.
Welche Frage ein guter Wert beantwortet
Für Nutzerinnen und Nutzer ist deshalb weniger die größte Zahl entscheidend als die Frage dahinter: Welche Aufgabe wurde gestellt? Was galt als Erfolg? Welche Werkzeuge und Informationen standen zur Verfügung? Und wurde dieselbe Leistung auch bei einer anderen Formulierung oder längeren Folge geprüft?
Ein alltagsnaher Test zeigt, ob ein System bei ausgewählten praktischen Aufgaben nützliche Ergebnisse liefert. Ein eng gefasster Fähigkeitstest hilft zu verstehen, wo ein notwendiger Teilschritt brüchig werden kann. Beide Perspektiven ergänzen sich, ohne sich gegenseitig zu ersetzen. Wer einem Assistenten eine Aufgabe mit wichtigen Folgen überträgt, gewinnt durch diese Unterscheidung eine konkrete Orientierung: Ergebnis und entscheidende Zwischenschritte verdienen eigene Aufmerksamkeit, auch wenn ein Testwert beeindruckend aussieht.
Quellen
Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft.