Ein KI-Modell kann scheinbar einwandfrei laufen und trotzdem einen folgenreichen Fehler enthalten. Bei UMT5 durfte der Decoder zeitweise auf Wörter blicken, die er beim Training eigentlich erst vorhersagen sollte. Das Programm stürzte nicht ab. Hugging Face will solche stillen Fehler künftig früher finden: mit kleinen Testmodellen, die typische Aufgaben durchlaufen und ihre Ergebnisse mit geprüften Referenzen vergleichen.
Der Ansatz heißt Model Integration Contracts, kurz MIC. Er soll Änderungen an der Softwarebibliothek Transformers prüfen, bevor sie unbemerkt in den gemeinsamen Entwicklungsstand gelangen. Die bisherigen Ergebnisse sind vielversprechende Experimente des Projekts; wie gut die Prüfung im täglichen Einsatz arbeitet, ist noch offen.
Ein Fehler, den ein einfacher Start nicht zeigt
Transformers stellt Entwicklern Werkzeuge zur Verfügung, mit denen sie viele unterschiedliche KI-Modelle laden und nutzen können. Wird gemeinsamer Programmcode geändert, kann das Auswirkungen auf eine Modellfamilie haben, obwohl andere Modelle weiter funktionieren. Ein Test, der nur kontrolliert, ob ein Modell startet und eine Ausgabe liefert, sieht solche Veränderungen nicht unbedingt.
Genau das geschah laut Hugging Face beim Modell UMT5. Nach einer Änderung an einer Aufmerksamkeitsfunktion konnte dessen Decoder beim Training zukünftige Bestandteile einer Antwort berücksichtigen. Anschaulich ist das wie eine Prüfung, bei der eine Person die Lösung schon während der Bearbeitung sehen kann: Es entsteht zwar eine Antwort, aber die Bedingungen stimmen nicht mehr.
Die Änderung gelangte am 30. Juli 2026 in den gemeinsamen Code; der Fix wurde am 28. September dokumentiert. Hugging Face prüfte später rückblickend, ob ein kleineres Testmodell die betroffenen Entwicklungsstände unterscheiden kann. Das tat es nach Angaben des Teams durchgehend. Entscheidend war, dass der Test denselben betroffenen Berechnungsweg benutzte. Eine andere Variante übersah den Fehler.
Ein Modell im Kleinformat
Eine vollständige Prüfung aller unterstützten Modelle bei jeder Codeänderung wäre aufwendig. Große Modelle brauchen viel Speicher und oft leistungsfähige Grafikprozessoren. Hugging Face verkleinert daher ein Modell für den Test: Es reduziert etwa die Zahl und Breite von Schichten, versucht aber, die verschiedenen Arten von Bausteinen zu erhalten. Auch die Dateien für die Vorbereitung der Eingaben bleiben erhalten.
Das ist wichtig, weil der Test nicht bloß irgendeine Rechnung ausführen soll. Er soll einen Weg durch die Software nehmen, der dem späteren Gebrauch ähnelt. Fehlt beim Verkleinern gerade die Art von Schicht, in der ein Fehler steckt, kann der Test daran vorbeilaufen. Die kleine Version ist deshalb ein Prüfwerkzeug und kein gleich leistungsfähiger Ersatz für das ursprüngliche Modell.
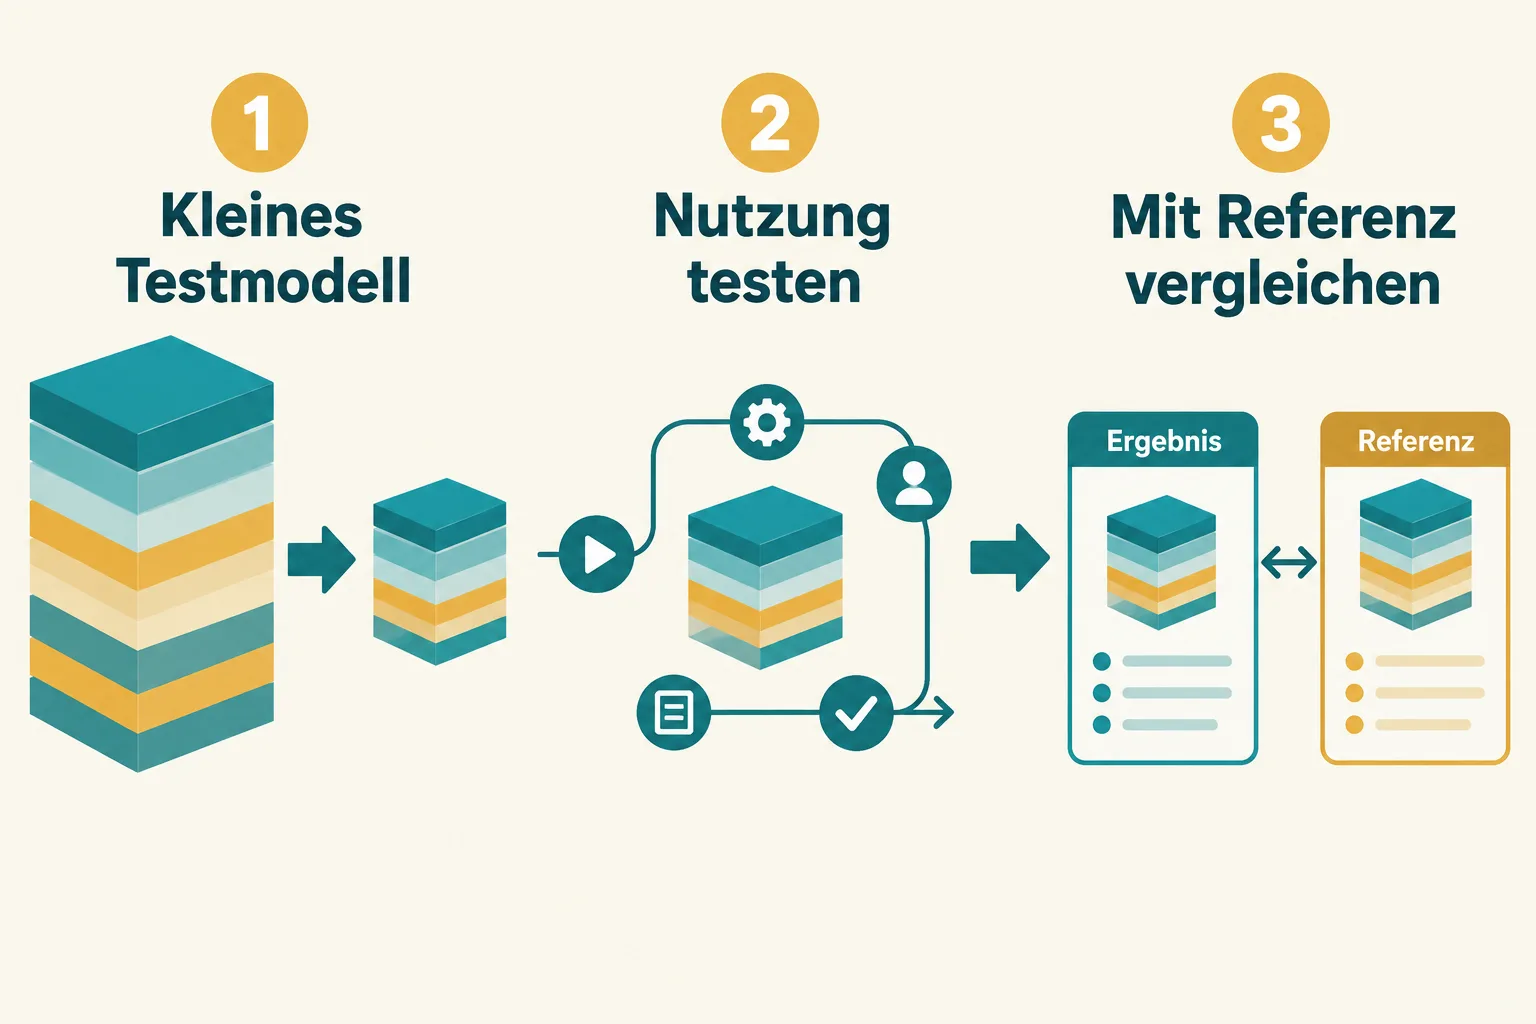
Im UMT5-Versuch belegten die Gewichte des experimentellen Testmodells 66 Megabyte gegenüber 1.227 Megabyte beim Ausgangsmodell. Gewichte sind die gespeicherten Zahlen, mit denen ein Modell rechnet. Der einzelne Testschritt auf einem CPU-Rechner dauerte in einer Demonstration 13,4 Sekunden; die Einrichtung war darin nicht enthalten. Beides sind Angaben für diesen Versuch, keine allgemeine Zeit- oder Größenangabe für alle Modelle.
Was der Vertrag festhält
Ein MIC besteht aus drei Teilen. Erstens gibt es das eingefrorene kleine Testmodell. Zweitens beschreibt ein ausführbares Beispiel einen konkreten Nutzungspfad, etwa Text erzeugen oder einen Trainingsschritt ausführen. Drittens werden die Ergebnisse mit zuvor aufgezeichneten und von Menschen überprüften Referenzen verglichen.
Ändert sich das Ergebnis nach einer Softwareänderung unerwartet, kann der Test Alarm geben. Er prüft also mehr als die Frage, ob das Programm ohne Fehlermeldung endet. Bei einem Trainingsbeispiel können etwa auch Verlustwert und Gradienten betrachtet werden. Der Verlustwert beschreibt dabei, wie stark das Modell im gewählten Beispiel von einem Ziel abweicht; Gradienten zeigen, in welche Richtung Gewichte beim Lernen verändert werden.
Eine Abweichung ist zunächst ein Hinweis. Ob sie einen Fehler oder eine gewollte Änderung zeigt, müssen Menschen beurteilen. Auch Referenzwerte können sich bei unterschiedlichen Plattformen und Rechengenauigkeiten unterscheiden. Hugging Face hält daher passende Vergleichswerte und Softwarestände fest, damit ein Ergebnis nachvollziehbar bleibt.
Warum der gewählte Testpfad entscheidet
Ein verkleinertes Modell entdeckt nur Probleme, die der gewählte Ablauf überhaupt berührt. In einer dokumentierten rückblickenden Auswertung über fünf Monate fand eine erste Gruppe von Verträgen einen Fehler, verpasste vier und meldete einmal fälschlich Alarm. Nachdem die fehlenden Nutzungspfade ergänzt worden waren, wurden in dieser untersuchten Gruppe alle fünf Fehler erkannt, ohne einen zusätzlichen Fehlalarm.
Das zeigt zugleich Nutzen und Grenze: Ein konkreter Fehler kann helfen, einen fehlenden Test nachzutragen. Die kleine rückblickende Auswahl sagt aber nicht, welche Trefferquote künftig bei allen Änderungen zu erwarten ist. Ein Test, der nur Textgenerierung aufruft, prüft beispielsweise keinen separaten Audiopfad.
Auch die inneren Zahlen des kleinen Modells beeinflussen die Empfindlichkeit. Im Whisper-Versuch verglich das Team zufällig gewählte Gewichte mit einer Variante, die auf wenige Beispiele trainiert war. Bei 24 künstlich eingebauten Fehlern erkannte die erste Variante 18 und die zweite alle 24. Beide übersahen aber einen realen Fehler bei einer besonderen Form der Textgenerierung. Aus diesem Versuch lässt sich deshalb nicht ableiten, dass das kurze Training grundsätzlich überlegen ist.
Früher Hinweis statt vollständiger Entwarnung
Der praktische Reiz liegt darin, häufiger realistische Nutzungsschritte auf vergleichsweise kleinen Rechnern auszuführen. Ein Entwickler muss dann nicht darauf warten, bis ein umfassenderer geplanter Test mit großen Modellen eine Änderung untersucht. Besonders wertvoll sind Fälle wie UMT5, in denen ein Programm weiterläuft und falsches Verhalten erst ein Vergleich sichtbar macht.
Stand 1. November meldete der MIC-Prüflauf laut Hugging Face Fehler, ohne Änderungen automatisch zu blockieren. Noch offen sind unter anderem die Zahl tatsächlich früh erkannter Fehler, die Häufigkeit von Fehlalarmen und der Aufwand für die Prüfung neuer Referenzen. Die bisherigen vollständigen Tests sollen bleiben, während die Abdeckung der kleinen Verträge wächst. Die entscheidende Frage ist damit nicht, ob ein kleines Modell ein großes ersetzt, sondern welche konkreten Fehler es rechtzeitig sichtbar macht.
Quellen
- Hugging Face: Transformers Model Integration Contracts, 3. November 2026.
- Hugging Face: MICs: evidence so far, abgerufen am 4. November 2026.
- Transformers: Fix UMT5 decoder self-attention, 28. September 2026.
Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft.