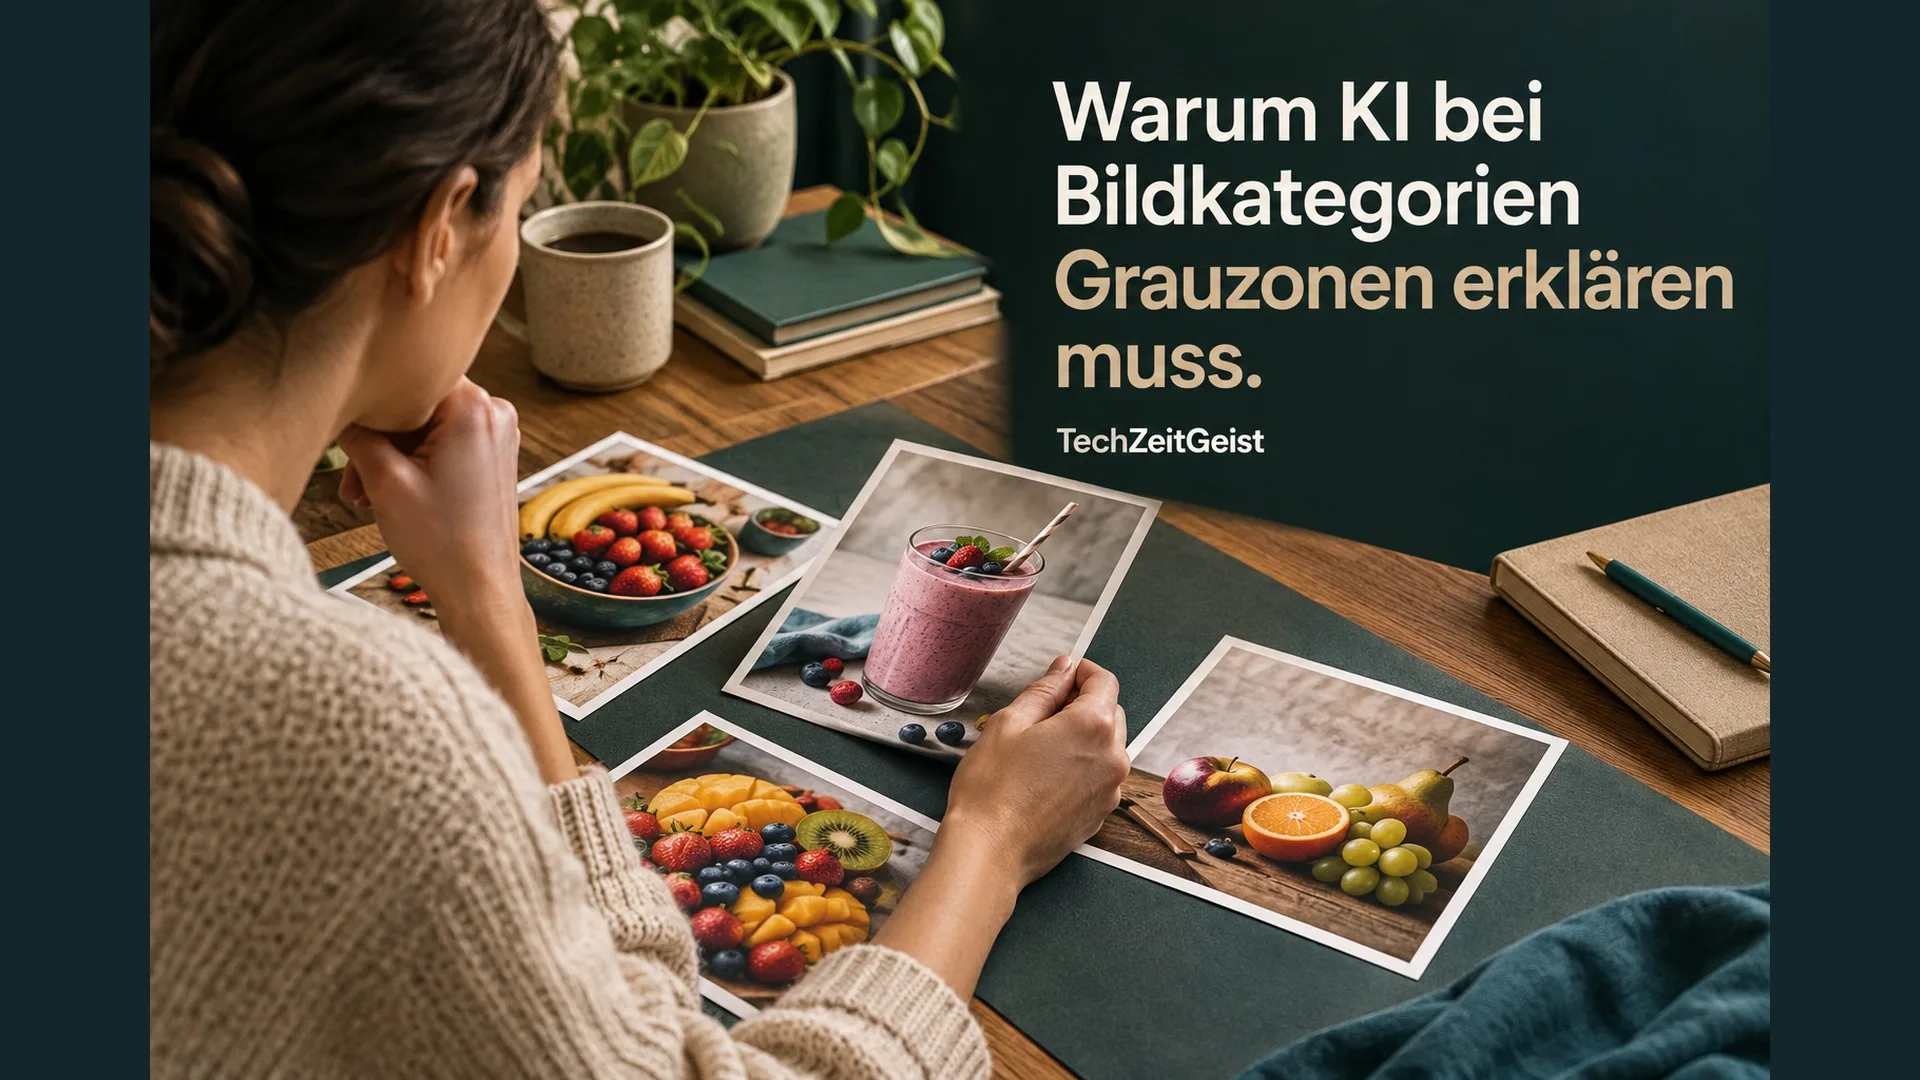
Ist ein Smoothie gesundes Essen? Die Antwort hängt davon ab, wer fragt und welche Zutaten gemeint sind. Für ein KI-System, das Bilder sortieren soll, ist diese Unschärfe ein handfestes Problem: Eine kurze Vorgabe wie „gesund“ verrät nicht, wo der Nutzer die Grenze ziehen möchte.
Ein Forschungsteam um Google Research schlägt deshalb einen anderen Weg vor. Sein System Agile Deliberation legt Menschen gezielt schwierige Beispiele vor. Aus ihren Entscheidungen entstehen genauere Anweisungen für einen Bildklassifikator. Eine kleine Studie zeigt, wie das funktionieren kann. Sie zeigt zugleich, weshalb bessere Übereinstimmung mit einer Person noch keine allgemein gültige Antwort ergibt.
Ein Wort enthält noch keine Regel
Ein Bildklassifikator ordnet Bildern Kategorien zu. Er kann etwa entscheiden, ob ein Motiv zu einer vorgegebenen Sammlung gehört. Bei klar umrissenen Gegenständen lässt sich eine Zuordnung häufig leichter vereinbaren als bei Begriffen wie „inspirierende Kunst“ oder „gesundes Essen“. Hier spielen Zweck und persönliche Maßstäbe eine Rolle.
Wer eine solche Sammlung anlegen will, beginnt womöglich mit einer Vorstellung, ohne alle Ausnahmen zu kennen. Ein Salat scheint ein naheliegendes Beispiel. Doch wie steht es um ein Getränk aus Obst, Zucker und Milch? Erst am konkreten Bild wird deutlich, welche Eigenschaft für die eigene Auswahl wichtig ist. Zwei Menschen können dieselbe Aufnahme sehen und verschiedene, jeweils begründete Entscheidungen treffen.
Ein System, das nur das Schlagwort erhält, muss die fehlende Grenze aus seinen allgemeinen Mustern ableiten. Es kann eine plausible Antwort liefern und trotzdem an der Absicht seines Nutzers vorbeigehen. Mehr Beispiele helfen nur dann gezielt weiter, wenn sichtbar wird, welche Frage sie aufwerfen.
Vom Oberbegriff zum Grenzfall
Das Forschungsprojekt teilt die Arbeit in zwei Schritte. Zunächst zerlegt der Nutzer den Oberbegriff in passendere Untergruppen und benennt Ausschlüsse. Bei einer Sammlung gesunder Speisen könnten das bestimmte zubereitete Gerichte sein; andere Lebensmittel lassen sich ausdrücklich ausschließen. Die Vorgaben beschreiben dadurch genauer, was gesucht wird.
Danach sucht das System nach Bildern, die nahe an solchen Grenzen liegen. Die Person bewertet die Vorschläge und erläutert gegebenenfalls, weshalb sie dazugehören oder nicht. Das System nutzt diese Rückmeldung, um die textliche Beschreibung für das Bild-Sprach-Modell anzupassen. Ein solches Modell verarbeitet Bild und Sprache gemeinsam; die Beschreibung dient ihm als Anweisung für die Zuordnung.
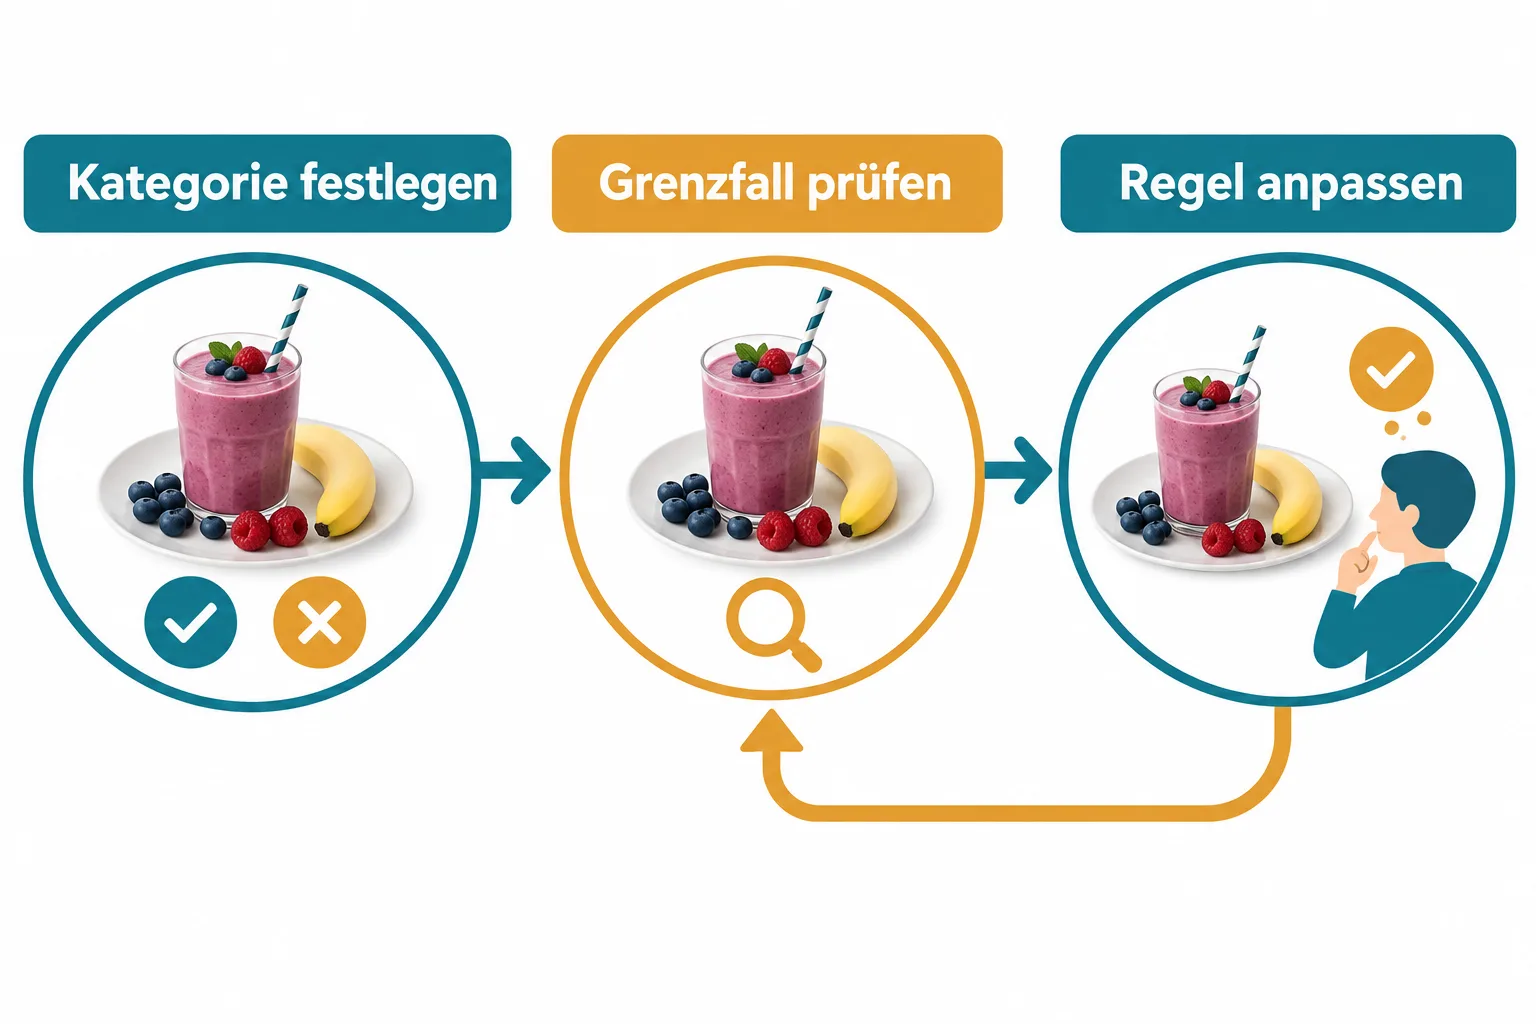
Der entscheidende Punkt ist die Rückkopplung. Eine Person muss nicht schon vor dem ersten Beispiel sämtliche Regeln formulieren. Sie sieht einen schwierigen Fall, erkennt einen bislang unausgesprochenen Unterschied und kann ihre Vorgabe ändern. Die nächste Suche arbeitet mit der veränderten Beschreibung weiter.
Das bedeutet nicht, dass die Maschine selbst entscheidet, was gesund oder ansprechend ist. Sie hilft dabei, eine bestimmte menschliche Definition in eine für die Aufgabe verwendbare Anweisung zu übersetzen. Welche Grenze gelten soll, bleibt eine Entscheidung der Person beziehungsweise der Organisation, die das Werkzeug einsetzt.
Was die Studie verglichen hat
Die Forschungsarbeit von Leijie Wang und Kollegen untersucht den Ansatz anhand von zwei subjektiven Aufgaben: gesunden Lebensmitteln und Bildern, die mit irreführenden Gewinnversprechen im Unterhaltungs- oder Spielebereich verbunden sind. Das Team verglich das Verfahren unter anderem mit einer einfachen Ausgangsanweisung, einer automatisch zerlegten Beschreibung und einer manuellen Suche nach Grenzfällen.
Neun Personen aus der eigenen Organisation nahmen teil. Keine hatte zuvor professionell Inhalte moderiert. Jede Person absolvierte zwei Sitzungen zu unterschiedlichen Konzepten, eine mit dem neuen Verfahren und eine mit manueller Bearbeitung. So kamen 18 Sitzungen von jeweils etwa 90 Minuten zustande. Die Reihenfolge der Systeme wurde verteilt.
Anschließend bewerteten die Teilnehmenden pro Sitzung 200 zurückgehaltene Bilder. Daran prüfte das Team, wie gut die Klassifikatoren mit den jeweiligen Entscheidungen übereinstimmten. Die Autoren berichten für ihren Ansatz höhere F1-Werte als bei den Vergleichsverfahren. Dieser Wert verbindet zwei Fragen: Wie viele passende Bilder werden gefunden, und wie viele der ausgewählten Bilder passen nach der jeweiligen Bewertung tatsächlich?
Eine bessere Übereinstimmung ist kein allgemeines Urteil
Die Größe der Untersuchung setzt den Ergebnissen Grenzen. Neun Personen und zwei Aufgaben können nicht zeigen, wie zuverlässig das Verfahren in allen denkbaren Anwendungen arbeitet. Die Forschenden nennen die geringe Zahl selbst als Einschränkung und wünschen sich größere Gruppen und weitere Begriffe.
Auch der Vergleich hat eine Besonderheit: Weil dieselbe Person ein Konzept nach der ersten Sitzung bereits genauer verstanden hätte, bearbeitete sie mit dem anderen Verfahren ein anderes Konzept. Die Leistung für dasselbe Konzept musste deshalb zwischen verschiedenen Personen verglichen werden. Unterschiede zwischen Personen und Aufgaben können das Ergebnis beeinflussen.
Hinzu kommt die Frage nach dem Maßstab. Bewertet wird, wie gut ein Klassifikator die Entscheidungen der jeweiligen Person trifft. Das ist für eine persönliche Sammlung nützlich. Bei Moderation oder anderen Entscheidungen mit Folgen für viele Menschen müsste zusätzlich geklärt werden, wer die Regeln festlegt und wie abweichende Sichtweisen berücksichtigt werden. Ein genaueres Abbild einer einzelnen Vorgabe beantwortet diese Frage nicht.
Der praktische Gedanke bleibt dennoch verständlich: Wer mit einer vagen Kategorie arbeitet, braucht oft nicht zuerst eine größere Liste eindeutiger Beispiele. Ein bewusst ausgewählter Grenzfall kann die Frage sichtbar machen, die in der ursprünglichen Anweisung noch fehlt.
Quellen
- Google Research: Agile Deliberation: How AI helps humans define the gray areas, 4. November 2026.
- Wang et al.: Agile Deliberation: Concept Deliberation for Subjective Visual Classification, Version vom 4. April 2026.
Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft.