Ein Rechenzentrum kann ausgelastet aussehen und trotzdem Zeit verlieren. Wenn viele Grafikprozessoren gemeinsam ein KI-Modell trainieren, müssen sie ihre Zwischenergebnisse regelmäßig abgleichen. Kommt ein beteiligter Rechner verspätet an, warten die anderen. Schon ein einzelner langsamer Knoten kann so einen synchronen Trainingslauf ausbremsen.
Nvidia beschreibt nun eine Reihe von Werkzeugen für solche GPU-Cluster: Sie sollen Softwarekonfigurationen vereinheitlichen, die Leistungsfähigkeit vor dem Einsatz prüfen und Fehler während des Betriebs erkennen. Entscheidend ist dabei die Unterscheidung zwischen einem Rechner, der eingeschaltet ist, und einem, der seine Aufgabe im Zusammenspiel schnell genug erfüllt.
Warum die anderen warten müssen
Ein großes KI-Modell wird häufig auf mehrere Beschleuniger verteilt. Bei einer Form des datenparallelen Trainings erhält jeder Prozess einen Teil der Daten und berechnet daraus, wie die Modellparameter angepasst werden sollten. Diese Beiträge werden zusammengeführt, bevor die beteiligten Kopien mit dem nächsten Schritt fortfahren. Grafikprozessoren, kurz GPUs, sind auf viele parallele Berechnungen spezialisiert; ein Cluster verbindet mehrere solcher Rechner.
Für einen anschaulichen Vergleich stellen wir uns drei Teams vor, die gemeinsam eine Rechnung abstimmen. Zwei sind fertig, das dritte braucht länger. Der gemeinsame Abgleich kann erst abgeschlossen werden, wenn auch sein Beitrag vorliegt. Laut PyTorch können solche Nachzügler etwa durch ungleich große Datenaufgaben, langsame Datenübertragung oder Probleme im Netzwerk entstehen. Auch Hardwareverschleiß kann eine Rolle spielen. Eine lange Wartezeit ist deshalb zunächst ein Symptom, keine fertige Fehlerdiagnose.
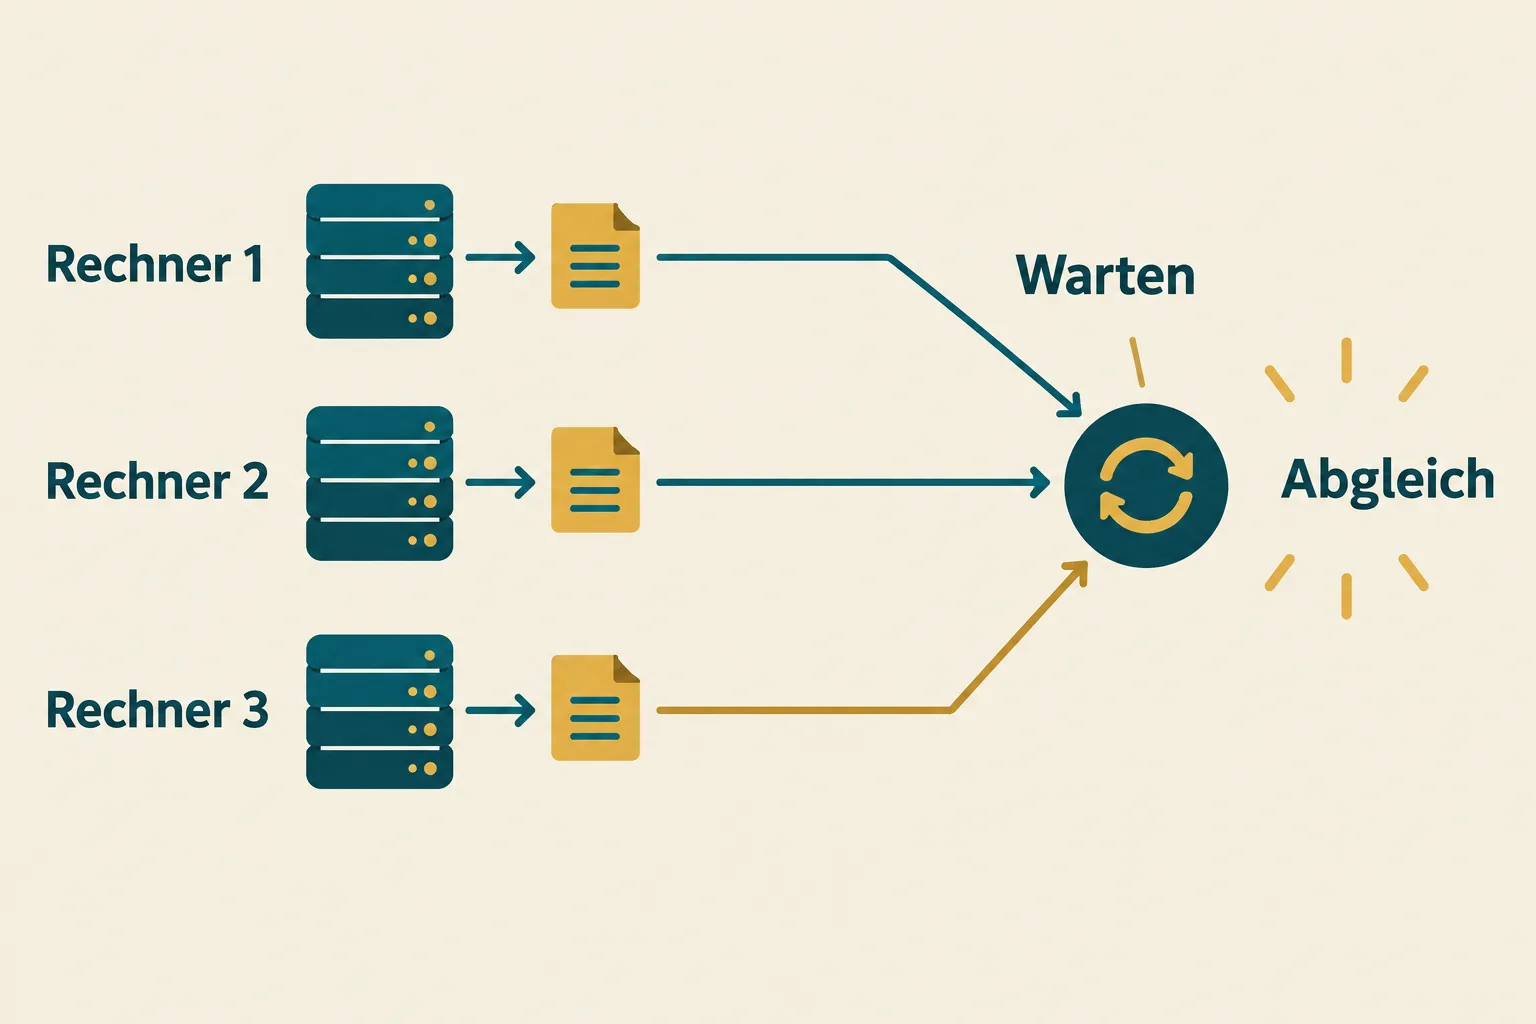
Das gilt für synchronisierte Arbeitsschritte, nicht pauschal für jede Anwendung eines Rechenzentrums. Verschiedene Trainingsverfahren verteilen und koordinieren Arbeit unterschiedlich. Doch dort, wo Prozesse aufeinander warten, genügt die reine Anzeige einer hohen GPU-Auslastung nicht, um den tatsächlichen Fortschritt zu beurteilen.
Gleiche Ausgangslage für viele Rechner
Mit wachsender Zahl von Rechnern wird bereits ihre Einrichtung anspruchsvoll. Treiber, Netzwerksoftware und andere Komponenten müssen zusammenpassen. Nach einer Reparatur oder einem Update kann ein einzelner Rechner von der vorgesehenen Konfiguration abweichen. Dann sucht das Betriebsteam möglicherweise an der falschen Stelle nach der Ursache eines Problems.
Nvidias technische Anleitung beschreibt dafür AI Cluster Runtime, kurz AICR. Das Werkzeug erstellt eine nachvollziehbare Konfiguration mit festgelegten Softwareversionen und Abhängigkeiten. Eine Abhängigkeit legt etwa fest, welche Komponente zuerst bereit sein muss. Die erzeugten Vorgaben werden anschließend von vorhandenen Installationswerkzeugen angewendet.
Eine solche Vorlage macht Unterschiede sichtbar und erleichtert es, denselben Ausgangszustand wiederherzustellen. Sie garantiert aber nicht, dass jede Verbindung unter Last die erwartete Leistung erreicht. Dafür muss das Zusammenspiel getestet werden.
Ein bestandener Start ist noch kein Leistungstest
Ein Rechner kann auf eine einfache Statusabfrage antworten, obwohl eine Verbindung zu langsam ist. Der Unterschied ähnelt einem Auto, dessen Motor startet, das aber auf der Straße nicht die erwartete Leistung erreicht. Für einen GPU-Verbund interessiert daher auch, wie schnell die Beteiligten Daten austauschen und ob eine Trainingsaufgabe gemeinsam läuft.
Nvidias Cluster Readiness Engine, NVCRE, führt laut Anleitung unter anderem Kommunikationstests und Trainingslasten aus. Schlägt ein Test für eine Gruppe fehl, kann das Werkzeug kleinere Gruppen erneut prüfen, um verdächtige Knoten einzugrenzen. Das Ergebnis ist ein Hinweis für die Fehlersuche: Eine auffällige Gruppe allein erklärt noch nicht, welches Bauteil die Ursache ist.
Eine wichtige Einstellung liegt beim Betreiber. Standardmäßig sind laut Nvidia keine Leistungsschwellen vorgegeben. Ohne einen passenden Grenzwert kann ein Test Messwerte liefern und dennoch einen langsamen Knoten passieren lassen, sofern der Test überhaupt startet. Erst eine geeignete Schwelle macht aus dem Messergebnis eine Prüfung gegen die erwartete Leistung. Zu welchem Wert sie passen sollte, hängt von der jeweiligen Umgebung ab.
Was während des Betriebs geschieht
Ein einmal bestandener Test bleibt eine Momentaufnahme. Rechner werden hinzugefügt oder repariert, Software wird verändert. Das Werkzeug NVSentinel beobachtet nach Nvidias Beschreibung unter anderem Zustandsmeldungen von GPUs und Netzwerkgeräten. Es kann auffällige Rechner bei entsprechender Konfiguration für neue Aufgaben sperren und Reparaturen anstoßen.
Das zugrunde liegende Verwaltungssystem Kubernetes organisiert Anwendungen auf den Rechnern des Clusters. Einen Knoten als nicht einplanbar zu markieren, verhindert normalerweise neue Zuweisungen; bereits laufende Aufgaben werden dadurch laut Kubernetes-Dokumentation nicht automatisch entfernt. Dafür sind weitere Schritte nötig. Nvidias Anleitung nennt außerdem einen Überwachungsmodus als Standard: Automatische Quarantäne und Eingriffe müssen ausdrücklich eingerichtet werden.
Nach einer Reparatur kann eine erneute Prüfung verhindern helfen, dass ein weiterhin auffälliger Rechner sofort wieder Arbeit erhält. Für bestimmte Ereignisse lässt sich dieser Ablauf laut Nvidia automatisieren. Der Betreiber muss dafür die beteiligten Komponenten und Tests entsprechend konfigurieren.
Werkzeugkasten statt Erfolgsgarantie
Die drei Ebenen beantworten verschiedene Fragen: Ist die Software wie vorgesehen eingerichtet? Besteht der Verbund einen passenden Praxistest? Und treten später neue Fehlersignale auf? Zusammen können sie die Suche strukturieren. Sie ersetzen weder eine sorgfältige Auswahl der Tests noch die Untersuchung der konkreten Ursache.
Nvidia beschreibt die eigenen, quelloffenen Werkzeuge und ihre Funktionen. Ein unabhängiger Vergleich, der für alle Betreiber eine bestimmte Zeit- oder Kostenersparnis belegt, ist daraus nicht abzuleiten. Gerade die fehlenden Standardschwellen zeigen, warum der betriebliche Nutzen von den gewählten Prüfungen und der tatsächlichen Umgebung abhängt.
Quellen
- Nvidia: Configure, Certify, and Operate Kubernetes GPU Clusters with NVIDIA DSX OS, 5. November 2026.
- PyTorch: Straggler Mitigation On PyTorch DDP By Hierarchical SGD.
- Kubernetes: Nodes.
Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft.