Welche Eigenschaften wird ein Molekül haben, das im Labor noch kaum untersucht wurde? Ein Team des MIT und des Chemiekonzerns BASF hat dafür ein KI-Modell namens CheMeleon entwickelt. Es lernt zunächst an berechneten Merkmalen vieler Moleküle und lässt sich anschließend mit vergleichsweise wenigen Messdaten auf eine konkrete Aufgabe einstellen.
Die Forschenden verglichen das Modell auf 58 Datensätzen mit anderen Verfahren. In diesem Vergleich schnitt CheMeleon laut ihrer Studie im Journal of Chemical Information and Modeling insgesamt besser ab als die untersuchten klassischen Methoden und andere Basismodelle. Die Arbeit erschien bereits im August online; das MIT stellte sie am 6. November ausführlich vor.
Warum wenige Messungen ein Problem sind
Bei der Suche nach einem neuen Wirkstoff oder Material stehen häufig sehr viele mögliche Moleküle zur Auswahl. Interessant ist beispielsweise, wie gut sich ein Stoff löst oder wie stark er an ein bestimmtes biologisches Ziel bindet. Solche Eigenschaften lassen sich nicht einfach aus dem Namen ablesen. Messungen und die Herstellung neuer Verbindungen kosten Zeit und Geld.
Ein Computermodell kann helfen, Kandidaten für weitere Versuche auszuwählen. Dafür muss es aber zunächst Zusammenhänge zwischen Molekülstruktur und gesuchter Eigenschaft lernen. Gerade bei einer neuen Fragestellung sind Messungen dafür oft knapp. Ein Modell, das nur für diese eine Aufgabe von vorn trainiert wird, hat dann wenig Anschauungsmaterial.
Erst Grundlagen lernen, dann anpassen
CheMeleon teilt das Lernen in zwei Schritte. Zunächst verwendete das Team nach Angaben des MIT rund eine Million Moleküle aus der öffentlichen Datenbank PubChem. Für sie berechnete es ungefähr 1.600 Merkmale, sogenannte Deskriptoren. Dazu gehören etwa Molekülgewicht oder die Zahl bestimmter Atome.
Das Modell lernt, diese Merkmale aus der Struktur vorherzusagen. Es bekommt also viele Beispiele dafür, wie chemische Bausteine miteinander zusammenhängen. Erst danach wird es für eine konkrete Frage weiter trainiert, etwa mit vorhandenen Messwerten zur Löslichkeit. Dabei beginnt es nicht bei null: Das zuvor Gelernte dient als Ausgangspunkt.
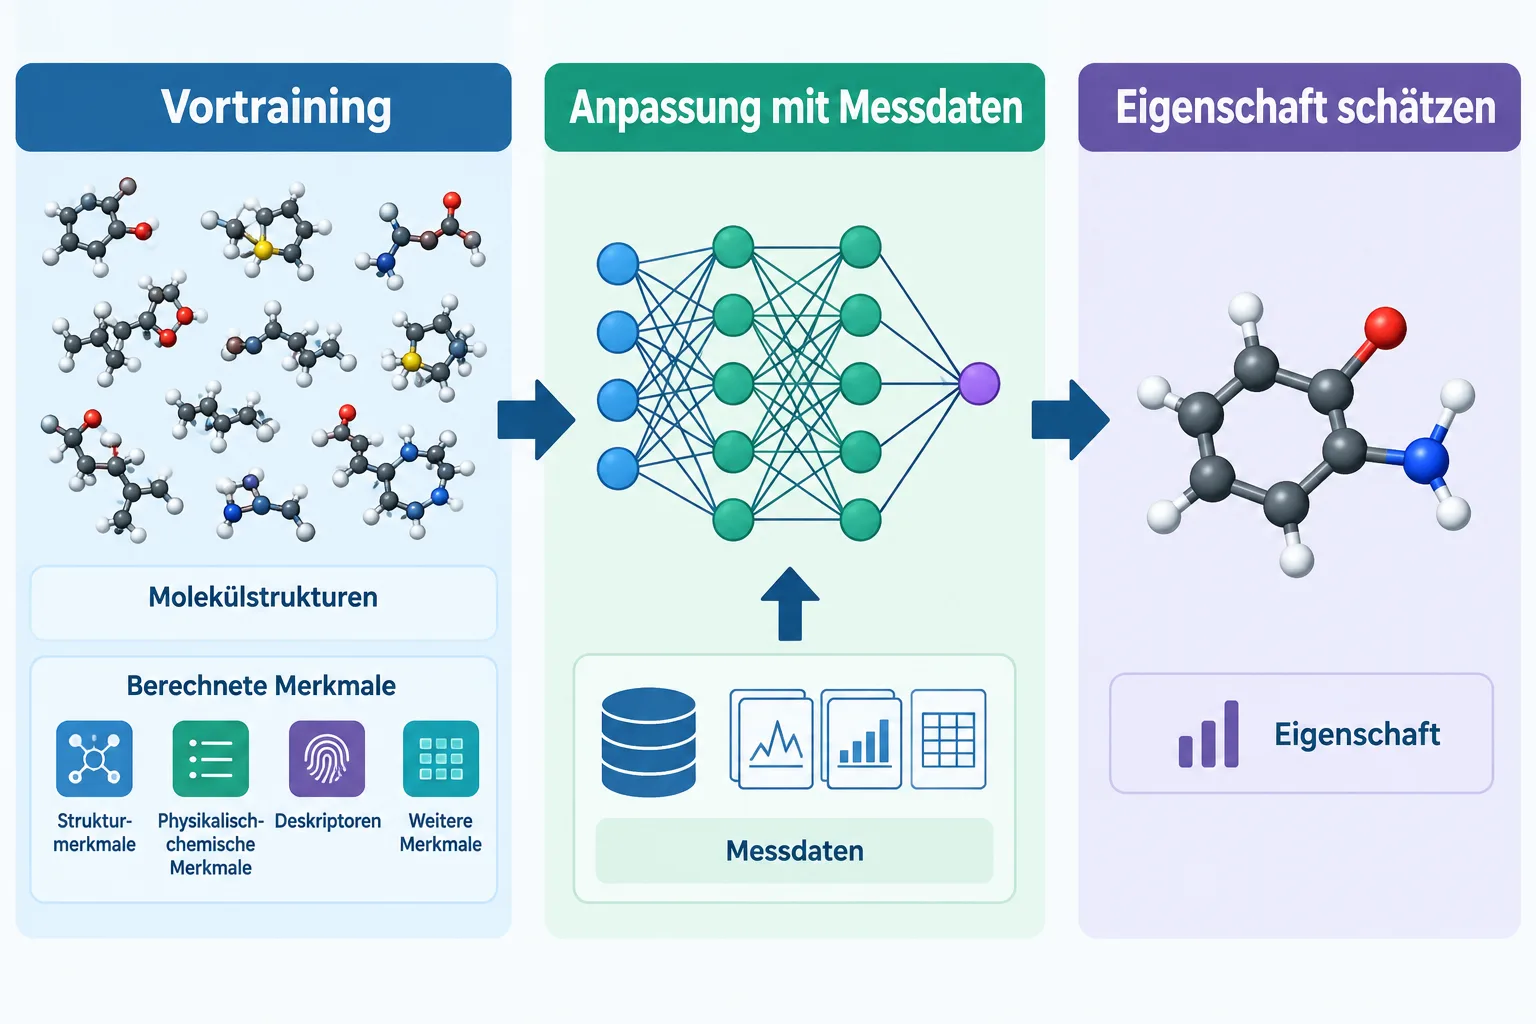
Der Ausdruck „wenige Daten“ bezieht sich damit auf die spätere Aufgabe, nicht auf das gesamte Training. Das Vortraining verwendet eine große Zahl von Molekülstrukturen. Der Unterschied ist, dass die dafür genutzten Merkmale berechnet werden können und nicht alle einzeln im Labor gemessen werden müssen.
Was der Vergleich zeigt
In der Studie prüfte das Team Datensätze zu Eigenschaften kleiner Moleküle, die für die Wirkstoffsuche relevant sind. Als Vergleich dienten unter anderem sogenannte Random-Forest-Verfahren. Sie kombinieren viele Entscheidungsbäume und sind eine etablierte Methode, um aus Merkmalen Vorhersagen abzuleiten.
Das Ergebnis spricht für den Ansatz unter den untersuchten Bedingungen. Es sagt aber nicht, dass jede einzelne Vorhersage stimmt oder dass CheMeleon bei jeder denkbaren chemischen Aufgabe das beste Werkzeug ist. Die 58 Datensätze bilden bestimmte Fragestellungen ab; andere Moleküle und Eigenschaften können neue Schwierigkeiten mitbringen.
Ein Beispiel dafür sind kleine Änderungen an einer Molekülstruktur, die eine große Änderung der biologischen Aktivität bewirken. Eine frühere Fassung der Forschungsarbeit beschreibt solche Aktivitätssprünge als schwierige Aufgabe für die getesteten Modelle. Für die praktische Auswahl bleibt deshalb entscheidend, wie gut ein Modell zur jeweiligen Fragestellung passt.
Eine Vorauswahl für das Labor
Der mögliche Nutzen liegt vor allem darin, aus vielen Kandidaten eine kleinere Auswahl für die nächste Untersuchung zu machen. Eine Schätzung der Löslichkeit oder biologischen Aktivität ist noch kein Nachweis dafür, dass ein Stoff als Medikament wirkt oder sicher ist. Dafür braucht es weitere experimentelle Prüfungen.
Das Team hat Modell und Trainingsrahmen offen veröffentlicht. Forschende können CheMeleon über das ebenfalls offene Chemprop-Paket nutzen und für eigene Aufgaben anpassen. Ob es im konkreten Projekt Arbeit spart, hängt davon ab, welche Messdaten vorliegen und wie zuverlässig die Vorhersage für die gesuchte Eigenschaft ist.
Quellen
- Burns, Zalte und weitere: Deep Learning Foundation Models for Low-Data Regimes from Classical Molecular Descriptors, Journal of Chemical Information and Modeling, 2026
- MIT News: How to predict the behavior of molecules from scant data, 6. November 2026
- Burns, Zalte und weitere: Descriptor-based Foundation Models for Molecular Property Prediction, frühere Preprint-Fassung
Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft.