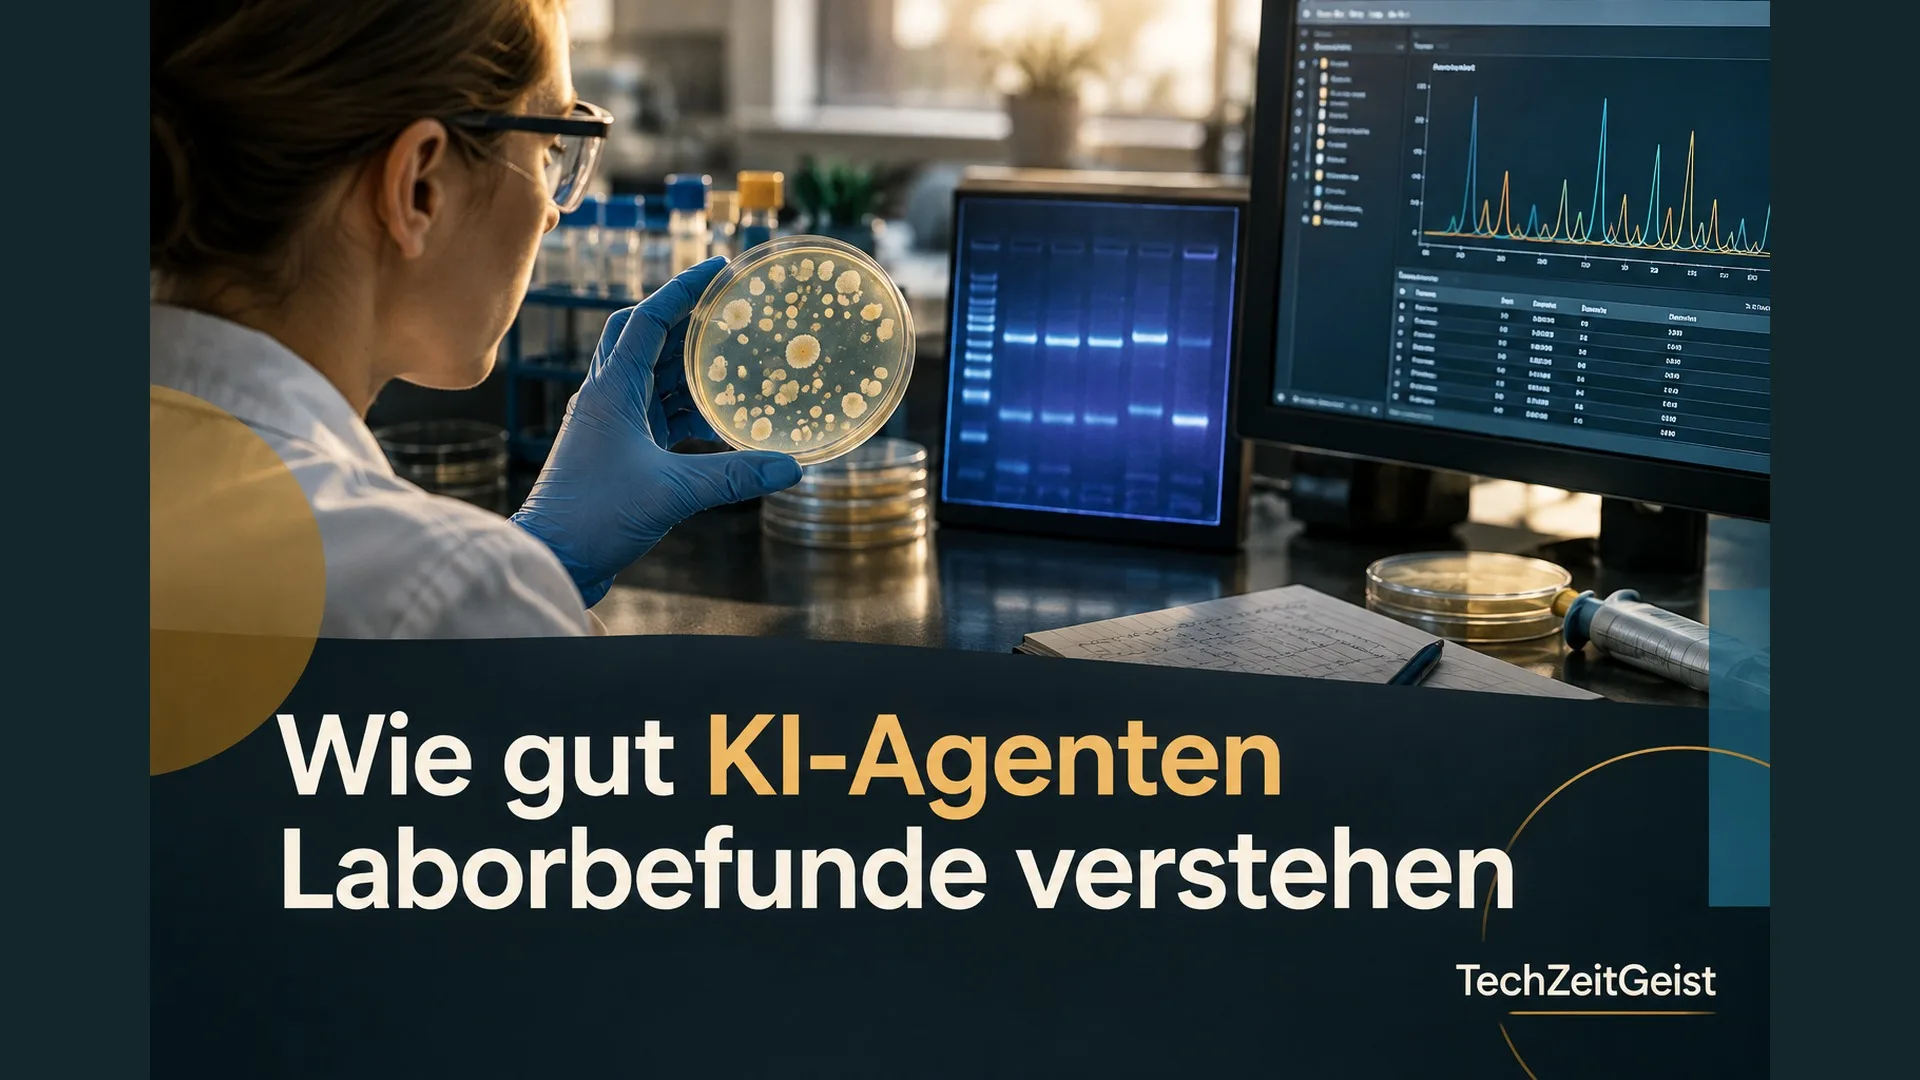
Ein Bild einer Petrischale, ein Gel mit leuchtenden Banden oder eine Messdatei: Wer solche Laborbefunde auswertet, muss mehr erkennen als ein hübsches Diagramm. Ein neuer Test von OpenAI und dem Biotechnologieunternehmen Ligo soll zeigen, wie gut KI-Agenten mit genau diesen Rohdaten umgehen. Er heißt BioBasicsBench und umfasst 100 Aufgaben aus dem Laboralltag.
Das Ergebnis: Das Modell GPT-6 Astra erreichte nach Angaben von OpenAI bei hoher Rechenintensität durchschnittlich 66,7 Prozent der möglichen Bewertungspunkte. Der Test zeigt zugleich konkrete Fehler: Das Modell zählte auf einer Platte Kolonien falsch und ordnete in einem anderen Beispiel Versuchsergebnisse den falschen Proben zu.
Warum rohe Daten eine andere Aufgabe stellen
Ein fertiges Schaubild in einer Veröffentlichung zeigt meist bereits ausgewählte und aufbereitete Ergebnisse. Im Labor liegen oft zunächst Bilder, Tabellen oder Geräteausgaben vor. Eine Fachperson muss entscheiden, was darauf zu sehen ist, ob Kontrollen funktionieren und ob die Daten überhaupt eine Schlussfolgerung zulassen.
Genau diese Auswertung steht im Mittelpunkt des neuen Benchmarks. Die Aufgaben stammen laut OpenAI aus Experimenten von Wissenschaftlern. Sie betreffen unter anderem Proteinmethoden, Mikroskopie, Messverfahren, Nukleinsäuren und molekulares Klonieren. Als Material dienen beispielsweise Gelbilder, Fotos von Kolonieplatten, Mikroskopaufnahmen und Messdateien. Eine Aufgabe kann mehrere Arten von Daten verbinden.
Ein Gelbild zeigt etwa Banden, anhand derer Forschende Proben vergleichen. Eine Kontrollprobe dient dabei als Bezugspunkt: Sie hilft einzuordnen, welches Muster zu erwarten ist. Die KI muss also nicht nur eine Bande erkennen, sondern sie im Zusammenhang mit der Frage und dem Versuch lesen.
Wie die Antworten bewertet werden
Zu jeder Aufgabe gibt es fachlich formulierte Bewertungskriterien. Sie berücksichtigen je nach Aufgabe etwa das Ergebnis, eine Messzahl, die Begründung oder die Einsicht, dass der Befund keine sichere Antwort erlaubt. Auch eine teilweise richtige Antwort kann Punkte erhalten. Laut OpenAI wurden Aufgaben und Kriterien intern sowie durch eine externe Person mit Promotion und Laborerfahrung geprüft.
OpenAI prüfte sieben eigene Modelle in insgesamt 37 Kombinationen aus Modell und Einstellung. Jede der 100 Aufgaben wurde pro Kombination fünfmal bearbeitet. Daraus entstanden 18.500 bewertete Antworten. Die Einstellung „xhigh“ erlaubt dem Modell mehr Rechenaufwand für seine Antwort; sie war die höchste für alle sieben Modelle gemeinsam ausgewiesene Stufe.
Bei dieser Einstellung erzielte GPT-6 Astra im Mittel 66,7 Prozent der möglichen Punkte. Für GPT-6.1 Sol meldet OpenAI 62,0 Prozent, für GPT-5.6 Sol 43,8 Prozent. Das sind durchschnittliche Bewertungen einschließlich Teilpunkten. Daraus lässt sich nicht ablesen, wie viele Aufgaben ein Modell vollständig richtig gelöst hat.
Ein richtiger Blick kann zur falschen Entscheidung führen
Besonders aufschlussreich sind die von OpenAI beschriebenen Fehler. In einem Beispiel erkannte Astra zwei Gruppen von Banden, verknüpfte sie aber mit einer falschen Annahme. Im Vergleich mit den Kontrollproben hätte eine andere Gruppe ausgewählt werden müssen. Das Modell sah also einen Teil des Musters richtig und kam trotzdem zur falschen Entscheidung.
Auf einer anderen Platte übersah es sichtbare Kolonien, trennte nahe beieinanderliegende nicht zuverlässig und markierte stellenweise leere Flächen. Insgesamt lag seine Zählung für diese eine Platte laut OpenAI ungefähr zwölf Prozent über dem Referenzwert. Ein Zählfehler kann eine anschließende Berechnung beeinflussen; die Zahl beschreibt jedoch dieses Beispiel, keine allgemeine Fehlerquote.
Die Ergebnisse stammen vom Anbieter der getesteten Modelle, der den Benchmark mit Ligo entwickelt hat. Eine unabhängige Wiederholung der Ergebnisse ist hier nicht belegt; die veröffentlichte Tabelle enthält nur OpenAI-Modelle. Der Test bewertet Antworten auf vorgelegte Daten und zeigt nicht, dass ein Agent ein Labor selbstständig betreiben kann. Für die konkrete Frage nach der Auswertung liefert er dennoch ein anschauliches Bild: Eine plausible Antwort reicht nicht, wenn sie Kontrollen oder widersprechende Beobachtungen falsch behandelt.
Quellen
- OpenAI: Measuring how AI agents handle everyday wet-lab science, 6. November 2026.
Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft.