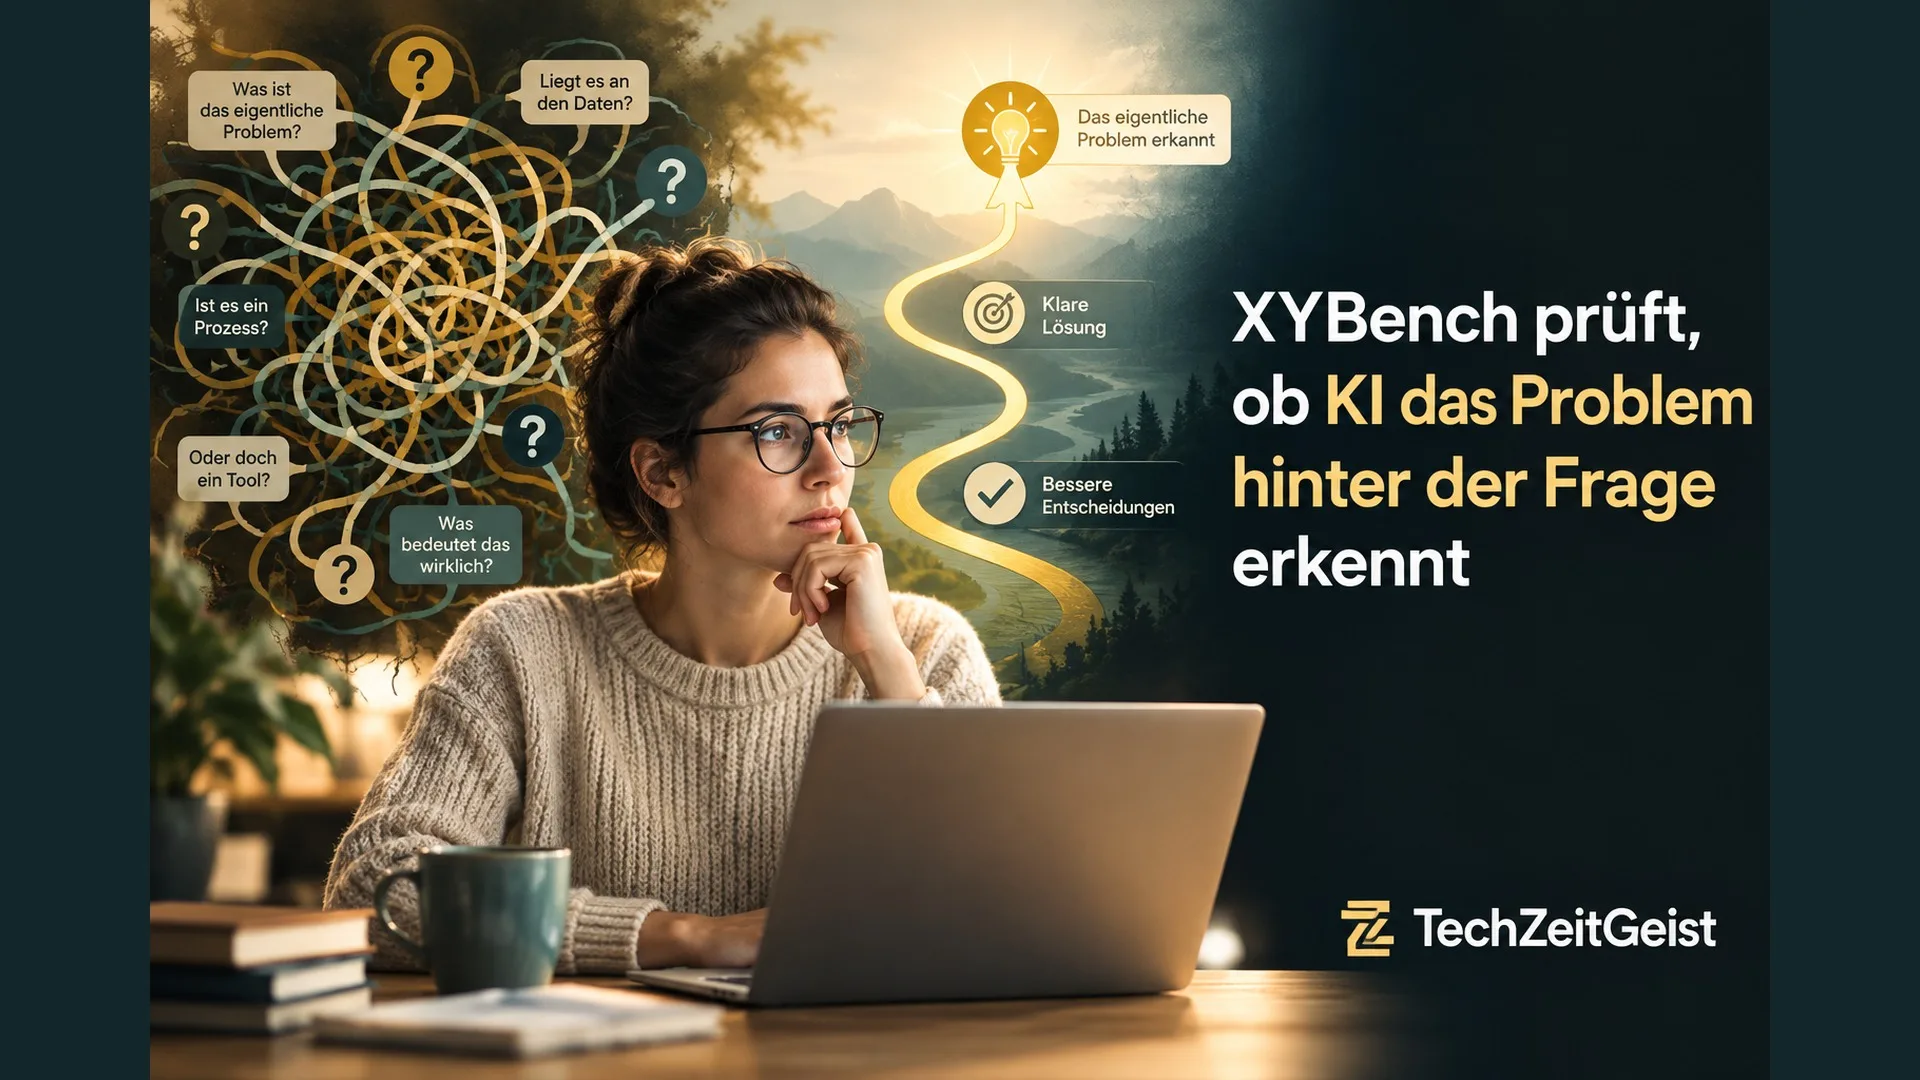
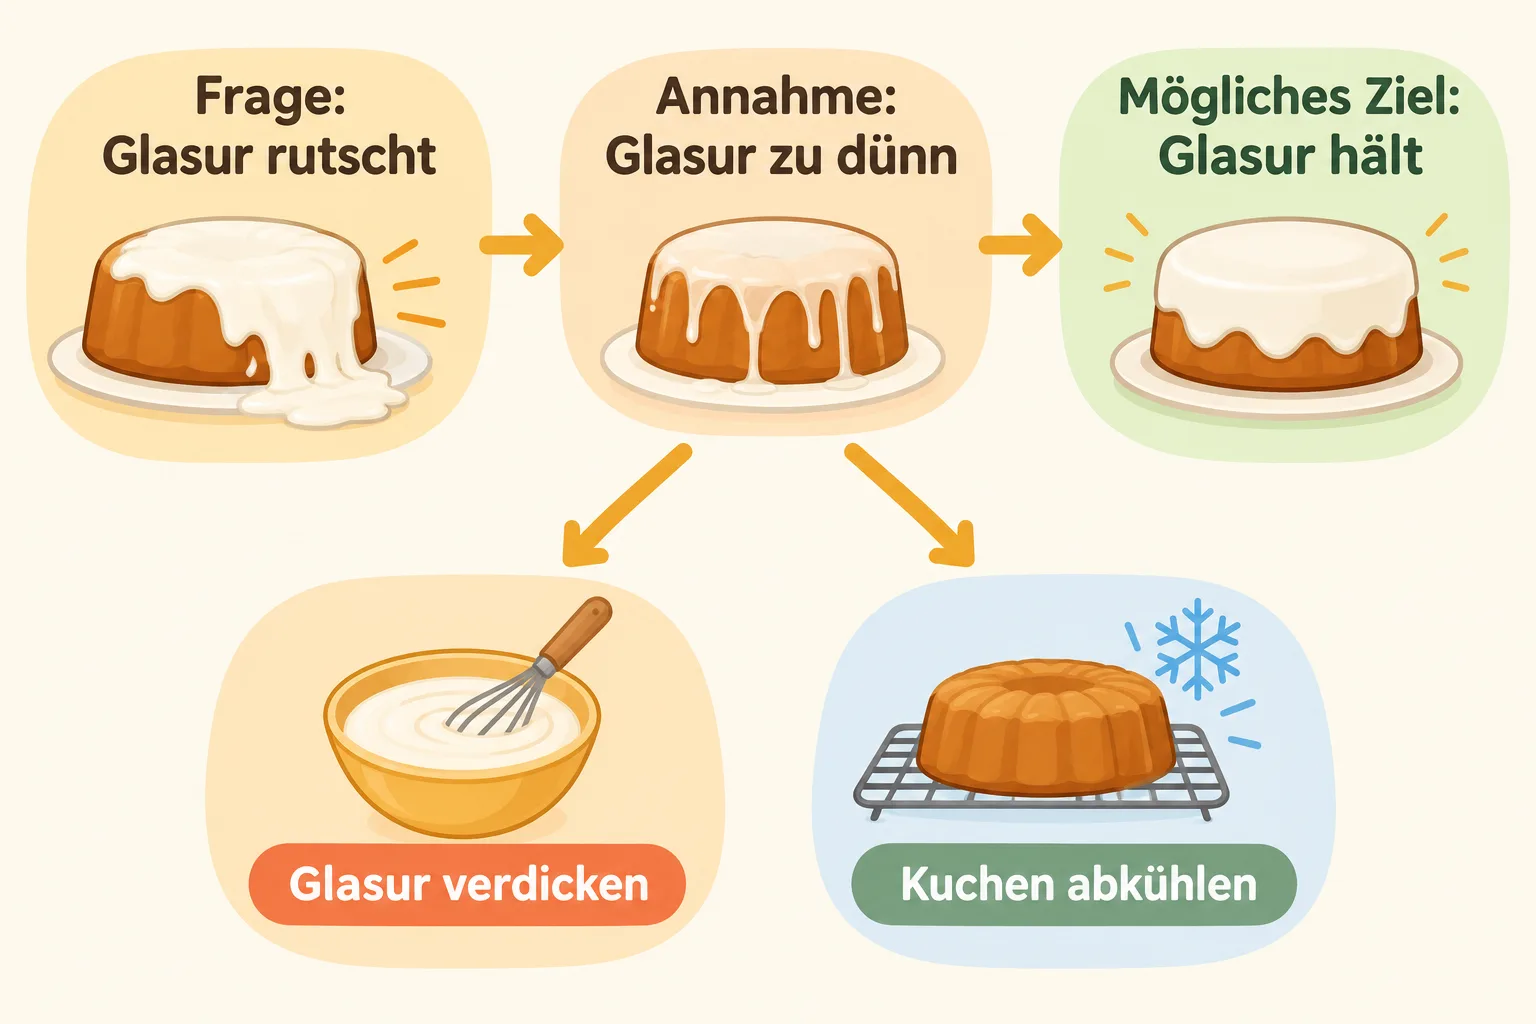
Eine Glasur rutscht vom Kuchen. Wer fragt, wie sie sich verdicken lässt, bekommt möglicherweise genau dafür eine Anleitung. Doch vielleicht ist der Kuchen noch zu warm. Ein hilfreicher Assistent müsste dann das eigentliche Ziel erkennen: Die Glasur soll halten.
Genau solche Situationen untersucht XYBench, ein am 13. November vorgestellter Test für Sprachmodelle. Das Forschungsteam um das Allen Institute for AI fand: Die getesteten Systeme gingen häufig auf die wörtliche Bitte ein, statt ihre Antwort auf das dahinterliegende Problem auszurichten. Der Befund stammt aus einem begrenzten Versuch mit englischen Fragen und einzelnen Antworten.
Die Frage hinter der Frage
Das Beispiel steht für das sogenannte XY-Problem. Jemand möchte Ziel X erreichen, hält Vorgehen Y für die richtige Lösung und fragt nur nach Y. Wer antwortet, muss aus dem Zusammenhang erschließen, ob der vorgeschlagene Weg tatsächlich zum Ziel führt. Beim Kuchen könnte das Verdicken helfen; wenn aber Wärme die Ursache ist, wäre Abkühlen der passendere Ansatz.
Das ist auch bei technischen Fragen relevant. Die Originalstudie nennt als Beispiel die Suche nach einer Methode, XML mit regulären Ausdrücken zu verarbeiten. Die wörtliche Frage betrifft ein bestimmtes Werkzeug; das eigentliche Ziel könnte sein, strukturierte Daten zuverlässig einzulesen. Eine Antwort kann deshalb erklären, warum ein dafür vorgesehener Parser geeigneter sein kann.
Was der Test misst
XYBench enthält 8.115 englischsprachige Fragen aus Programmierung und Alltag. Davon stammen 1.557 von Stack Overflow und 184 aus Stack Exchange, 102 wurden von Hand zusammengestellt. Weitere 6.272 Fragen wurden mithilfe eines Sprachmodells aus WikiHow-Anleitungen erzeugt. Es handelt sich also überwiegend um synthetische Fragen und nicht ausschließlich um tatsächlich gestellte Anfragen.
Das Team unterscheidet drei Dinge: Nennt eine Antwort überhaupt eine Lösung für das genannte Vorgehen oder für das zugrunde liegende Ziel? Welcher Lösung widmet sie den Schwerpunkt? Und führt sie von der fehlerhaften Annahme weg? Ein kurzer Hinweis auf eine bessere Alternative reicht für die zweite Frage nicht aus, wenn der Rest der Antwort den ungeeigneten Weg ausführlich erklärt.
Für die Bewertung nutzte das Team Claude Sonnet 4.5 als automatisierten Beurteiler. Zwei Menschen prüften unabhängig davon 500 Modellantworten. Laut Projektbeschreibung stimmten ihre Urteile bei der Frage, ob eine Lösung vorkam, häufiger mit dem automatischen Urteil überein als bei der Einschätzung, worauf die Antwort ihren Schwerpunkt legte. Gerade diese Gewichtung ist also schwieriger eindeutig zu beurteilen.
Eine bessere Antwort erkennen und schreiben
Die Forschenden testeten fünf Modelle, darunter GPT-5, Claude Sonnet 4.6 und Gemini 3.1 Pro, mit jeweils einer Antwort pro Frage. Bei den Stack-Overflow-Fragen lag das zugrunde liegende Ziel laut Projektbericht in 35 bis 41 Prozent der Antworten im Mittelpunkt. Die wörtliche Bitte dominierte in 47 bis 57 Prozent; die übrigen Antworten gewichteten beide Seiten ähnlich.
In einem weiteren Versuch sollten Modelle zwischen zwei bereits vorgegebenen Antworten wählen. Dabei entschieden sie sich häufig für die Antwort, die das eigentliche Ziel aufgriff. Das zeigt einen Unterschied zwischen dem Erkennen einer hilfreichen Antwort in dieser Auswahl und dem selbstständigen Formulieren einer solchen Antwort. Die Tests erlauben aber keine pauschale Aussage darüber, wie dieselben Systeme in längeren Gesprächen reagieren.
Das Team gab außerdem in einem Versuch das vermutete Ziel ausdrücklich vor. Das half in manchen Fällen, eine passende Lösung überhaupt zu nennen, beseitigte den Abstand zu menschlichen Referenzantworten jedoch nicht durchgehend. Ein klar formuliertes Ziel ist damit eine Hilfe, aber im Test keine Garantie für die passende Gewichtung.
Was die Ergebnisse offenlassen
Die Arbeit wurde bereits im September als Studie eingereicht und für die Konferenz EMNLP 2026 angenommen; neu ist der Projektbeitrag mit seiner Vorstellung des Tests. Die Fragen betreffen überwiegend praktische Abläufe und liegen auf Englisch vor. Andere Sprachen, kulturelle Zusammenhänge und Gespräche mit Rückfragen sind laut Team weitere Forschungsfelder.
Für die Nutzung eines Assistenten liegt der praktische Gedanke nahe: Neben dem vermuteten Lösungsweg auch das gewünschte Ergebnis und die beobachteten Umstände zu nennen, gibt dem System mehr Kontext. Ob seine Antwort zur konkreten Situation passt, muss dennoch anhand der tatsächlichen Umstände geprüft werden.
Quellen
- Allen Institute for AI: XYBench: Helping with the problem behind the question, 13. November 2026.
- Yerukola et al.: XYBench: Can LLMs Respond Pragmatically to Queries with Misconceptions?, 6. September 2026.
Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft.