Websites sollen ihren Wunsch zum KI-Training künftig mit einem gemeinsamen Eintrag ausdrücken können. OpenAI kündigte am 30. Oktober an, ein solches Signal in der Datei robots.txt zu berücksichtigen. Die Umsetzung plant das Unternehmen für die kommenden Monate; ein genaues Datum nennt es nicht.
Für Betreiber könnte das weniger Einzelregeln bedeuten. Bislang müssen sie häufig für die Crawler verschiedener Anbieter eigene Angaben pflegen. Ein gemeinsames Signal soll dieselbe Trainingspräferenz an mehrere teilnehmende Anbieter vermitteln. Ob es wirkt, hängt davon ab, ob der jeweilige Anbieter es unterstützt und beachtet.
Eine bekannte Datei für eine neue Frage
Die robots.txt ist eine Textdatei, mit der ein Website-Betreiber automatisierten Besuchern Regeln für den Zugriff mitteilen kann. Solche Programme, Crawler genannt, rufen Seiten ab und sammeln deren Inhalte. Ein Eintrag kann etwa erklären, welche Bereiche ein bestimmter Crawler auslassen soll.
Die neue Idee stellt eine andere Frage: Soll ein Inhalt zum Training eines generativen KI-Modells verwendet werden? Beim Training werden gelernte Parameter eines Modells verändert. Eine Nutzungspräferenz dafür und eine Regel für den Seitenzugriff sind zwei unterschiedliche Angaben, auch wenn beide in derselben Datei stehen können.
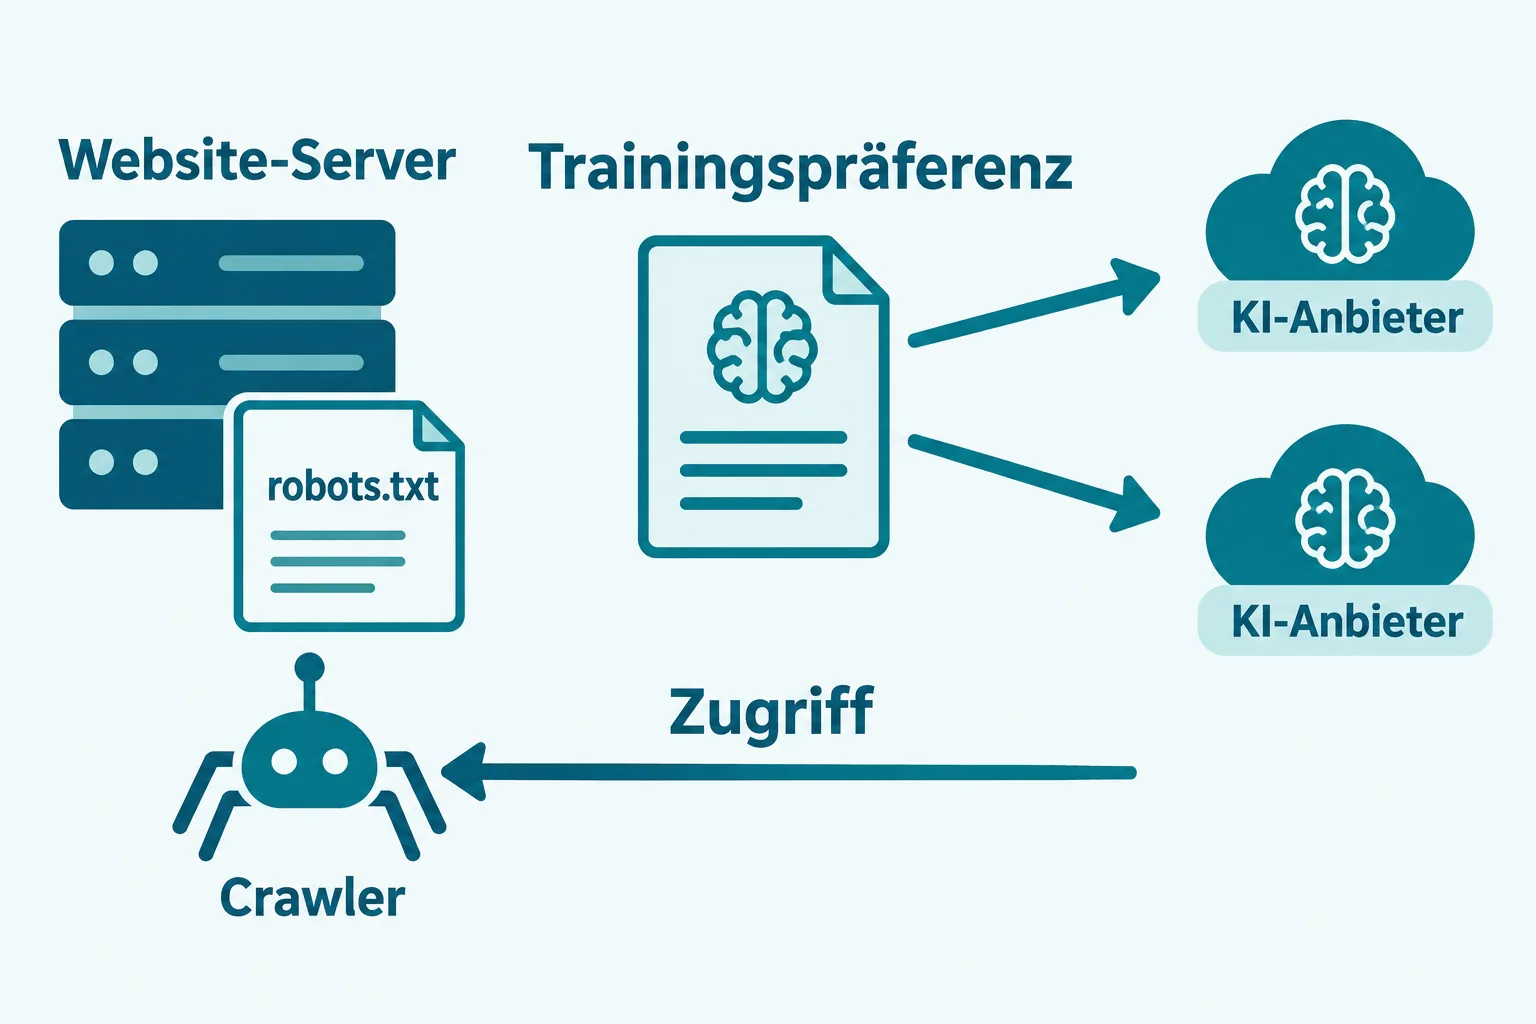
So soll der Eintrag funktionieren
Ein am 30. Oktober veröffentlichter technischer Entwurf schlägt eine Gruppe mit der Kennung __usage_ai-training vor. Sie verwendet die bekannten Angaben Disallow und Allow. So könnte ein Betreiber beispielsweise die Nutzung für das Training grundsätzlich ablehnen, für einen ausdrücklich genannten Bereich aber erlauben.
Die Angabe lässt sich laut Entwurf auf einzelne Pfade beziehen. Eine Redaktion könnte also für einen Teil ihres Angebots eine andere Präferenz ausdrücken als für den Rest. Fehlt die spezielle Kennung, ist nach diesem Entwurf über das gemeinsame Signal keine Präferenz erklärt. Eine allgemeine Regel für alle Crawler wird dafür nicht automatisch als solche gelesen.
Das Signal selbst ist keine Anweisung, den Abruf einer Seite zu unterlassen. Wer den Zugriff eines bestimmten Crawlers beschränken möchte, kann dafür weiterhin dessen eigene Regeln verwenden. OpenAI erklärt, dass seine bisherigen Crawler-Einstellungen bestehen bleiben sollen.
Was die Ankündigung noch offenlässt
Der Vorschlag ist ein individueller Internet-Draft. Solche Dokumente sind Arbeitsstände und können sich ändern; die Veröffentlichung auf der IETF-Plattform macht ihn noch nicht zu einem verabschiedeten Standard. Der Entwurf knüpft an die laufende Arbeit der IETF-Gruppe zu KI-Nutzungspräferenzen an.
OpenAI beschreibt die Beteiligung als freiwillig und will später Details zur eigenen Umsetzung veröffentlichen. Aus der Ankündigung folgt weder, dass bereits alle Anbieter das Signal beachten, noch dass ein Eintrag die Nutzung technisch verhindert. Auch private Vereinbarungen können laut Entwurf Vorrang vor den dort ausgedrückten Präferenzen haben.
Für Website-Betreiber ist der praktische Unterschied damit klar: Der neue Eintrag soll eine Trainingsentscheidung einheitlicher lesbar machen. Die bisherigen Regeln für einzelne Crawler bleiben daneben relevant, und die tatsächliche Wirkung hängt von der Umsetzung der beteiligten Dienste ab.
Quellen
- OpenAI: Making it easier for websites to express AI training preferences, 30. Oktober 2026
- Kevin Kelley: Machine-Readable Training Preference Signal, Internet-Draft, 30. Oktober 2026
- OpenAI: Overview of OpenAI Crawlers
Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft.