Was antwortet ein Chatbot, wenn Menschen ihn nach einer Wahl fragen? Ein Forschungsteam am Massachusetts Institute of Technology (MIT) sammelt dazu Antworten verschiedener KI-Systeme auf Fragen zu den US-Zwischenwahlen 2026. Das öffentliche „LLM Election Observatory“ soll sichtbar machen, wie sich Antworten zwischen Systemen und über die Zeit unterscheiden.
Das Team stellt den Chatbots wiederholt einen festen Satz von Fragen. Dabei verändert es auch Angaben über die fragende Person, etwa ihren Wohnort oder ihre Parteizugehörigkeit. Die Antworten und vorläufige Auswertungen erscheinen in einem Dashboard, berichten die beteiligten Forschenden in einem MIT-Interview vom 30. Oktober.
Gleiche Frage, unterschiedliche Antwort?
Die untersuchten Fragen betreffen unter anderem Wahlinformationen, die Bestätigung von Ergebnissen, politische Streitthemen und die Berichterstattung. Alle paar Tage stellt das Team die Fragen erneut. So entsteht eine Reihe von Momentaufnahmen: Eine Antwort von heute kann später neben einer Antwort auf dieselbe Frage stehen.
Das ist deshalb interessant, weil sich nicht nur die Nachrichtenlage ändert. Auch KI-Modelle werden aktualisiert, und ihre Antworten können davon abhängen, wie eine Frage formuliert ist oder welche Informationen die fragende Person mitliefert. Ohne eine laufende Sammlung wäre später schwer nachzuvollziehen, welche Antwort zu einem bestimmten Zeitpunkt gegeben wurde.
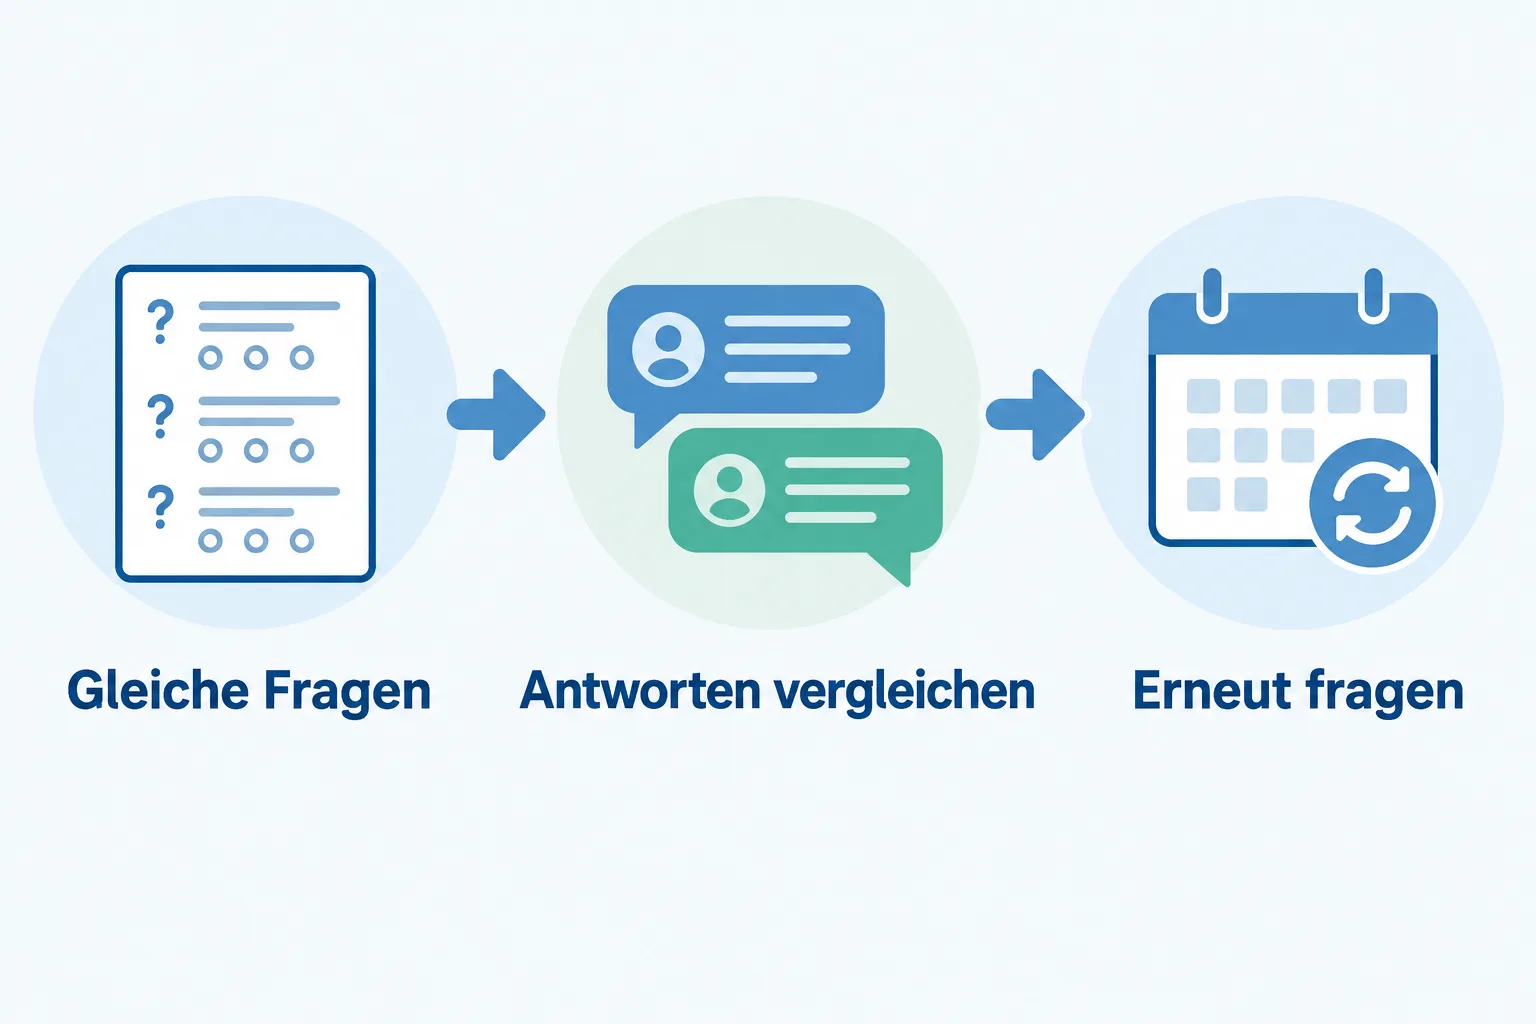
Ein Beispiel für den Versuchsaufbau: Wird dieselbe Wahlfrage einmal mit und einmal ohne eine angegebene Parteizugehörigkeit gestellt, können Forschende die Antworten nebeneinanderlegen. Das beschreibt den Test, nicht das Ergebnis für jede einzelne Frage. Neben möglichen sachlichen Fehlern interessieren sie sich für die Auswahl der Quellen, den Ton und dafür, welche Aspekte eine Antwort betont.
Warum auch die Darstellung zählt
Zwei Antworten können dieselben Fakten enthalten und trotzdem unterschiedliche Schwerpunkte setzen. Eine könnte eine Unsicherheit ausführlicher erklären, eine andere stärker auf eine bestimmte Quelle verweisen. Das Projekt soll solche Unterschiede beobachtbar machen, die in einzelnen privaten Chats sonst schwer zu vergleichen wären.
Die Forscherin Chara Podimata berichtet dem MIT zufolge von ersten Unterschieden in Darstellung, Ton und zitierten Quellen bei verschiedenen vorgegebenen Nutzeridentitäten. Die vollständige Auswertung über den Verlauf des Wahlkampfs steht aber noch aus. Ob die beobachteten Unterschiede stabil sind und wie reale Menschen darauf reagieren, kann das Team nach eigener Aussage derzeit nicht beantworten.
Eine auffällige Antwort im Dashboard ist deshalb zunächst ein einzelner Datenpunkt. Sie zeigt nicht automatisch, dass ein System alle Menschen gleich behandelt oder dass eine Person dadurch ihre Wahlentscheidung ändert. Für solche Aussagen wären weitere Untersuchungen nötig.
Aufbauend auf der Wahl 2024
Die Arbeit knüpft an eine frühere Studie zur US-Präsidentschaftswahl 2024 an. Für diese untersuchte ein Forschungsteam zwölf Sprachmodelle mit mehr als 12.000 Fragen, die von Juli bis November 2024 nahezu täglich gestellt wurden. Die 2025 als Preprint veröffentlichte Arbeit betrachtet unter anderem Veränderungen über die Zeit und die Empfindlichkeit gegenüber unterschiedlichen Vorgaben.
Die neue Sammlung richtet den Blick auf die Zwischenwahlen 2026, bei denen neben landesweiten Themen zahlreiche einzelne Wahlkämpfe eine Rolle spielen. Das Team möchte Daten und vorläufige Analysen schon während des Wahlzeitraums zugänglich machen und die Sammlung für weitere Forschung bereitstellen.
Was Nutzer daraus mitnehmen können
Ein Chatbot kann eine Antwort flüssig und bestimmt formulieren, auch wenn sie unvollständig oder falsch ist. MIT-Politikwissenschaftler Adam Berinsky rät deshalb, bei Wahlfragen nicht bei einer solchen Antwort stehen zu bleiben. Wer etwa Fristen oder Regeln zum Wählen wissen möchte, sollte die zuständige Wahlbehörde als Quelle prüfen.
Das Observatorium liefert dafür keine individuelle Wahlberatung. Es schafft eine Grundlage, um die Antworten verschiedener Systeme und Zeitpunkte zu untersuchen. Welche längerfristigen Muster darin stecken, muss die laufende Auswertung erst zeigen.
Quellen
- MIT News: Q&A: Hey AI, who should I vote for this year?, 30. Oktober 2026.
- Cen und weitere: Large-Scale, Longitudinal Study of Large Language Models During the 2024 US Election Season, Preprint, 2025.
Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft.