Wenn ein KI-Modell neue Übungsaufgaben für ein anderes Modell erzeugt, kann das dessen Fähigkeiten verbessern. Werden dagegen ursprüngliche Trainingsdaten über mehrere Generationen hinweg durch maschinell erzeugte Ausgaben ersetzt, kann Information verloren gehen. Beide Ergebnisse stammen aus der Forschung. Sie widersprechen sich nicht: Die Daten übernehmen unterschiedliche Aufgaben, und sie werden unterschiedlich verwendet.
Der Unterschied ist für eine Debatte über die Zukunft der KI zentral. Oft steht die Frage im Raum, ob Maschinen irgendwann vor allem aus ihren eigenen Erzeugnissen lernen. Doch schon vorher lohnt sich ein genauerer Blick: Welche Originaldaten bleiben erhalten? Werden künstliche Beispiele geprüft und gezielt ausgewählt? Und soll ein Modell zunächst allgemeine Muster lernen oder anschließend eine bestimmte Aufgabe besser lösen?
Was synthetische Daten beim Lernen tun
Trainingsdaten sind Beispiele, aus denen ein Modell statistische Zusammenhänge ableitet. Bei einem Sprachmodell können das Texte sein; bei einem System, das Bilder und Sprache verbindet, etwa Bilder mit zugehörigen Beschreibungen und Fragen. Das Modell speichert nicht einfach eine Liste richtiger Antworten. Es passt seine internen Einstellungen so an, dass es in den Trainingsbeispielen auftretende Muster besser verarbeitet.
Synthetisch heißen Beispiele, wenn sie künstlich erzeugt werden. Ein Modell kann etwa Fragen und Antworten zu einem Bild formulieren. Solche Beispiele sind nicht automatisch richtig oder falsch. Ihre Qualität hängt davon ab, wie sie entstehen, ausgewählt und eingesetzt werden. Besonders nützlich können sie sein, wenn sie gezielt eine Lücke im Übungsmaterial adressieren.
Genau diesen Ansatz untersuchte eine 2026 veröffentlichte AAAI-Arbeit für Systeme, die Bild und Sprache gemeinsam verarbeiten. Die Forschenden erzeugten und filterten Beispiele, die auf Fehler bei untersuchten Aufgaben zugeschnitten waren. Das anschließende Nachtraining verbesserte die Ergebnisse bei den getesteten multimodalen Aufgaben. Der Datensatz umfasste mehr als 553.000 Beispiele.
Nachtraining bedeutet hier: Ein bereits vorhandenes Modell erhält zusätzliche Übungen, um sein Verhalten bei bestimmten Aufgaben zu verändern. Die Studie sagt also etwas über diese Art der gezielten Verbesserung. Sie zeigt nicht, dass ein Modell unbegrenzt ohne ursprüngliche Daten immer besser wird.
Wenn jede Generation die vorherige kopiert
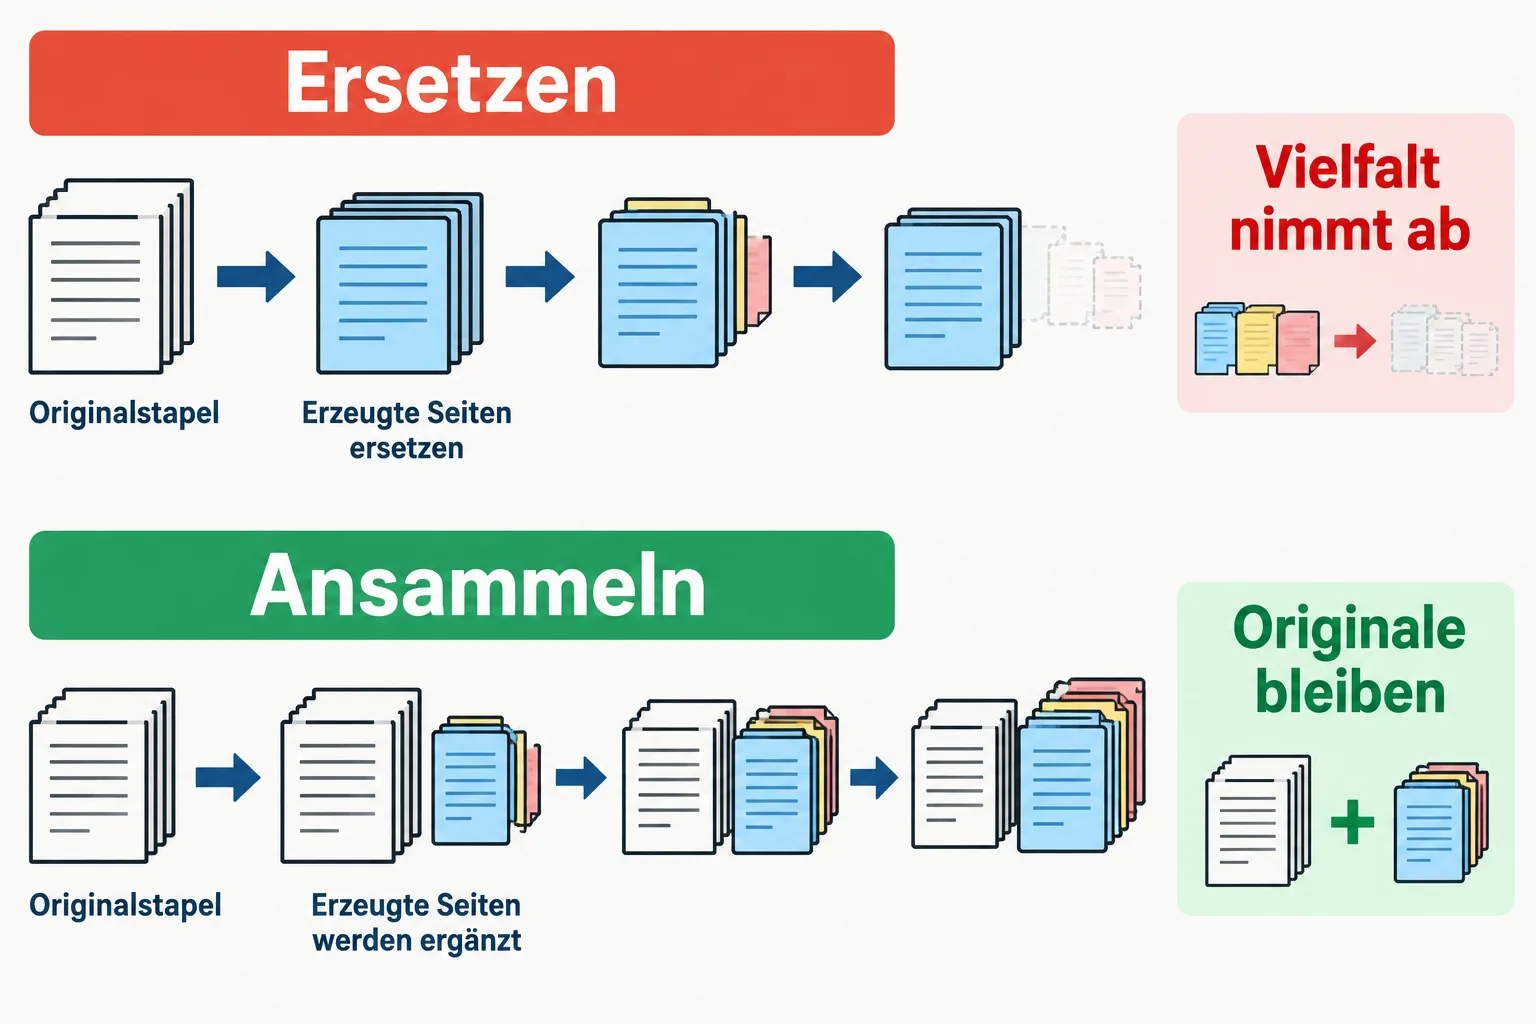
Ein anderer Versuchsaufbau führt zu einem anderen Problem. Stellen wir uns eine Sammlung von Texten vor, in der häufige und seltene Ausdrucksweisen vorkommen. Ein Modell lernt aus dieser Sammlung und erzeugt neue Texte. Diese Ausgaben ersetzen die ursprüngliche Sammlung. Die nächste Modellgeneration lernt nur noch aus den erzeugten Texten und produziert wiederum Material für ihren Nachfolger.
Schon die erste Erzeugung bildet die Ausgangsdaten nicht vollkommen ab. Seltene Varianten können dabei unterrepräsentiert sein. Wenn jede Runde nur auf der vorherigen aufbaut, können solche Verluste weitergetragen werden. Was einmal fehlt, lässt sich aus der nachfolgenden Kopie allein nicht zuverlässig zurückholen.
Die Forschungsgruppe um Ilia Shumailov untersuchte dieses Phänomen als Modellkollaps. In ihren Experimenten verschwanden bei rekursivem Training zunächst seltene Teile der zugrunde liegenden Verteilung. Die Ergebnisse beschreiben die untersuchten Trainingsabläufe; sie sind keine Vorhersage, dass jedes aktuelle KI-System zwangsläufig kollabiert.
Warum das Original einen Unterschied macht
Was geschieht, wenn die ursprünglichen Daten im Training bleiben? Eine Arbeit um Matthias Gerstgrasser verglich das Ersetzen mit einem Vorgehen, bei dem synthetische Daten angesammelt und ursprüngliche Daten weiter genutzt werden. In den untersuchten Versuchen vermied das Ansammeln den beobachteten Kollaps.
Der Gedanke dahinter ist anschaulich: Bleibt die ursprüngliche Sammlung zugänglich, muss die nächste Generation nicht ausschließlich aus einer unvollständigen Kopie lernen. Sie bekommt weiterhin Beispiele aus der Quelle, aus der die Kopierkette ihren Anfang nahm. Das macht die Datenmischung zu einer wichtigen Bedingung des Experiments.
Die Gegenstudie macht aus Originaldaten allerdings keine magische Versicherung für jede denkbare Mischung. Sie zeigt, dass die Entscheidung zwischen Ersetzen und Ergänzen den beobachteten Verlauf verändern kann. Wie gut ein konkretes Training funktioniert, hängt auch davon ab, welche Daten und Modelle verwendet werden und was gemessen wird.
Übungsblatt oder neue Grundlage?
Die beiden Forschungsrichtungen betrachten damit verschiedene Situationen. Beim gezielten Nachtraining dienen künstliche Beispiele als zusätzliche Übungen für eine bereits vorhandene Fähigkeit. Im Modellkollaps-Experiment werden erzeugte Ausgaben dagegen wiederholt zur Grundlage der nächsten Modellgeneration. Der Unterschied liegt nicht allein darin, dass in beiden Fällen KI-Texte oder andere künstliche Daten vorkommen.
Ein gedachtes Beispiel macht das greifbar: Eine Lehrkraft könnte zusätzliche Aufgaben zu einem Thema erstellen, bei dem eine Klasse häufig Fehler macht. Diese Übungen ergänzen das Lehrmaterial. Würde dagegen jede neue Ausgabe eines Lehrbuchs ausschließlich aus einer unvollständigen Zusammenfassung der vorherigen entstehen, könnten Details mit jeder Überarbeitung verschwinden. Das Beispiel erklärt den Unterschied; es ist kein eigener experimenteller Nachweis.
Für die Bewertung synthetischer Daten reicht deshalb kein pauschales Urteil. Die sinnvollere Frage lautet, welche Rolle sie im Training spielen und welche unabhängige Grundlage erhalten bleibt. Die Forschung zeigt sowohl einen konkreten Nutzen sorgfältig erzeugter Übungen als auch einen Mechanismus, durch den wiederholtes Ersetzen Vielfalt verlieren kann.
Quellen
- Shumailov und Mitautoren: AI models collapse when trained on recursively generated data, 2024.
- Gerstgrasser und Mitautoren: Is Model Collapse Inevitable? Breaking the Curse of Recursion by Accumulating Real and Synthetic Data, 2024.
- AAAI: Studie zu synthetischen Beispielen für multimodales Instruction-Tuning, 2026.
Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft.