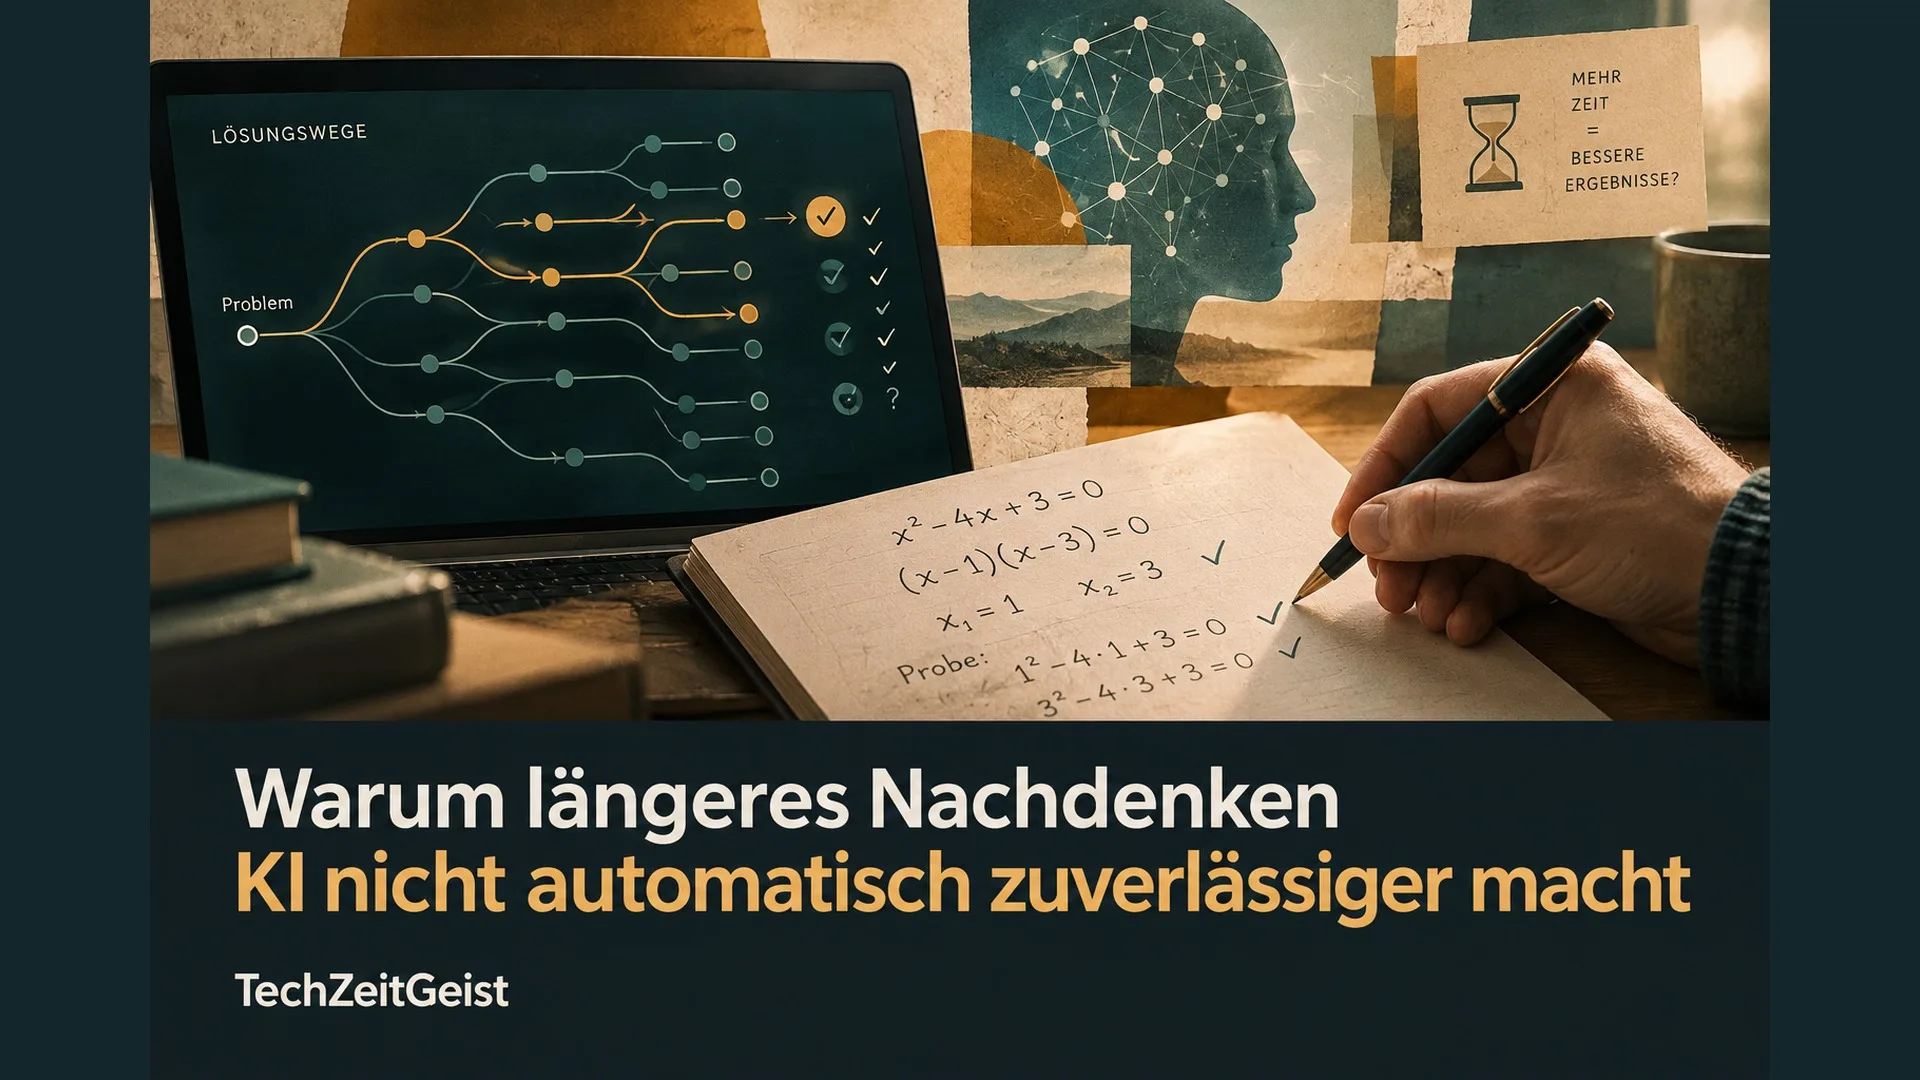
Eine KI bekommt eine schwierige Frage und braucht einige Sekunden länger für ihre Antwort. Diese zusätzliche Zeit kann helfen: Das System kann Zwischenschritte erzeugen, Alternativen untersuchen oder eine Lösung prüfen. Doch eine längere Antwortphase ist kein Gütesiegel. Gerade bei Fragen nach konkreten Fakten kann ein Modell seine erste falsche Vermutung ausführlicher begründen, statt sie zu korrigieren.
Die Entwicklung der vergangenen Jahre zeigt deshalb zwei Dinge zugleich: Mehr Rechenarbeit eröffnet neue Möglichkeiten bei schwierigen Aufgaben. Ob das Ergebnis verlässlich ist, hängt aber auch davon ab, wie die Zeit genutzt wird und ob sich die Antwort unabhängig überprüfen lässt.
Was die zusätzliche Denkzeit bewirkt
Ein Sprachmodell erzeugt Text in kleinen Einheiten, sogenannten Tokens. Bei einer direkten Antwort folgen diese Einheiten auf die Frage und bilden die Ausgabe. Bei einem Reasoning-System können vor der endgültigen Antwort zusätzliche Zwischenschritte entstehen. Das Modell kann etwa eine Aufgabe zerlegen, einen Ansatz verwerfen und einen anderen versuchen. Die internen Schritte sind je nach System nicht vollständig sichtbar.
Eine andere Möglichkeit besteht darin, mehrere Lösungswege zu erzeugen und anschließend einen auszuwählen. Das ähnelt einer Gruppe, die getrennt rechnet und ihre Ergebnisse vergleicht. Der Vergleich hilft nur, soweit die Wege tatsächlich unterschiedliche Fehler machen und die Auswahlmethode etwas über die Qualität aussagt. Stimmen mehrere Antworten überein, kann auch ein gemeinsamer Irrtum dahinterstehen.
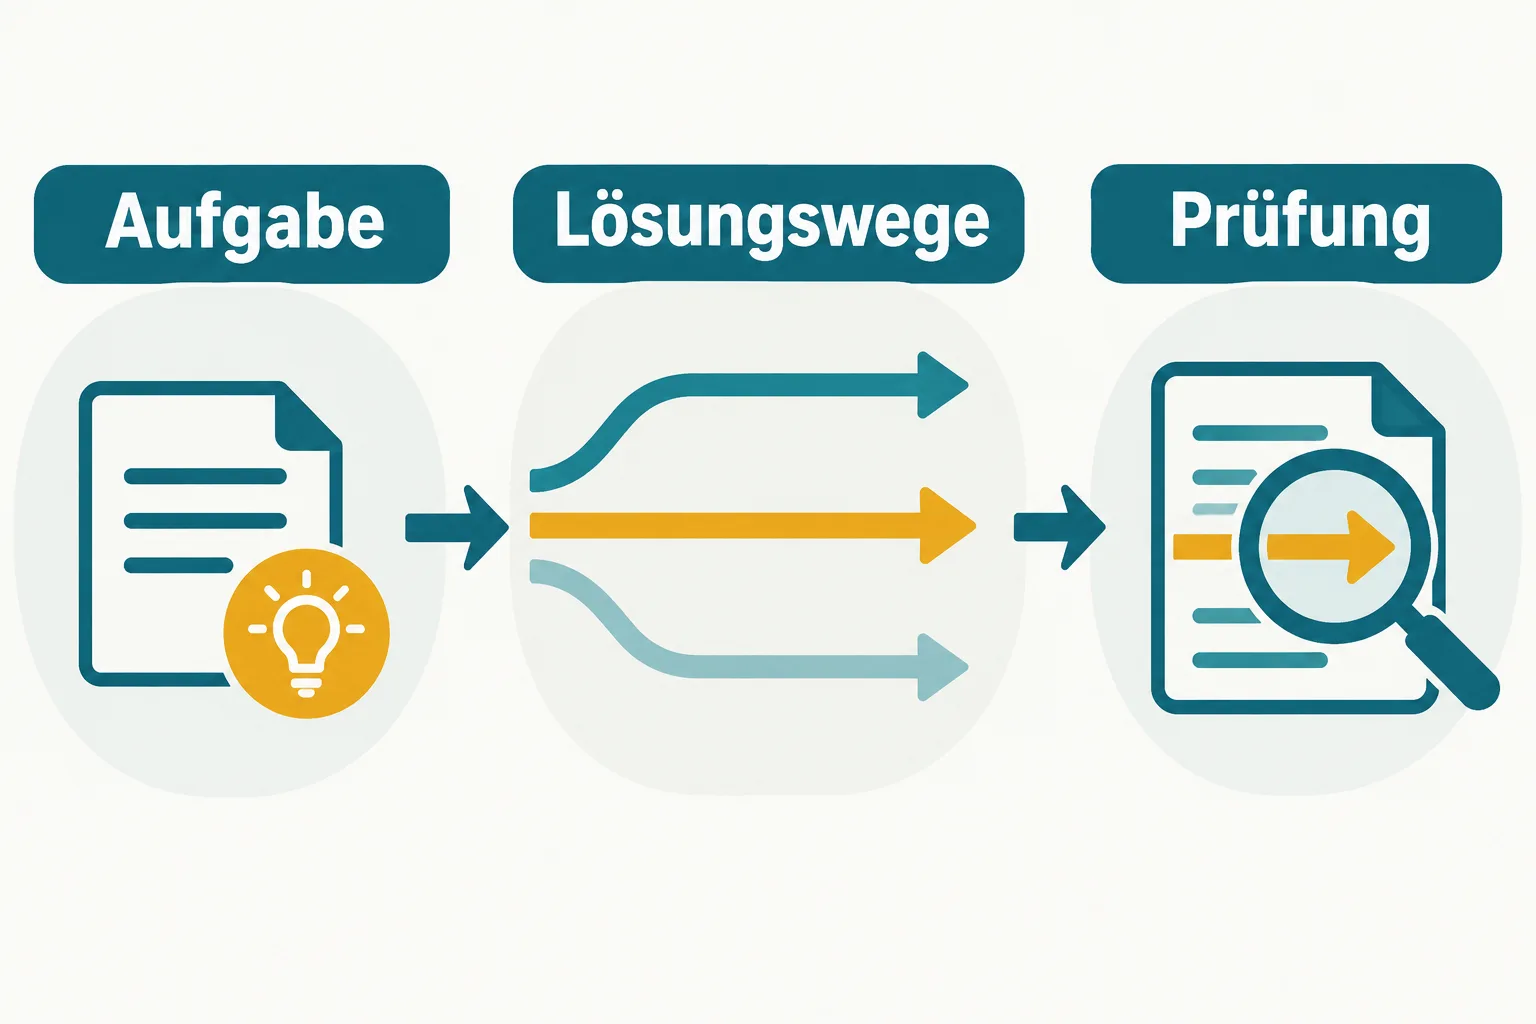
Mehr Aufwand bedeutet auch mehr Berechnungen bei der Nutzung. Er kann die Wartezeit und die Kosten erhöhen. Für eine einfache Frage ist daher nicht automatisch derselbe Aufwand sinnvoll wie für ein schwieriges mathematisches Problem. Das erklärt allerdings noch nicht, wie viel ein konkreter Dienst tatsächlich an Strom verbraucht; dafür spielen weitere technische Bedingungen eine Rolle.
Warum Mathematik zum Prüfstein wurde
Bei vielen Mathematikaufgaben lässt sich eine Antwort vergleichsweise klar bewerten. Das macht sie für Experimente attraktiv: Forschende können beobachten, wie häufig ein System unter bestimmten Bedingungen zur richtigen Lösung kommt. Solche Tests messen aber die ausgewählten Aufgaben und nicht jede Fähigkeit, die Menschen im Alltag von einer KI erwarten.
OpenAI berichtete 2024, sein Modell o1 habe in den untersuchten Aufgaben von zusätzlicher Rechenzeit profitiert. Bei den amerikanischen AIME-Mathematikprüfungen desselben Jahres löste es laut Unternehmen im Durchschnitt 74 Prozent der Aufgaben mit einer einzelnen Antwort. Wurde aus 64 Antworten ein Konsens gebildet, waren es 83 Prozent. Das sind unterschiedliche Verfahren: Die zweite Zahl beschreibt nicht einfach dieselbe Antwort nach längerem Warten.
Auch Google DeepMind beschrieb 2026 Fortschritte bei mathematischen Aufgaben mit zusätzlicher Rechenzeit. Sein Forschungsagent Aletheia erzeugt Lösungsvorschläge, lässt sie prüfen und bei Bedarf überarbeiten. Bei den beschriebenen Mathematiktests bewerteten menschliche Fachleute die Ergebnisse. Der Herstellerbericht zeigt damit eine konkrete Entwicklung, ist aber kein allgemeiner Nachweis für beliebige Fragen oder alle verfügbaren KI-Produkte.
Wenn mehr Schritte in die falsche Richtung führen
Eine Rechenaufgabe und eine Frage nach einem unbekannten Ereignis stellen unterschiedliche Anforderungen. Bei der ersten kann ein Zwischenschritt helfen, vorhandene Regeln anzuwenden. Bei der zweiten fehlt dem Modell womöglich die entscheidende Information. Zusätzliche Formulierungen erzeugen dann keine neue überprüfte Quelle.
Das zeigt eine Studie von James Xu Zhao, Bryan Hooi und See-Kiong Ng, deren Fassung vom August 2026 14 Reasoning-Modelle untersucht. Bei wissensintensiven Fragen ohne externe Nachschlagequelle verbesserte mehr Rechenzeit die Genauigkeit nicht durchgehend; häufig nahm die Zahl erfundener oder falscher Angaben zu. Die Forschenden beobachteten unter anderem, dass längeres Nachdenken Modelle zu mehr Antwortversuchen veranlassen konnte, von denen einige falsch waren. Das Ergebnis betrifft diese Tests und ist kein Beweis, dass längere Rechenzeit immer schadet.
Ein anderes Team untersuchte ausdrücklich verlängerte Denkpfade. In seinen 2025 veröffentlichten Experimenten stieg die Leistung zunächst und sank bei weiterer Verlängerung wieder. Als Alternative erprobten die Forschenden mehrere parallele Lösungswege mit anschließender Mehrheitsentscheidung. Auch das ist kein universelles Rezept: Die Ergebnisse hängen von den Modellen, Aufgaben und der jeweiligen Art ab, wie zusätzliche Rechenarbeit eingesetzt wird.
Eine Prüfung braucht einen Maßstab
Eine KI kann einen eigenen Entwurf erneut lesen. Nützlicher wird dieser Schritt, wenn es einen Maßstab außerhalb der bloßen Plausibilität gibt: Ein Programm lässt sich mit passenden Testfällen ausführen, eine Rechnung anhand ihrer Regeln nachvollziehen und eine Tatsachenbehauptung mit einem Originaldokument vergleichen. Ein Test kann dennoch Lücken haben; eine einzelne bestandene Probe sichert nicht jeden möglichen Fall ab.
Auch die Darstellung macht einen Unterschied. OpenAI untersuchte 2024, wie gut Menschen mathematische Lösungen unter Zeitdruck beurteilen konnten. Bei stark auf die richtige Antwort optimierten, schwerer lesbaren Lösungen machten die Prüfenden nahezu doppelt so viele Fehler wie bei weniger stark optimierten Lösungen. Ein Training, das die Verständlichkeit für ein prüfendes Modell förderte, verbesserte in diesem Versuch auch die menschliche Bewertung.
Das Ergebnis betrifft eine begrenzte Versuchsanordnung. Es macht aber das praktische Problem sichtbar: Eine korrekte Antwort hilft weniger, wenn niemand ihren Weg prüfen kann. Umgekehrt kann eine flüssige Erklärung falsch sein. Lesbarkeit erleichtert die Kontrolle, ersetzt sie aber nicht.
Was daraus für den Einsatz folgt
Wer eine KI für eine schwierige Aufgabe nutzt, kann sie nach überprüfbaren Zwischenschritten, Annahmen und Quellen fragen. Bei einer aktuellen Faktenfrage lohnt es sich, das angegebene Dokument tatsächlich zu öffnen und die relevante Stelle mit der Antwort zu vergleichen. Bei Code helfen aussagekräftige Tests; bei einer Rechnung kann das Einsetzen des Ergebnisses Fehler sichtbar machen. Welche Prüfung trägt, bestimmt die Aufgabe.
Mehr Rechenzeit bleibt ein nützliches Werkzeug, besonders wenn ein Problem mehrere Schritte oder verschiedene Lösungsansätze verlangt. Die entscheidende Frage lautet aber nicht allein, wie lange ein System gearbeitet hat. Sie lautet, welche Informationen es hatte, wie es seine Lösung ausgewählt hat und woran sich das Ergebnis messen lässt.
Quellen
- OpenAI: Learning to reason with LLMs, 2024
- Google DeepMind: Accelerating mathematical and scientific discovery with Gemini Deep Think, 2026
- Zhao, Hooi und Ng: Test-Time Scaling in Reasoning Models Is Not Effective for Knowledge-Intensive Tasks Yet, Fassung 2026
- Ghosal und Kollegen: Does Thinking More always Help?, 2025
- OpenAI: Prover-Verifier Games improve legibility, 2024
Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft.