Eine Zahl soll oft zeigen, welches KI-Modell das bessere ist. Doch schon Googles eigene Tabelle zum neuen Gemini 4 Hydrogen erzählt eine kompliziertere Geschichte: Je nach Aufgabe liegt ein anderes Modell vorn. Wer die Ergebnisse nutzen will, muss wissen, was geprüft wurde und wie der Test ablief.
Ein Benchmark ist eine Sammlung von Aufgaben samt einer Methode, die Antworten zu bewerten. Er kann Modelle unter bestimmten Bedingungen vergleichbar machen. Ob ein Vorsprung auch bei der eigenen Arbeit hilft, hängt davon ab, wie ähnlich diese Aufgaben dem späteren Einsatz sind und welche Werkzeuge und Einstellungen die Systeme im Test erhalten.
Eine Tabelle, mehrere Rangfolgen
In seiner Modellkarte führt Google Tests für Programmierung, Wissensarbeit, Computerbedienung und weitere Bereiche auf. Beim Programmierbenchmark SWE-sweep nennt das Unternehmen für Hydrogen 13,5 Prozent, für Claude Sonnet 5.5 3,1 Prozent und für GPT-6.1 Terra 5,8 Prozent. Bei Terminal-Bench 4.1 steht dagegen Sonnet mit 63,9 Prozent vor Hydrogen mit 57,0 Prozent. Für Terra zeigt die Tabelle dort keinen Wert.
Diese Zahlen beschreiben Ergebnisse verschiedener Aufgaben und Bewertungsverfahren. Aus ihnen lässt sich keine gemeinsame Gesamtnote ableiten. Wer etwa einen Programmierassistenten sucht, sollte zuerst fragen, welche Art von Aufgabe der jeweilige Test enthält und ob sie der eigenen Arbeit ähnelt. Ein Test für Computerbedienung beantwortet wiederum eine andere Frage als ein Test mit wissenschaftlichen Aufgaben.
Der neue Ansatz ergänzt unsere Übersicht zum Start von Gemini 4 Hydrogen: Dort geht es um Funktionen und Zugang, hier um die Aussagekraft der Leistungszahlen.
Das Modell arbeitet nicht allein
Eine KI löst viele solche Aufgaben in einer Umgebung aus Anweisungen, Hilfsprogrammen und Werkzeugen. Bei Programmieraufgaben kann diese Umgebung Dateien öffnen, Befehle ausführen und Ergebnisse zurückgeben. Fachleute nennen eine solche technische Hülle oft Harness. Sie beeinflusst mit, welche Informationen das Modell erhält und welche Schritte es ausführen kann.
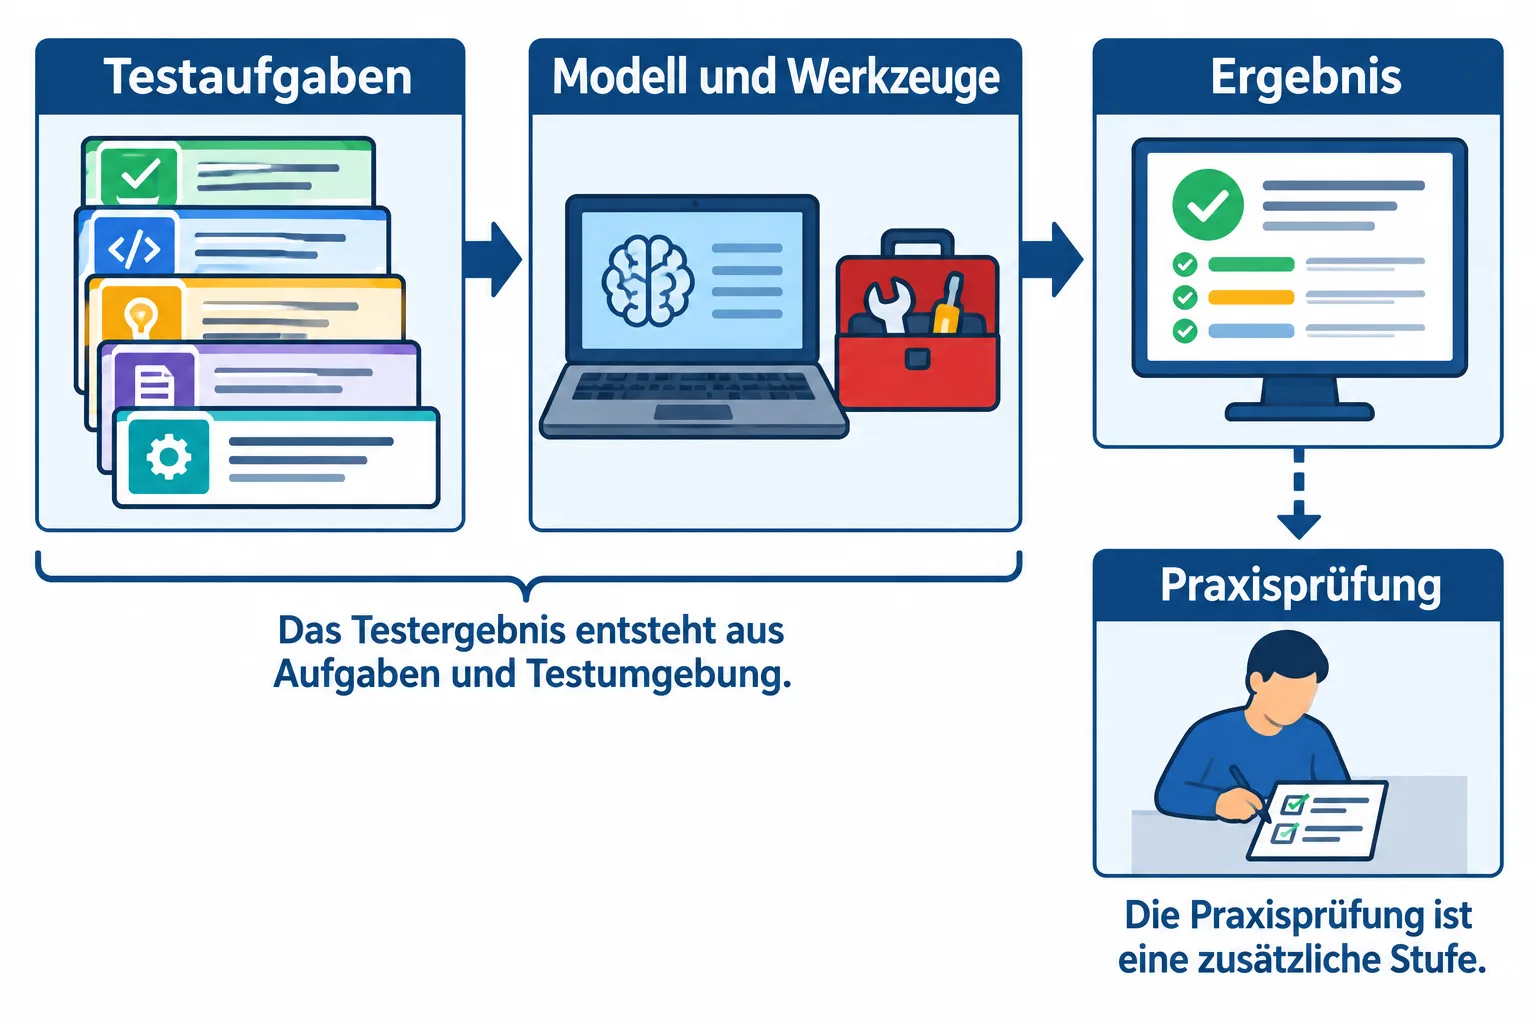
Googles Methodendokument nennt für SWE-sweep bei Hydrogen die eigene Antigravity-CLI als Umgebung. Die Vergleichswerte von Sonnet und Terra stammen laut Google aus der öffentlichen Bestenliste. Das ist eine wichtige Information: Die Tabelle versammelt Ergebnisse aus unterschiedlichen Quellen. Sie zeigt nicht automatisch, was bei einem vollständig identischen Aufbau herauskäme.
Auch die Zahl der Versuche und die Auswertung zählen. Bei Terminal-Bench 4.1 mittelt Google für Hydrogen über fünf Versuche je Aufgabe. Beim Computerbedienungstest OSWorld 2.1 berichtet das Unternehmen für Hydrogen und Sonnet den besten von drei Läufen auf einer Teilmenge von 82 Aufgaben ohne Internetzugang. Ein Ergebnis auf dieser Teilmenge ist keine Aussage über jede mögliche Computeraufgabe.
Eine hohe Denkstufe kann einem Modell mehr Rechenarbeit für eine Antwort erlauben. Google verwendet nach eigener Beschreibung grundsätzlich die höchste Denkstufe, soweit nicht anders angegeben; für Vergleichsmodelle nutzt es verfügbare gemeldete Ergebnisse. Wer später eine schnellere Einstellung verwendet, muss deshalb nicht denselben Wert erwarten. Für die praktische Wahl gehören außerdem Wartezeit und Kosten zur Frage, ob ein Ergebnis nützlich ist.
Bestanden heißt nicht automatisch einsatzbereit
Ein Beispiel aus der Softwareentwicklung zeigt, weshalb die Bewertung selbst wichtig ist. Ein automatischer Test kann prüfen, ob ein Programm bestimmte erwartete Ergebnisse liefert. Ein Mensch, der ein Projekt betreut, achtet zusätzlich darauf, ob die Änderung verständlich ist und zu den übrigen Teilen des Projekts passt.
Die Forschungsorganisation METR ließ 296 KI-generierte Änderungsvorschläge von vier Betreuenden aus drei Softwareprojekten prüfen. Bei den untersuchten älteren Modellen wäre nach der bereinigten Auswertung ungefähr die Hälfte der Beiträge, die den automatischen SWE-bench-Verified-Test bestanden hatten, nicht unmittelbar übernommen worden.
Das ist kein Messergebnis für Hydrogen und auch kein Test von SWE-sweep. Zudem bekamen die untersuchten Agenten keine Gelegenheit, ihre Lösung nach menschlichem Feedback zu verbessern. Die Untersuchung zeigt einen engeren Punkt: Eine bestandene automatische Prüfung und eine Freigabe für ein echtes Projekt sind unterschiedliche Hürden. Ein Benchmark kann trotzdem nützliche Hinweise liefern.
Welche Fragen vor dem Vergleich helfen
Die Stanford-Forschenden hinter BetterBench untersuchten 24 KI-Benchmarks anhand von Qualitätskriterien. Sie fanden deutliche Unterschiede und betonen unter anderem, dass Zweck, Auswertung und Möglichkeiten zur Wiederholung verständlich dokumentiert sein sollten. Ein Ergebnis ist leichter einzuordnen, wenn andere nachvollziehen können, wie es zustande kam.
Für die eigene Auswahl lohnt sich daher ein Blick auf vier Dinge: Welche Aufgaben wurden gestellt? Welche Werkzeuge, Zeit und Einstellungen standen zur Verfügung? Wie wird Erfolg bewertet? Und stammt der Wert aus demselben Testaufbau wie der Vergleichswert? Fehlende Angaben machen eine Zahl nicht automatisch falsch, begrenzen aber, was sich aus ihr ableiten lässt.
Danach lässt sich eine kleine Auswahl mit typischen eigenen Aufgaben erproben: etwa einen Text zusammenfassen, eine Tabelle auswerten oder eine Programmänderung vorschlagen. Für einen fairen Vergleich sollten Aufgaben und verfügbare Informationen möglichst gleich bleiben. Anschließend zählt nicht nur die Antwort, sondern auch, wie viel Nacharbeit nötig ist und ob Quellen oder Ergebnisse überprüft werden können.
Eine Rangliste kann die Vorauswahl erleichtern. Die Entscheidung fällt dort, wo das Modell tatsächlich eingesetzt wird: bei den Aufgaben, Fehlern und Zeitgrenzen, die für den eigenen Ablauf wichtig sind.
Quellen
- Google DeepMind: Gemini 4 Hydrogen Model Card, 12. November 2026
- Google DeepMind: Gemini 4 Hydrogen Model Evaluation, Methodik
- Stanford HAI: What Makes a Good AI Benchmark?, 11. Dezember 2024
- METR: Many SWE-bench-Passing PRs Would Not Be Merged into Main, 10. März 2026
Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft.