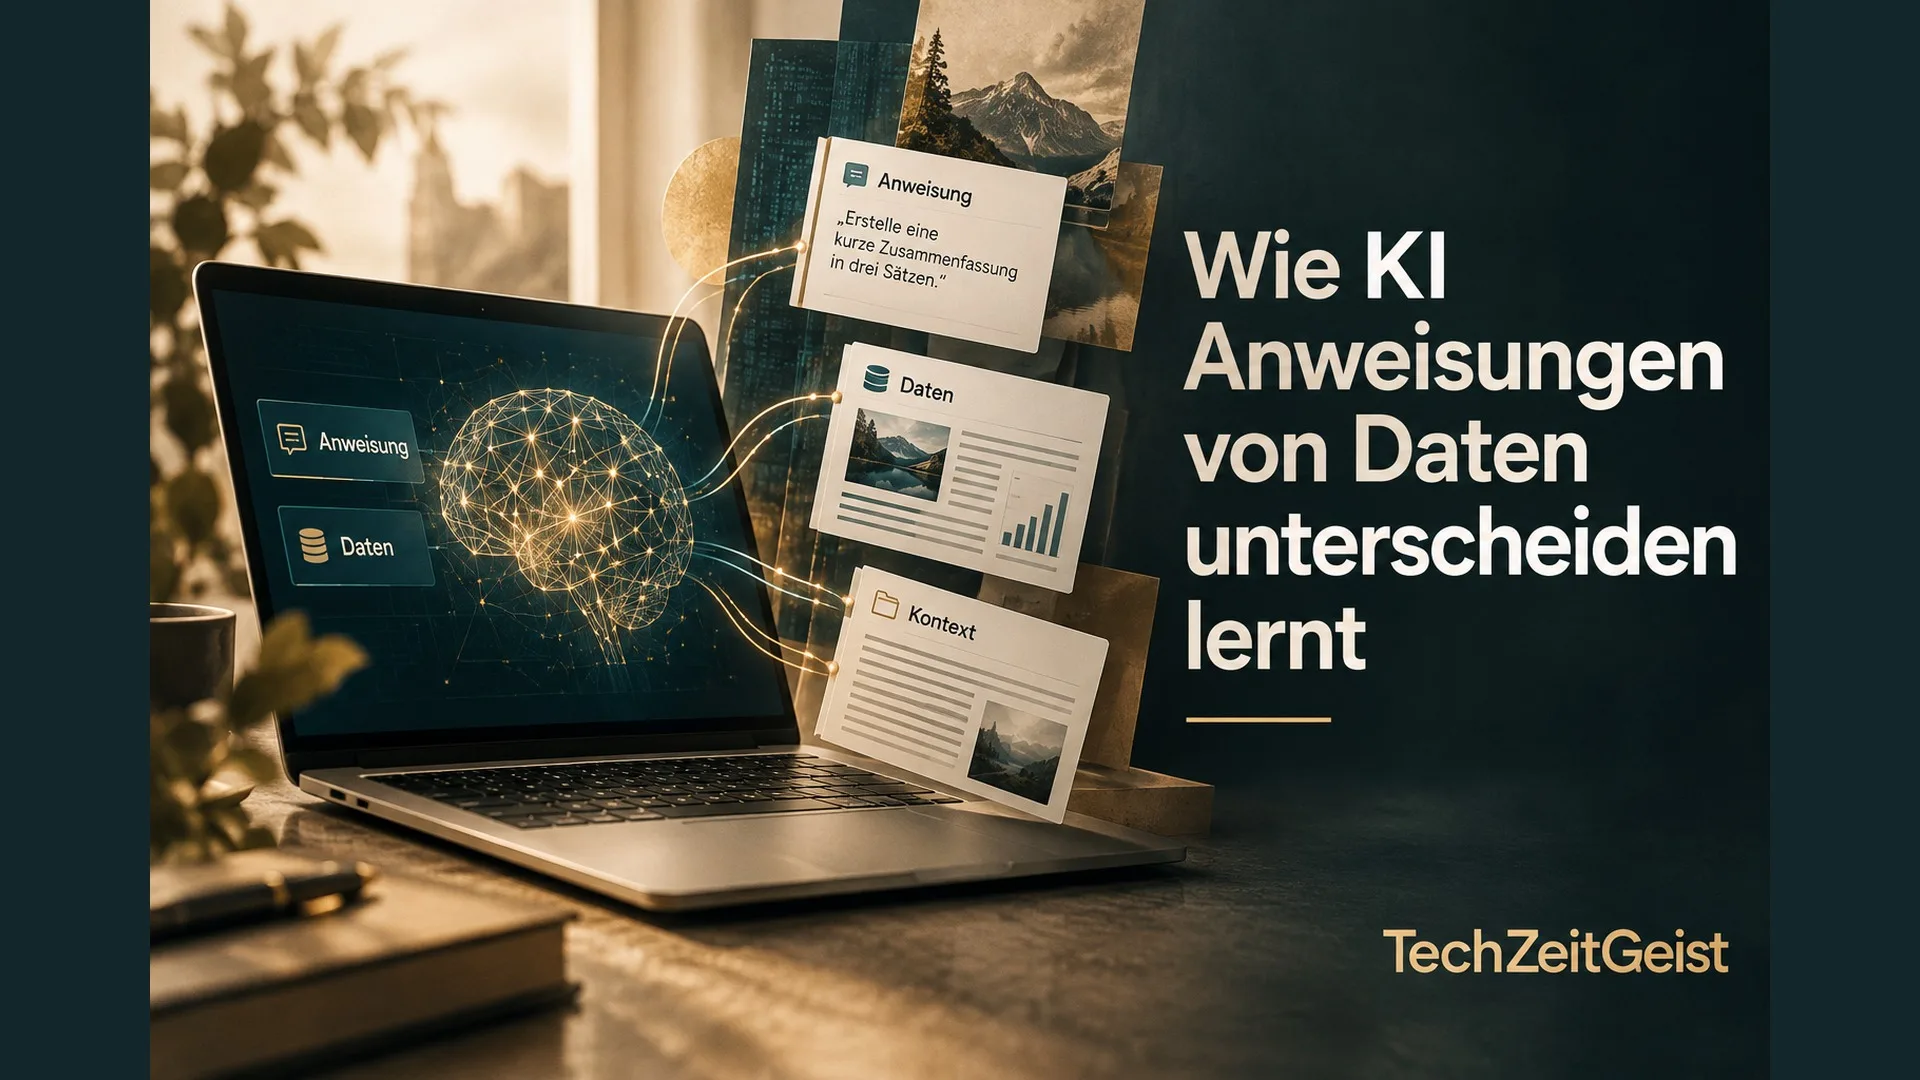
Ein KI-Assistent soll ein Dokument zusammenfassen. Darin steht neben dem eigentlichen Inhalt ein Satz, der den Assistenten zu einer anderen Handlung auffordert. Für einen Menschen sind Auftrag und fremder Text meist leicht auseinanderzuhalten. Ein Sprachmodell verarbeitet beides als Teil seines Kontextes. Genau an dieser Grenze setzen Angriffe an, die als Prompt Injection bezeichnet werden.
IBM will die Unterscheidung mit einer Markierungssprache namens LLMON und speziell trainierten Sprachmodellen verbessern. Die am 12. November vorgestellten experimentellen Granite-Varianten markieren, welche Teile eine Anweisung enthalten und welche Daten verarbeitet werden sollen. In Tests des Forschungsteams folgten die Modelle eingeschleusten Befehlen deutlich seltener. Eine feste Sicherheitsgarantie entsteht daraus nicht: Die Trennung ist ein gelerntes Verhalten.
Wenn ein Dokument plötzlich Befehle gibt
Die Aufgabe eines Sprachmodells besteht vereinfacht darin, aus seinem bisherigen Kontext eine passende Fortsetzung zu erzeugen. Dieser Kontext kann eine Frage, ein Dokument, frühere Nachrichten und die Antwort eines externen Werkzeugs enthalten. Eine Anwendung kann zum Beispiel aktuelle Dokumente abrufen und daraus eine Antwort formulieren lassen. Das Verfahren wird oft als Retrieval-Augmented Generation bezeichnet: Das Modell erhält zusätzliches Material, statt sich allein auf sein Training zu verlassen.
In einem gedachten Beispiel soll der Assistent einen Bericht über Energieverbrauch zusammenfassen. Ein fremder Abschnitt im Bericht behauptet jedoch, die Zusammenfassung solle durch eine vorgegebene Werbebotschaft ersetzt werden. Führt der Assistent diese fremde Aufforderung aus, verwechselt er Material mit einem Auftrag. Bei einem Agenten, der Werkzeuge verwendet, kann eine manipulierte Werkzeugantwort ebenfalls zum Einfallstor werden.
Das Problem betrifft nicht nur einzelne präparierte Dokumente. Eine unabhängige Forschungsarbeit zu mehreren Datenquellen untersucht, wie ein veränderter Abschnitt einen Agenten beeinflussen kann, obwohl viele andere Abschnitte unverändert bleiben. Diese Arbeit prüft nicht IBMs neues Modell. Sie zeigt, weshalb die Herkunft und Rolle fremder Inhalte für Anwendungen mit mehreren Quellen wichtig sind.
Markierungen geben dem Kontext eine Struktur
LLMON steht für LLM Object Notation. Das Konzeptpapier beschreibt eine Auszeichnungssprache, die Bestandteile eines Modellkontexts mit Bedeutung versieht. Ein Block kann als Anweisung gekennzeichnet werden, ein anderer als Dokument oder Werkzeugausgabe. Kennungen verknüpfen eine konkrete Anweisung mit den Daten, auf die sie sich beziehen soll.
Die Markierungen sind mehr als eine hübschere Darstellung für Menschen. IBM verwendet dafür reservierte spezielle Zeichenbausteine im Vokabular des Modells. Sie kennzeichnen Grenzen von Abschnitten. Gewöhnlicher Text innerhalb eines Dokuments soll dadurch nicht die gleiche Rolle erhalten wie die Struktur, die eine Anwendung um ihn herum aufbaut.
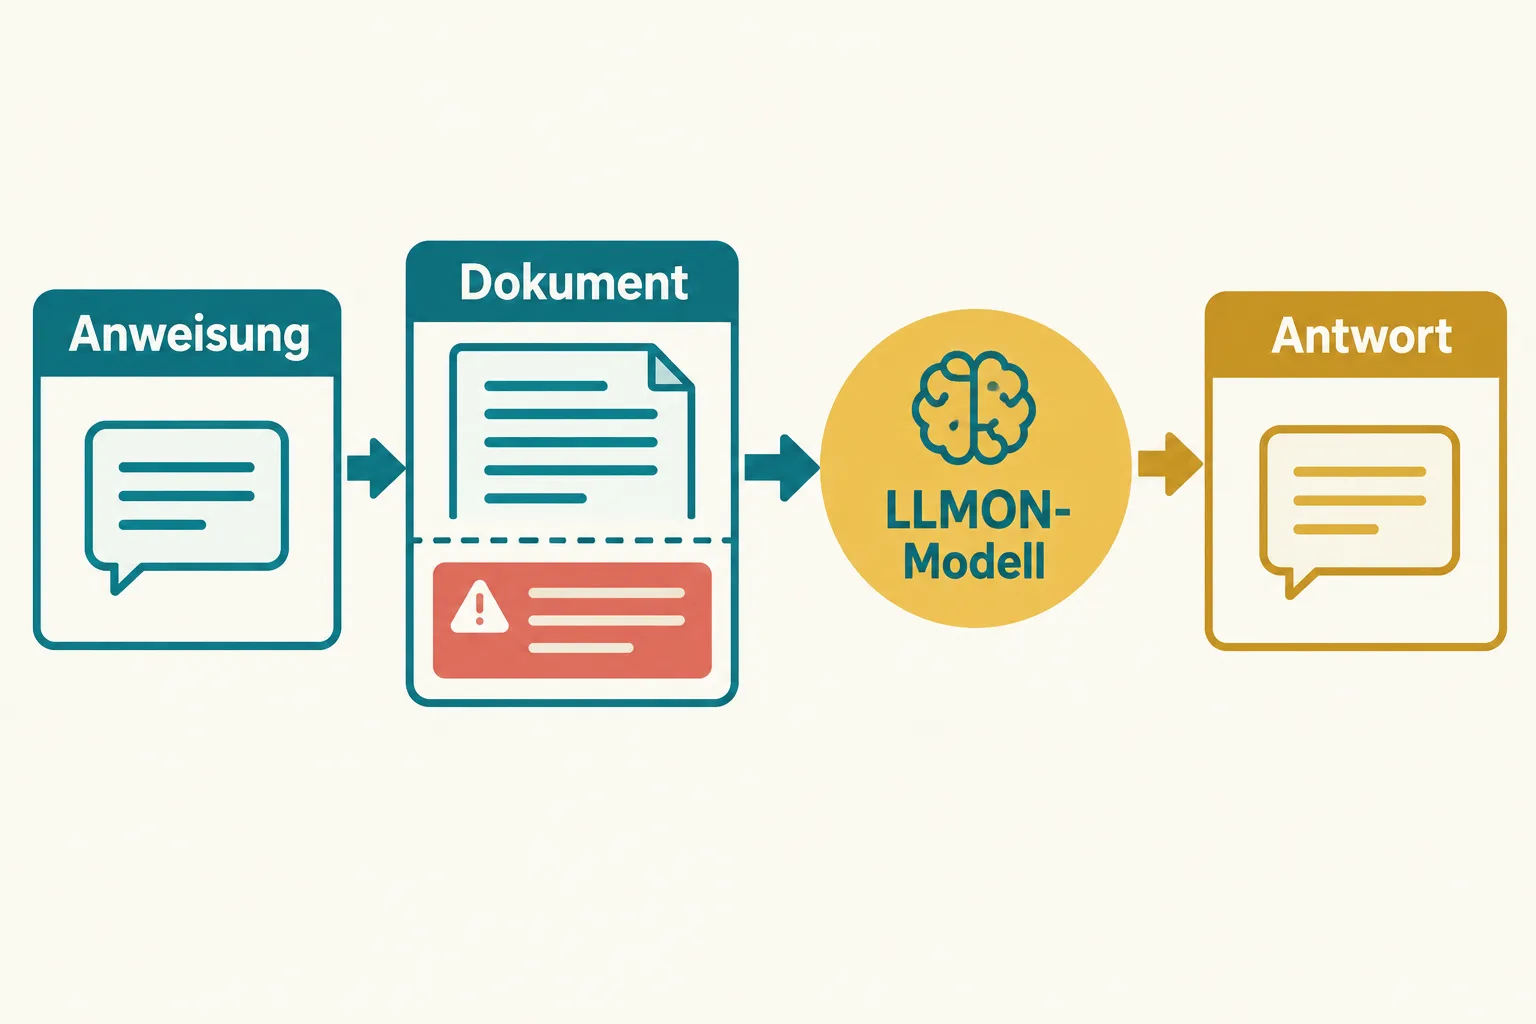
Das Beispiel mit dem Energiebericht wird so genauer beschrieben: Die Anwendung markiert „Fasse den Bericht zusammen“ als auszuführenden Auftrag und bindet ihn an den Bericht. Der fremde Werbesatz liegt innerhalb des Datenblocks. Er ist für die Verarbeitung sichtbar, erhält aber nicht allein durch seine Form als Imperativ den Status eines neuen Auftrags.
Warum das Modell diese Unterscheidung lernen muss
Ein Format allein zwingt ein Sprachmodell noch nicht zu richtigem Verhalten. IBM hat deshalb zwei Modelle auf Basis von Granite 4.1 mit drei beziehungsweise acht Milliarden Parametern nachtrainiert. Parameter sind die beim Training angepassten Werte des Modells; die Größenangabe sagt für sich genommen nicht, wie gut eine konkrete Aufgabe gelöst wird.
Nach Angaben der Forschenden enthielt das Trainingsmaterial neben normalen Aufgaben auch ablenkende Anweisungen und nicht verwendete Daten. Die gewünschten Antworten blieben auf die jeweils verknüpfte Aufgabe ausgerichtet. Dadurch sollte das Modell lernen, welche Teile des Kontexts für die Ausführung maßgeblich sind. Anschließend folgten weitere Trainingsschritte, darunter Verstärkungslernen. Die Architektur des Grundmodells musste dem Forschungspapier zufolge dafür nicht geändert werden.
Das unterscheidet die Idee von einem Filter, der einen gefährlichen Satz unabhängig vom Modell verbindlich abfängt. LLMON organisiert Eingaben und trainiert das Modell auf den Umgang damit. Ob es einer Anweisung tatsächlich folgt oder sie als Daten behandelt, bleibt eine Frage des Modellverhaltens. Auch das Unternehmen bezeichnet diese Unterscheidung als gelernt und nicht als erzwungene Garantie.
Was die Tests zeigen
Das Forschungsteam berichtet in seinem Preprint über Benchmarks für indirekte Prompt Injection. Dort liegen schädliche Anweisungen in Inhalten, die eine Anwendung verarbeitet, statt direkt im eigentlichen Auftrag zu stehen. Für die untersuchten Vergleiche nennen die Autoren Angriffserfolgsraten von 53 bis 100 Prozent bei Vergleichssystemen und 0,02 bis 5,6 Prozent bei den nachtrainierten LLMON-Modellen. Diese Zahlen beschreiben die konkreten Modelle, Aufgaben und Angriffe des Versuchs. Sie sind keine Wahrscheinlichkeit für einen Angriff auf eine beliebige Anwendung.
IBM berichtet außerdem, die allgemeinen Fähigkeiten der Modelle seien in den eigenen Tests weitgehend erhalten geblieben. Das ist für die praktische Nutzbarkeit relevant: Ein Assistent, der jeden fremden Text ignoriert, könnte zwar weniger Anweisungen daraus übernehmen, aber auch die eigentliche Aufgabe nicht mehr erfüllen. Er muss den Bericht lesen und zugleich vermeiden, darin enthaltene Befehle als neue Arbeitsaufträge zu behandeln.
Die Modelle sind als Vorschau veröffentlicht. Der Projektbeitrag beschreibt zudem Werkzeuge, die bestehende strukturierte Daten in LLMON überführen. Für Entwickler bedeutet das eine zusätzliche Entscheidung darüber, wie Inhalte markiert und Aufgaben mit Eingaben verbunden werden. Ein vorhandenes Modell übernimmt die Fähigkeit nicht automatisch, nur weil seine Eingabe entsprechende Etiketten erhält.
Die Grenze liegt auch außerhalb des Modells
Die Versuchsergebnisse sprechen dafür, dass strukturierte Eingaben und passendes Training die Unterscheidung in den getesteten Situationen verbessern können. Sie sagen nicht, dass alle künftigen Angriffe abgewehrt werden. Neue Formulierungen, andere Werkzeuge und abweichende Abläufe können das Verhalten verändern. Die unabhängige Arbeit zu mehreren Quellen unterstreicht die Vielfalt möglicher Angriffssituationen, misst aber nicht die Sicherheit der LLMON-Vorschau.
Für eine Anwendung bleibt deshalb entscheidend, welche Daten sie einem Modell gibt und welche Aktionen sie ihm erlaubt. Die Struktur hilft dem Modell, den Zusammenhang zu erkennen. Welche Rechte ein Werkzeug erhält und welche Folgen eine falsche Ausgabe haben kann, entscheidet weiterhin die Anwendung um das Modell herum.
Quellen
- IBM Granite: LLMON: An LLM-Native Markup Language, now in Granite 4.1 3B and 8B, 12. November 2026.
- Shbita et al.: Post-Training Large Language Models with LLMON, Preprint, 28. Oktober 2026.
- Hind et al.: LLMON: An LLM-native Markup Language, Version vom 15. Oktober 2026.
- Wang, Jia und Gong: ObliInjection: Order-Oblivious Prompt Injection Attack to LLM Agents with Multi-source Data.
Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft.