Eine AMD-GPU wird für ein KI-Team nicht dadurch einfacher, dass ein Modell einmal startet. Entscheidend ist, ob sich die Umgebung reproduzierbar installieren, beobachten, aktualisieren und an ein zweites Team übergeben lässt. Genau auf diese Arbeit zielt AMD mit ROCm 10 und ROCm.AI: Das Unternehmen bündelt Werkzeuge für Wissen, Ausführung und Optimierung zu einem geführteren Softwarepfad.
Das ist mehr als ein weiterer Bibliotheks-Release. Für Entwickler- und Plattformteams kann ein klarer Weg durch Treiber, Runtime, Framework, Serving und Diagnose die Lern- und Integrationslast tatsächlich senken. Der Release belegt aber noch nicht, dass dieser Weg mit jeder AMD-GPU, jedem Modell und jeder Umgebung gleich zuverlässig bis zum wartbaren Dienst führt. Der praktische Nachweis beginnt erst dort, wo die eigene Hardware, die eigene Versionierung und die eigene Last zählen.
AMD greift die Softwarehürde rund um KI-Hardware gezielter an
AMD meldete am 27. August die Veröffentlichung von ROCm 10 und die allgemeine Verfügbarkeit von ROCm.AI. Die offizielle Release-Historie führt ROCm 10.0.0 bereits mit dem 26. August. Die unterschiedlichen Quellenstempel widersprechen sich nicht zwingend: Die Historie dokumentiert die Version, Newsroom und Entwicklerbeiträge den öffentlichen Release. Für die Einordnung ist wichtiger, was AMD mit dem Paket verbindet.
ROCm.AI umfasst laut AMD drei Bausteine: AMD Skills, ROCm CLI und Hyperloom. Skills sollen AMD-validiertes Wissen für Coding-Agenten bereitstellen. Die Kommandozeile soll Installation, Umgebungsprüfung, Serving, Updates und Diagnose wiederholbar machen. Hyperloom ist als System für Profiling und Optimierung gedacht, das Änderungen an Host-Code und GPU-Kernels prüfen soll. Hinzu kommen ein modularerer ROCm Core SDK sowie von AMD beschriebene, validierte Pfade für vLLM und SGLang.
Die Richtung ist nachvollziehbar. Wer KI-Infrastruktur betreibt, verliert Zeit selten an einem einzelnen Paket. Arbeit entsteht an den Übergängen: Welche Treiberversion passt zur Firmware? Welcher Container funktioniert mit dem gewählten Modell? Wo liegen Logs und Telemetrie, wenn ein Serving-Dienst nach einem Update anders reagiert? Ein geführter Pfad kann diese Fragen nicht verschwinden lassen. Er kann aber verhindern, dass jedes Team dieselben ersten Fehler erneut macht.
Von der Kompatibilitätsmatrix zum übergebbaren Dienst
Die Redaktion hat Releaseumfang, technische Dokumentation und unabhängige Gegenlesen entlang dieses Betriebswegs zusammengeführt. Daraus entsteht keine eigene Leistungsmessung. Die Matrix zeigt vielmehr, welche Belegstufe hinter einem Versprechen steht und an welcher Stelle Teams selbst abnehmen müssen.
- 1. Hardware und System prüfen
- Die ROCm-10-Kompatibilitätsmatrix führt konkrete Instinct-, Radeon- und Ryzen-Familien für Linux und Windows. Das ist dokumentierter Support für bestimmte GPU-, Betriebssystem-, Treiber- und Firmwarekombinationen. Ein Matrixeintrag ist noch kein erfolgreicher Test der eigenen Installation.
- 2. Runtime und Framework festlegen
- AMD beschreibt validierte Container, Wheels und Framework-Pfade. Sie können einen Ausgangspunkt liefern, ersetzen aber nicht die Prüfung der konkreten Modell-, Runtime- und Versionskombination.
- 3. Serving und Diagnose abnehmen
- Health- und Completions-Endpunkte, Logs, Telemetrie und Fehlerdiagnose müssen im eigenen Dienst funktionieren. Erst dann wird aus einem Startversuch ein betreibbarer Pfad.
- 4. Optimierung und Korrektheit prüfen
- Hyperloom soll nach AMDs Beschreibung Engpässe finden und Änderungen auf Leistung und Korrektheit prüfen. Ob das für einen konkreten Workload einen belastbaren Vorteil bringt, muss dieser Workload zeigen.
- 5. Updates und Wartung bewältigen
- Versionen, Rollbacks, Fehlerfälle und Übergaben an andere Mitarbeitende entscheiden darüber, ob ein Team langfristig weniger Spezialwissen binden muss.
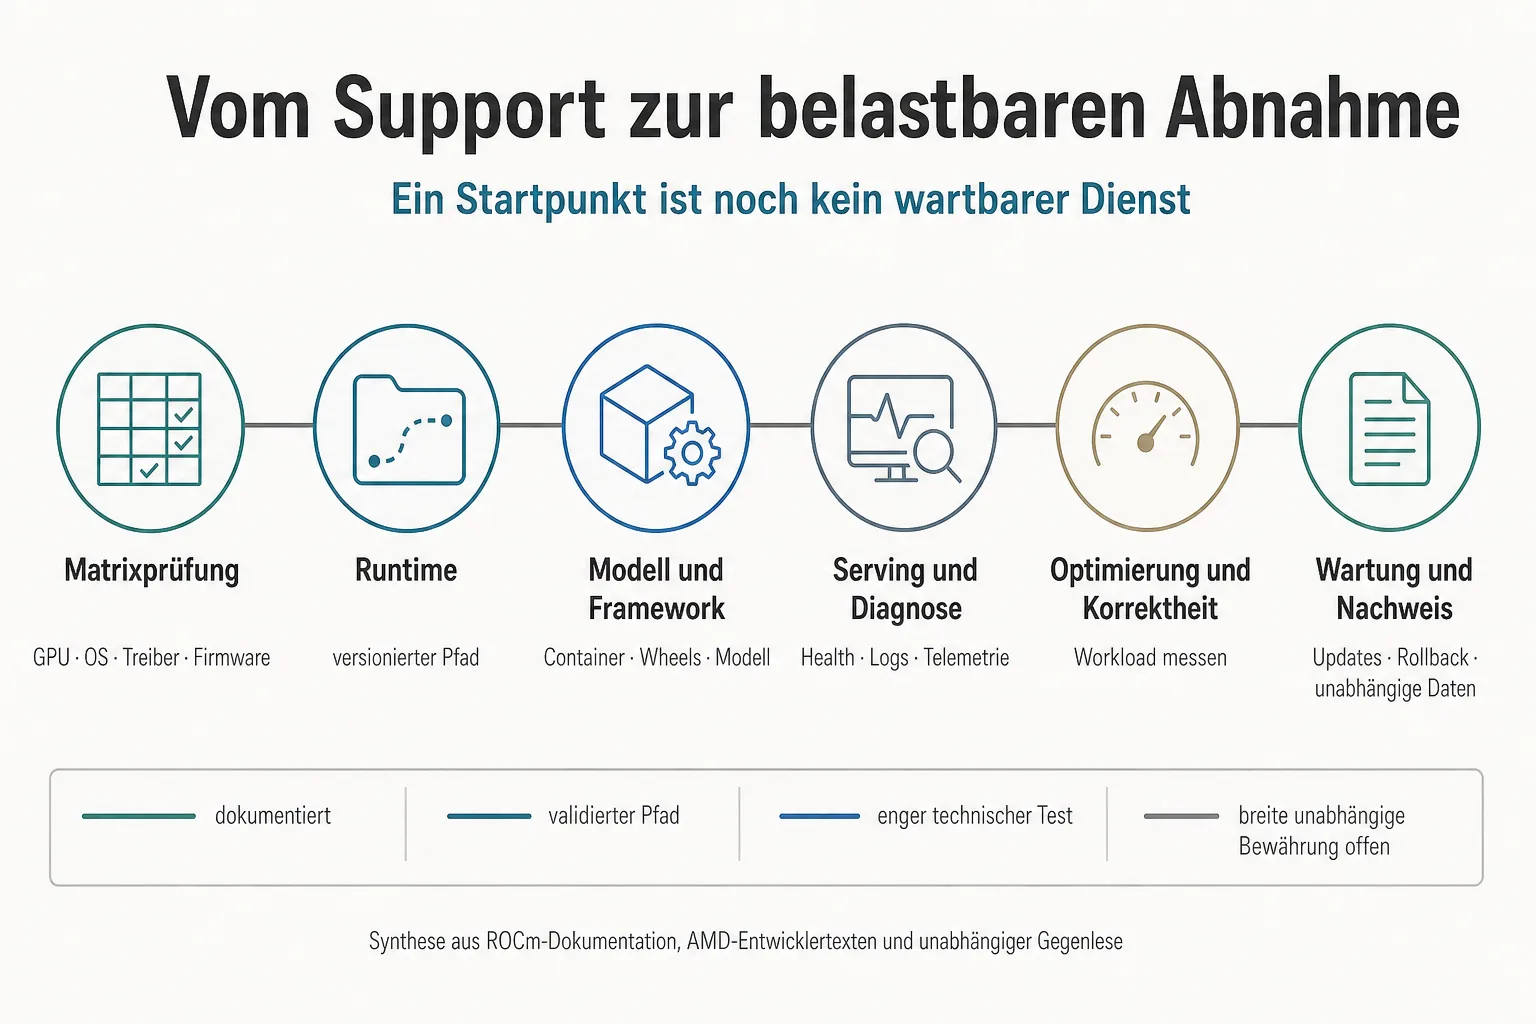
Diese Reihenfolge erklärt, warum der Release für den Korridor Arbeit und Bildung relevant ist. Hardwarebudget ist nur ein Teil der Entscheidung. Ebenso wichtig ist, wie viel Qualifikationszeit in Treiber, Container, Frameworks, Fehlersuche und spätere Updates fließt. Ein gutes Tool reduziert nicht automatisch die Komplexität des Systems. Es kann sie aber sichtbarer machen und Arbeit in wiederholbare Schritte übersetzen.
Support ist nicht dasselbe wie Produktionsreife
AMDs Kompatibilitätsmatrix ist für Beschaffung und Planung nützlich, weil sie Support an konkrete Kombinationen bindet. Gerade darin liegt ihre Aussagekraft. Sie sagt nicht: Jede AMD-GPU mit ROCm 10 liefert mit jedem Modell dieselbe Erfahrung. Sie sagt: Für die aufgeführten Kombinationen dokumentiert AMD einen Supportumfang.
Auch die Einzelwerkzeuge tragen unterschiedliche Reifegrade. AMD meldet ROCm.AI als allgemein verfügbar. ROCm CLI wird in offiziellen Materialien zugleich als Technology Preview beschrieben; das aktuelle Repository verweist auf einen frühen, teils Nightly-orientierten Lieferpfad. Das ist kein Urteil über die Brauchbarkeit des Werkzeugs. Es bedeutet aber, dass Teams Schnittstellen, Verhalten und Updatefolgen nicht wie bei einem seit Jahren stabilen Standard behandeln sollten.
Besonders deutlich wird die Grenze beim aktuellen vLLM-Adapter von ROCm CLI. Die Dokumentation ist für Linux und WSL ausgelegt. Sie installiert vLLM nicht automatisch, erwartet einen passenden vorhandenen oder gemanagten Runtime-Pfad, überspringt natives Windows-vLLM-Serving und sieht keinen CPU-Fallback vor. Für Tool-Calling muss außerdem ein passender modellspezifischer Parser gesetzt werden; der Adapter leitet ihn nicht selbst her.
Das ist kein nebensächliches Detail. In gemischten Unternehmensumgebungen entscheidet genau diese Art von Einschränkung darüber, ob ein Standardpfad für ein Team reicht oder ob zusätzliche Linux-, Container- oder Runtime-Kenntnisse nötig bleiben. Ein Binary für Linux und Windows bedeutet deshalb nicht, dass beide Plattformen beim Serving dieselbe Abdeckung haben.
Die Leistungszahlen bleiben AMDs Laborszenario
AMD nennt durchschnittlich 3,3-mal höhere Inferenzleistung und 2,4-mal höhere Trainingsleistung gegenüber ROCm 7. Diese Werte stammen laut AMD aus Performance Labs mit konkreten Konfigurationen und Workloads. Der Entwicklerbeitrag beschreibt für die Inferenzpassage eine 8x-MI355X-Plattform und ein ROCm.AI-Preview auf Basis von ROCm 7.2.2.
Die Zahlen können zeigen, dass AMD an Performance und Werkzeugkette gearbeitet hat. Sie sind jedoch kein allgemeiner Faktor für beliebige Modelle, keine unabhängige Messung und kein Nachweis einer allgemeinen CUDA-Parität. Phoronix und StorageReview bestätigen den Releasekontext und referieren die Werte als AMD-Angaben; sie liefern keinen unabhängigen End-to-End-Benchmark für heterogene Produktionsworkloads.
Für eine Beschaffungs- oder Plattformentscheidung ist das kein Grund, die Angaben zu ignorieren. Es ist ein Grund, sie richtig einzuordnen. Ein Team sollte dieselben Modelle, Lastprofile und Qualitätskriterien auf den eigenen Zielsystemen messen. Dazu gehören Durchsatz und Latenz, aber auch Fehlerverhalten, Energiebedarf, Updateaufwand und die Frage, wie gut ein anderer Mitarbeiter den Dienst nachvollziehen kann.
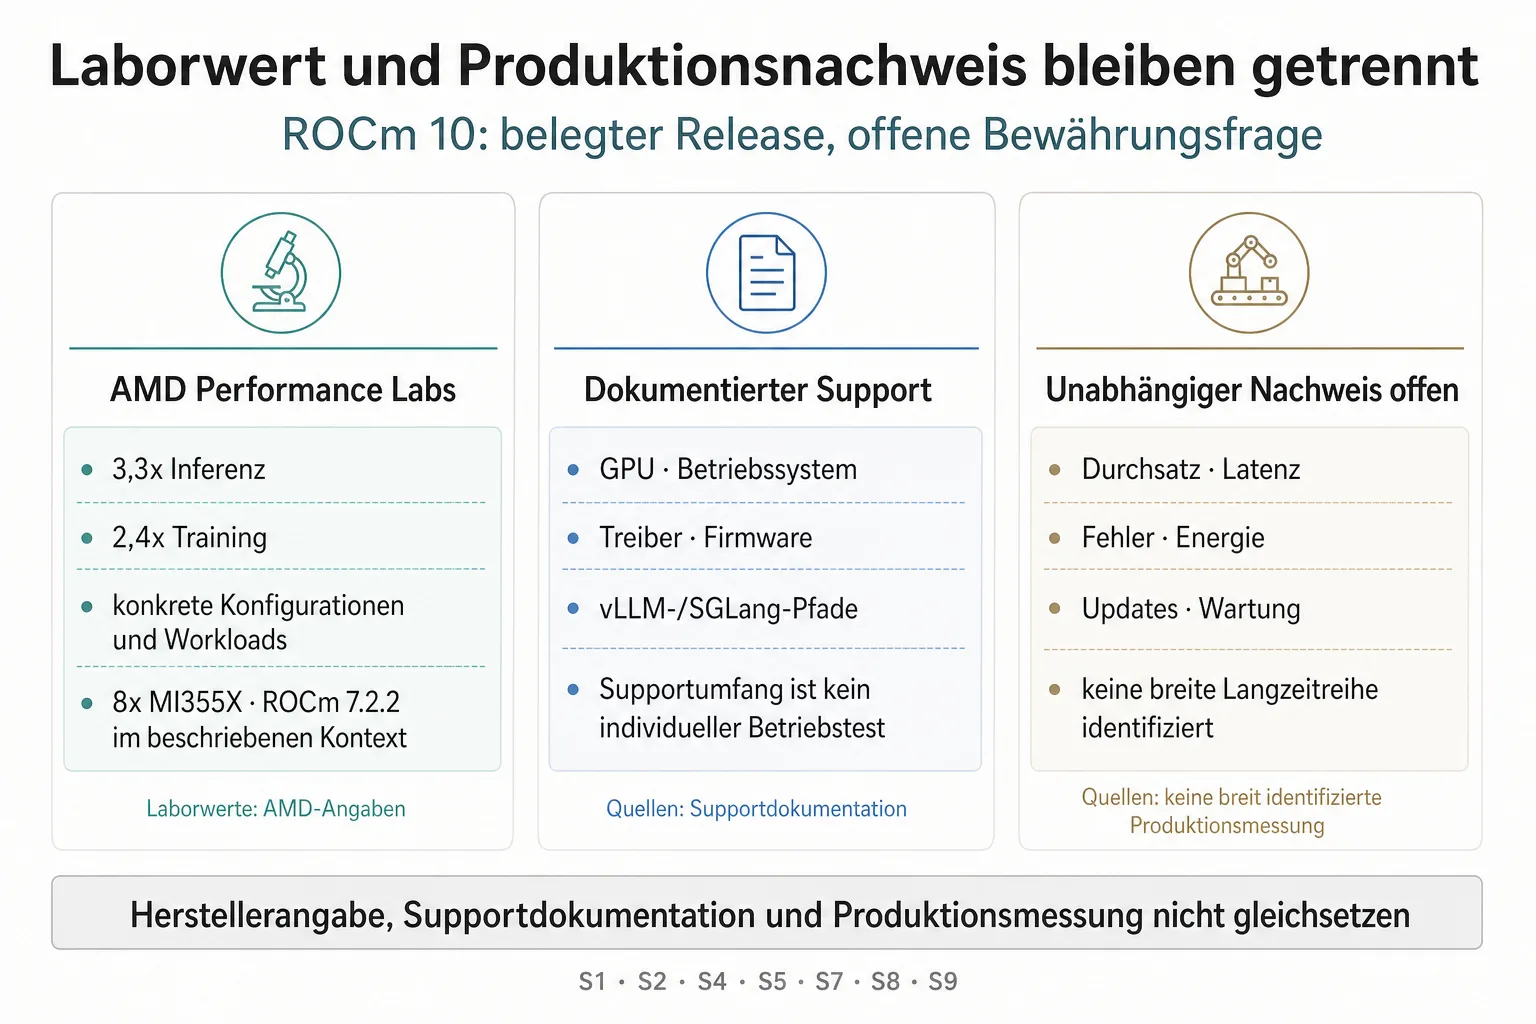
Der fehlende Nachweis liegt zwischen Demo und Dauerbetrieb
Die Dokumentation enthält einen konkreten technischen Acceptance-Pfad: Im TheRock-/MI300X-Kontext werden unter anderem GPU-Serving sowie Health- und Completions-Endpunkte geprüft. Das ist nützlich, weil es aus dem abstrakten Wort „Support“ überprüfbare Schritte macht. Ein solcher Test mit einem Modell und einer Runtime ist aber keine breite Abnahme für ROCm 10, unterschiedliche Hardwarefamilien oder reale Projektmodelle.
Ein belastbarerer nächster Nachweis sähe anders aus: mehrere offiziell unterstützte GPU-, Betriebssystem- und Treiberkombinationen, dieselben Modelle und Lasten, versionierte Installations- und Updateprotokolle sowie unabhängige Messungen zu Latenz, Verfügbarkeit, Energie, Fehlern und Wartung. Erst mit solchen Daten lässt sich beurteilen, ob ein geführter Einstieg auch über Monate weniger Integrationsarbeit verursacht.
Für Teams in Deutschland und Europa ist das eine praktische, keine geografische Aussage. Die Quellen belegen keine bestimmte Cloud-Verfügbarkeit oder Beschaffungslage. Sie zeigen aber, dass die Wahl von AMD-Beschleunigern zugleich eine Entscheidung über Runtime-Pflege, Container-Pinning, Diagnose, Updateprozesse und vorhandenes Know-how ist. Wer in lokalen oder abgeschotteten Umgebungen arbeitet, sollte die Linux-/WSL-Grenze des vLLM-Pfads früh prüfen, statt sie erst beim Rollout zu entdecken.
ROCm 10 kann Arbeit reduzieren, wenn der eigene Pfad mitgedacht wird
AMD hat ROCm 10 nicht nur als Sammlung neuer Funktionen vorgestellt. Der Release versucht, die oft unterschätzte Arbeit zwischen erster Installation und dauerhaftem Betrieb besser zu führen. Das ist ein ernsthafter Ansatz, denn genau dort entscheidet sich, ob Hardware für ein Team produktiv wird oder dauerhaft Spezialwissen bindet.
Der derzeit belegte Fortschritt liegt bei Releaseumfang, dokumentiertem Support und klarer beschriebenen Werkzeugpfaden. Offen bleibt die unabhängige Bewährung mit vielfältigen Workloads über Updates und reale Betriebsphasen hinweg. Für Entwickler- und Plattformteams folgt daraus eine einfache Konsequenz: Nicht nur die GPU vergleichen. Den gesamten Weg bis zur wartbaren Übergabe testen.
Quellen und weiterführende Informationen
- AMD Newsroom: ROCm 10 und ROCm.AI, 27. August 2026.
- AMD Developer Blog: A Simpler Path to Production AI on AMD Instinct GPUs, 27. August 2026.
- ROCm Blog: ROCm 10.0 und ROCm.AI-Komponenten, 27. August 2026.
- ROCm-Dokumentation: Kompatibilitätsmatrix für ROCm 10.0.0, Dokumentationsstand 14. August 2026.
- ROCm-Dokumentation: Release-Historie, ROCm 10.0.0 vom 26. August 2026.
- ROCm CLI Repository, technischer Readback vom 30. August 2026.
- ROCm CLI: vLLM Adapter-Dokumentation, technischer Readback vom 30. August 2026.
- Phoronix: AMD Jumps From ROCm 7.14 To ROCm 10.0 With ROCm.AI, 27. August 2026.
- StorageReview: ROCm 10 mit ROCm.AI, 28. August 2026.
Hinweis: Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft. Stand: 2026-08-30.