Ein neues Sonnenmodell zeigt, wie teuer wenige Fehlalarme sein können. An der gewählten Schwelle ordnet es 93 Prozent seiner positiven Treffer richtig zu. Gleichzeitig findet es im ausgewerteten Test nur 52 Prozent der tatsächlich vorhandenen aktiven Regionen. Die übrigen echten Regionen fallen durch den Filter. Beide Zahlen stimmen und beantworten verschiedene Fragen.
Das Southwest Research Institute stellte den Ansatz am 13. Oktober vor. Die Arbeit untersucht Signale von der Sonnenrückseite, die von der Erde aus nicht direkt sichtbar ist. Ihr Ergebnis hilft, eine wichtige Entscheidung beim Umgang mit unsicheren Messungen zu verstehen: Wie streng soll ein Hinweis geprüft werden, bevor er in ein größeres Modell eingeht?
Die unsichtbare Seite liefert indirekte Hinweise
Ein Teleskop nahe der Erde sieht nur die zugewandte Sonnenhälfte. Aktive Regionen können sich auf der abgewandten Seite entwickeln und später in den sichtbaren Bereich drehen. Eine vollständige Karte braucht deshalb zusätzliche Informationen. Diese können aus Beobachtungen anderer Standorte oder aus indirekten Verfahren stammen.
Das National Solar Observatory beschreibt dafür die Helioseismologie. Sie nutzt akustische Wellen in der Sonne. Beobachtbare Veränderungen dieser Wellen tragen Informationen über Bereiche, die selbst nicht direkt zu sehen sind. Ihre Auswertung erzeugt eine Karte aus Messsignalen und mathematischer Verarbeitung.
Ein solcher Hinweis ist kein gewöhnliches Foto eines Sonnenflecks. Zwischen Beobachtung und Karte liegt eine Auswertung. Deshalb ist die Frage nach Rauschen und Zuverlässigkeit ein Teil der Methode. Das Observatorium arbeitet unter anderem daran, wie sich die Beständigkeit eines Signals zur Beurteilung seiner Verlässlichkeit nutzen lässt.
Man kann das mit einer akustischen Beobachtung im Alltag vergleichen: Ein Geräusch hinter einer geschlossenen Tür kann auf einen Vorgang hinweisen. Es zeigt ihn nicht direkt. Wiederholt sich das Geräusch unter ähnlichen Bedingungen, wird die Zuordnung möglicherweise plausibler. Für die Sonne ist das nur eine Analogie; die eigentliche Auswertung arbeitet mit physikalisch beschriebenen Wellen und Messgrößen.
Zwei Prozentwerte zählen verschiedene Gruppen
Die Statistik unterscheidet zwischen Precision und Recall. Die Definition der Precision setzt richtige positive Treffer ins Verhältnis zu allen positiven Meldungen. Die Frage lautet: Wie viele der als echt eingestuften Hinweise sind tatsächlich echt?
Recall betrachtet dagegen alle tatsächlich echten Fälle. Wie viele davon hat der Filter gefunden? Die erste Kennzahl beginnt bei den Meldungen des Systems. Die zweite beginnt bei den vorhandenen Fällen. Wer die Grundgesamtheit verwechselt, liest aus einem guten Trefferanteil schnell eine hohe Vollständigkeit heraus.
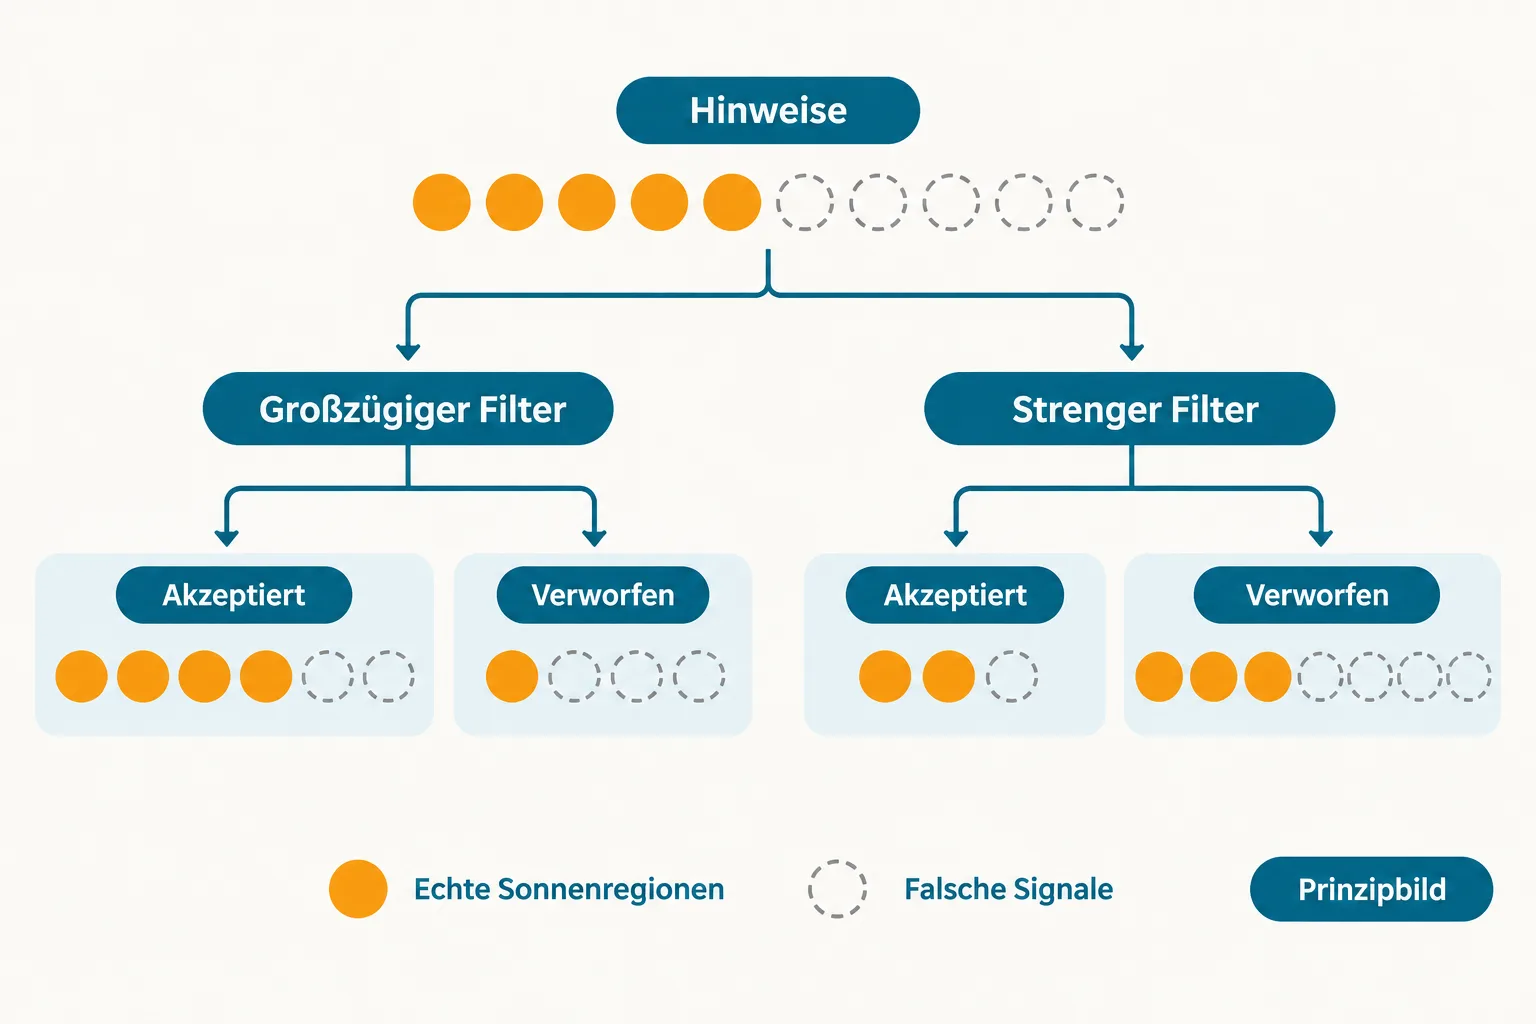
Ein frei gewähltes Beispiel macht das anschaulich. Wir stellen uns 100 echte Regionen und 100 falsche Hinweise vor. Ein erster Filter akzeptiert 60 echte Regionen und zehn falsche Hinweise. Er meldet somit 70 Treffer, von denen 60 richtig sind. Seine Precision beträgt rund 86 Prozent. Von den 100 echten Regionen findet er 60, sein Recall liegt also bei 60 Prozent.
Nun wird die Entscheidung strenger. Der zweite Filter akzeptiert noch 40 echte Regionen und zwei falsche Hinweise. Von seinen 42 Meldungen sind 40 richtig: rund 95 Prozent Precision. Gleichzeitig findet er nur noch 40 Prozent der echten Regionen. Die Meldungen werden verlässlicher, die Karte wird lückenhafter. Diese Zahlen sind ein eigenes Gedankenbeispiel und keine Messwerte der Sonnenstudie.
Die Studie wählt bewusst eine strenge Schwelle
Das Fachpapier von Jha und Kollegen kombiniert indirekte Karten mit STEREO-Beobachtungen aus den Jahren 2010 bis 2014. Die Forschenden schätzen mit einer logistischen Regression, wie wahrscheinlich ein Signal zu einer echten aktiven Region gehört. Als Merkmale dienen unter anderem magnetischer Fluss, Feldstärke und Lage.
Die Ergebnistabelle verwendet eine unabhängige Teilmenge von 2.046 Fällen: 1.437 echte Regionen und 609 falsche Hinweise. Die Schwelle von 0,73 wurde mit dem Ziel gewählt, ungefähr 90 Prozent dieser falschen Hinweise abzulehnen. Dazu passen die gemeldeten 93 Prozent Precision und 52 Prozent Recall für echte Regionen. Diese Entscheidung priorisiert wenige falsche Einträge.
Ein Wahrscheinlichkeitswert und eine Entscheidungsschwelle sind dabei verschiedene Dinge. Zunächst gibt das Modell einem Hinweis einen Wert. Anschließend entscheidet die gewählte Grenze, ob er übernommen wird. Wer die Grenze verändert, verändert die angenommenen Fälle, auch wenn die zugrunde liegenden Messungen dieselben bleiben.
Was ein verpasster Hinweis im größeren Modell bedeutet
Nach der Klassifikation folgt eine weitere Aufgabe: Die akzeptierten Regionen gehen in die Modellierung des Sonnenmagnetfelds ein. Das ist eine Verarbeitungskette. Ein falscher Eintrag kann dort etwas hinzufügen, das die Beobachtungen nicht tragen. Ein übersehener echter Eintrag lässt dagegen Information fehlen.
Welche dieser Fehler schwerer wiegt, hängt vom Zweck ab. Ein Modell, das möglichst wenig unbegründete Struktur aufnehmen soll, kann eine strenge Schwelle bevorzugen. Eine Suche, die möglichst viele mögliche Regionen zur weiteren Prüfung bereitstellen soll, würde dieselbe Abwägung anders betrachten. Eine einzige Kennzahl kann diese Entscheidung nicht für alle Anwendungen treffen.
Auch die Grundlage der Prüfung zählt. Die Studie wertet historische Daten aus. Daraus folgt noch kein gemessener Gewinn für jede heutige Warnung vor einem Sonnensturm. Für diesen nächsten Schritt müsste untersucht werden, wie sich die veränderten Karten in der jeweiligen Vorhersagekette auswirken. Die Güte einer Eingangskarte und die Güte einer Warnung sind miteinander verbunden, aber verschiedene Prüfaufgaben.
Für das Lesen solcher Technikmeldungen reichen deshalb drei Fragen: Welche Fälle wurden überhaupt geprüft? Welcher Anteil der Meldungen war richtig? Und welcher Anteil der echten Fälle wurde gefunden? Beim Sonnenmodell führen sie zum entscheidenden Ergebnis: Die hohe Verlässlichkeit der akzeptierten Hinweise wird an der gewählten Schwelle mit vielen fehlenden echten Regionen erkauft.
Der Ansatz macht Unsicherheit damit zu einer sichtbaren Entscheidung. Seine Stärke liegt nicht darin, jede Lücke zu schließen. Er erlaubt, den Preis einer strengen Auswahl zu beziffern und anschließend zu prüfen, welche Auswahl dem größeren Modell am besten hilft.
Die Trefferqualität hängt zusätzlich davon ab, wie häufig echte Fälle in der geprüften Gruppe vorkommen. Wir verändern dafür unser eigenes Beispiel, behalten aber dieselben angenommenen Erkennungsraten bei: Der Filter findet 60 Prozent der echten Fälle und akzeptiert 10 Prozent der falschen Hinweise.
Bei 100 echten und 100 falschen Fällen entstehen 60 richtige und zehn falsche Meldungen. Sind es dagegen nur zehn echte und 990 falsche Hinweise, bleiben sechs richtige und 99 falsche Meldungen. Der Anteil richtiger Meldungen sinkt auf rund sechsProzent, obwohl die angenommenen Raten des Filters gleich bleiben. Alle Zahlen sind frei gewählt.
Darum lässt sich ein Trefferanteil nicht ohne Blick auf die Fallzusammensetzung übertragen. Eine Prüfung mit vielen echten Regionen und eine Anwendung mit überwiegend unsicheren Hinweisen stellen verschiedene Ausgangslagen dar. Wer beide Kennzahlen und die untersuchte Gruppe kennt, kann den technischen Fortschritt genauer einordnen.
Quellen
- SwRI: Neues Modell zur Kartierung der Sonne (2026-10-13)
- Jha et al.: A Probabilistic Framework for Incorporating Helioseismic Far-Side Active Regions into SFT Models (2026-08-31)
- NSO: GONG Far Side (Abruf2026-10-14)
- scikit-learn: Definition der Precision (Abruf2026-10-14)
- scikit-learn: Definition des Recall (Abruf2026-10-14)
Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft.