Wer ein sehr schwaches Signal messen will, möchte möglichst lange hinhören. Bei einem Quantensensor kann genau das eine zweite Schwierigkeit erzeugen: Während der langen Messzeit dreht sich der quantenmechanische Zustand weiter, und am Ende ist unklar, wie viele Umläufe vergangen sind. Unterschiedliche Magnetfelder können dann zu ähnlichen Messergebnissen passen.
Eine neue Arbeit der North Carolina State University untersucht diesen Konflikt mit einer zweistufigen Strategie. Erst grenzt ein lernendes Verfahren den möglichen Feldbereich grob ein. Danach wählt ein weiteres Verfahren die nächsten Messparameter innerhalb dieses kleineren Bereichs. Die numerische Studie zeigt damit, weshalb bessere Messplanung ebenso wichtig sein kann wie ein empfindlicheres Bauelement.
Ein einzelner Spin wird zum Taktgeber
Die Forscher betrachten einen Stickstoff-Fehlstellen-Komplex in Diamant, häufig NV-Zentrum genannt. An einer Stelle im Kristall sitzt ein Stickstoffatom neben einer fehlenden Kohlenstoffposition. Der zugehörige Elektronenspin lässt sich als Quantensystem steuern und über sein optisches Verhalten auslesen.
Bei einer Ramsey-Messung wird eine Überlagerung vorbereitet. Unter dem Einfluss des Magnetfelds entwickelt sie während einer gewählten Zeit eine relative Phase. Ein weiterer Steuerschritt übersetzt diese Phase in messbare Wahrscheinlichkeiten. Viele solcher Ergebnisse helfen anschließend, das unbekannte Feld zu schätzen.
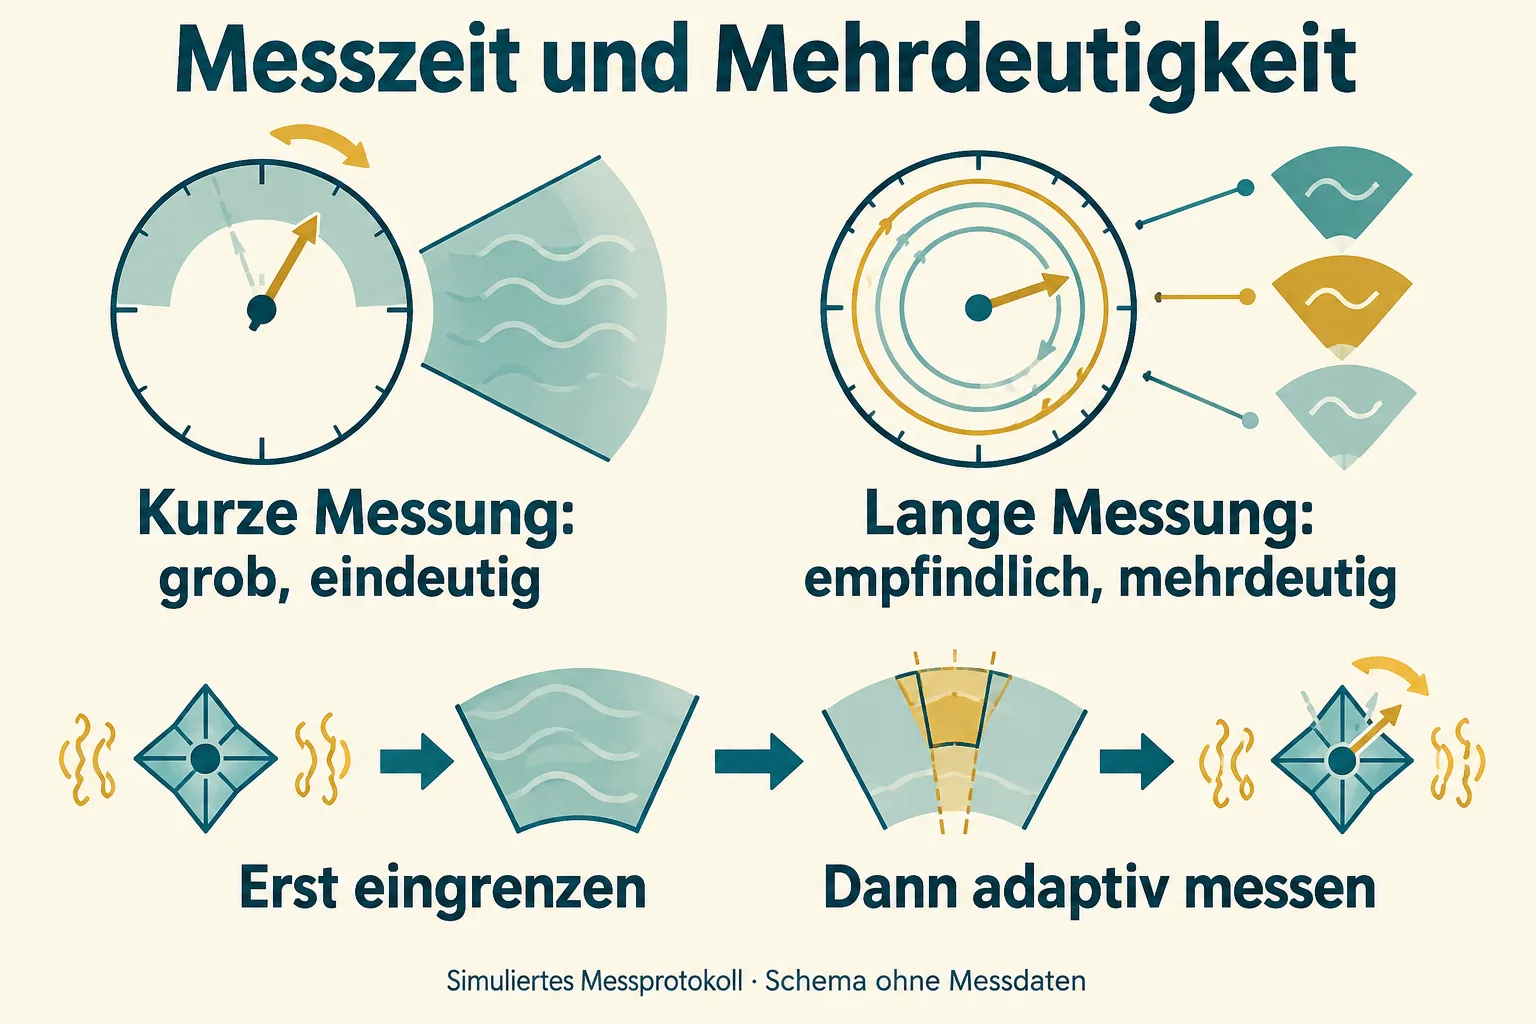
Eine längere Zeit kann eine kleine Feldänderung stärker in der Phase sichtbar machen. Das ähnelt zwei fast gleich schnell laufenden Uhren: Nach einer kurzen Weile stehen ihre Zeiger fast gleich, nach längerer Zeit deutlicher auseinander. Der Vergleich wird empfindlicher für einen kleinen Geschwindigkeitsunterschied.
Doch ein Zeiger kehrt nach einem Umlauf an dieselbe Stelle zurück. Wer nur seine Endposition kennt, kann einen zusätzlichen vollen Umlauf übersehen. Bei der Ramsey-Messung erzeugt die periodische Antwort einen entsprechenden Zuordnungsfehler. Ist der unbekannte Feldbereich groß, kann ein einziges empfindliches Messintervall deshalb mehrere plausible Antworten offenlassen.
Kurze und lange Messungen lösen verschiedene Probleme
Zu Beginn hilft ein konservativ gewähltes kürzeres Intervall, die Mehrdeutigkeit zu begrenzen. Es liefert eine gröbere Orientierung über einen größeren Feldbereich. Sobald dieser Bereich kleiner geworden ist, können empfindlichere Einstellungen sinnvoll eingesetzt werden. Welche Einstellung passt, hängt also von dem ab, was vorher bereits gelernt wurde.
Hinzu kommt das begrenzte Gesamtbudget. Der Sensor kann nicht beliebig viele lange Abfragen aneinanderreihen. Auch die Kohärenz seines Quantenzustands ist endlich. Die Planung verteilt eine knappe Ressource zwischen Orientierung und Verfeinerung.
Die am 17. Oktober in Scientific Reports veröffentlichte Arbeit von Shiqian Guo, Jianqing Liu, Thinh Le und Huaiyu Dai untersucht diese Aufteilung für einen weiten unbekannten Magnetfeldbereich, einzelne Ausleseergebnisse und begrenzte Messzeit. Die Ergebnisse stammen aus einer numerischen Auswertung des Protokolls. Das verwendete Sensormodell bildet die Grundlage, auf der die Verfahren verglichen werden.
Die erste Stufe macht den Suchbereich handlich
Das Team verwendet zunächst ein neuronales Netz für eine bayessche Schätzung. Es erhält die Ergebnisse einer Folge von Messungen mit festgehaltenen Einstellungen. Statt den gesamten unbekannten Bereich sofort mit einer einzigen empfindlichen Abfrage auflösen zu wollen, erzeugt es eine erste Eingrenzung.
Für diesen Schritt wird das Netz vorab mit simulierten Ramsey-Messungen trainiert. Im Betrieb verarbeitet das trainierte Modell die gesammelte Ergebnisfolge. Diese Trennung ist wesentlich: Die Arbeit zum Lernen des Zusammenhangs fällt vor dem späteren einzelnen Messlauf an.
Die Breite des an die nächste Stufe übergebenen Bereichs stützt sich auf eine zuvor bestimmte Fehlergröße des Netzes. Im Volltext wird sie aus einem zurückgehaltenen Testdatensatz mit bekannten wahren Frequenzen ermittelt und während der späteren Anwendung als feste empirische Kalibrierung verwendet. Wie gut diese Kalibrierung zur tatsächlichen Messsituation passt, beeinflusst damit den Start der feinen Suche.
Die erste Stufe ist also mehr als ein grober Schätzwert. Sie trifft eine Entscheidung darüber, wo die zweite Stufe ihre knappe Zeit verwenden wird. Ein zu enger Bereich an der falschen Stelle wäre ungünstig; ein unnötig breiter Bereich würde einen Teil des geplanten Vorteils wieder aufgeben.
Die zweite Stufe lernt, welche Frage als Nächstes hilft
Nach der Eingrenzung übernimmt ein Agent aus dem bestärkenden Lernen. Er wählt die Messzeit und die Kontrollphase für die nächste Abfrage. Nach dem neuen Ergebnis wird die Wahrscheinlichkeitsverteilung über die möglichen Felder aktualisiert. Daraus folgt eine neue Messentscheidung. Die Schätzung verändert damit den Messplan, und der Messplan liefert die nächste Grundlage für die Schätzung.
Für das Training teilen die Autoren den gesamten Feldbereich in Teilbereiche. Lokale Agenten lernen in diesen unterschiedlichen Umgebungen; ihre Modellaktualisierungen werden anschließend zu einem globalen Agenten zusammengeführt. Dieses föderierte Training behandelt unterschiedliche Messbereiche als verschiedene Lernaufgaben. Es bedeutet hier nicht, dass im fertigen Sensor viele Haushalte oder Kliniken gemeinsam Daten austauschen.
Der Grund für diese Aufteilung ist anschaulich: Eine Einstellung, die in einem Teilbereich besonders viel verrät, kann in einem anderen unpassend sein. Statt alle Unterschiede in einem einzigen festen Trainingsumfeld zu vermischen, soll das gemeinsame Modell aus den jeweils passenden Erfahrungen lernen.
Was der Vergleich über den Lernansatz aussagt
Die Studie stellt die zweistufige Methode mehreren Strategien gegenüber. Dazu gehören eine Variante eines bekannten adaptiven Messprotokolls, ein anderer Ansatz mit bestärkendem Lernen und eine nichtadaptive Methode mit einem neuronalen Netz. Diese Auswahl prüft verschiedene Arten, Vorwissen und Rückkopplung zu nutzen.
Der Vergleich mit einem festen Netz fragt, welchen Gewinn die Anpassung im laufenden Messprozess bringt. Der Vergleich mit einer vollständig adaptiven Strategie fragt dagegen, ob eine vorgeschaltete grobe Eingrenzung die spätere Feinarbeit erleichtert. Das sind unterschiedliche Erklärungen für einen möglichen Vorteil; beide stecken in der Konstruktion des neuen Ablaufs.
Auch die Umsetzung der Vergleichsmethoden gehört dazu. Die Autoren passen die verwendete Variante des früheren adaptiven Protokolls so an, dass der vollständige Ablauf in das betrachtete Zeitbudget passt. Die gemessene Reihenfolge ist deshalb an diese Ausführungen und Bedingungen gebunden. Für einen anderen Feldbereich oder ein anderes Zeitbudget kann sich die optimale Aufteilung zwischen den Stufen verändern.
Die Autoren berichten Verbesserungen bei Genauigkeit und Ressourcennutzung in ihren untersuchten Fällen und betrachten verschiedene Rauscheinflüsse. Für die Übertragung in einen Aufbau zählen dann zusätzlich dessen tatsächliche Ausleseeigenschaften, Steuerschritte und die Passung der Trainingsdaten. Das physikalische Bauelement und der gelernte Plan bilden gemeinsam das Messsystem.
Vorbereitung und Messlauf haben verschiedene Kosten
Ein kurzer späterer Messlauf kann auf einer aufwendigen Vorbereitung beruhen. Hier werden beide Netze vorab trainiert. Wer die gesamte Rechenlast beurteilen möchte, muss diese Vorarbeit zur wiederholten Verwendung ins Verhältnis setzen. Ein häufiger Einsatz kann andere Bedingungen schaffen als ein ständig wechselnder Sensor mit neuer Kalibrierung.
Auch die Nachprüfung ist Teil der Einordnung. Der Volltext stellt Daten und Programmcode auf Anfrage in Aussicht; der zugrunde liegende Code ist laut Verfügbarkeitsangabe nicht öffentlich. Die konkrete Umsetzung lässt sich somit nicht unmittelbar durch Herunterladen eines offenen Repositoriums reproduzieren.
Der mechanistische Gewinn der Arbeit bleibt gut verständlich: Ein Quantensensor braucht sowohl Empfindlichkeit als auch eine eindeutige Zuordnung seiner Ergebnisse. Längere Messzeit stärkt die eine Eigenschaft und kann die andere erschweren. Die vorgeschlagene Reihenfolge nutzt zunächst einen größeren Überblick und dann eine gezielte Rückkopplung. Präzision entsteht hier auch dadurch, zur richtigen Zeit die richtige nächste Messung zu wählen.
Quellen
- Shiqian Guo, Jianqing Liu, Thinh Le und Huaiyu Dai: A two-stage optimization method for wide-range single-electron quantum magnetic sensing, Scientific Reports, akzeptierte Frühfassung, veröffentlicht am 17. Oktober 2026; Original und vollständige akzeptierte PDF-Fassung am 18. Oktober 2026 gelesen.
Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft.