Ein Quantenchip ist keine gleichmäßige Landschaft. Wer geschützte Quanteninformation an einer anderen Stelle desselben Prozessors ablegt, kann ein anderes Ergebnis bekommen. Auch die Zeit, in der die Maschine ihre eigenen Fehlerhinweise ausliest, verändert den Schutz. Ein neuer Versuch auf öffentlich zugänglicher IBM-Hardware macht sichtbar, weshalb die Zahl der Qubits allein wenig über einen zuverlässigen Quantenspeicher verrät.
Shuwen Kan und Kollegen untersuchen in ihrem am 16. Oktober 2026 eingereichten Preprint einen Oberflächencode auf dem Prozessor ibm_phoenix. Größere Schutzbereiche senken in kurzen Versuchen die logische Fehlerrate. Bei längeren Speicherfolgen schrumpft dieser Vorteil. Dazwischen liegt ein Zusammenspiel aus Chipplatzierung, Messung und Auswertung, das sich Schritt für Schritt verstehen lässt.
Die Information steckt in Beziehungen
Ein gewöhnliches Bit lässt sich kopieren. Drei Kopien einer Null erlauben einen Mehrheitsentscheid, falls eine davon versehentlich zur Eins wird. Bei einem unbekannten Quantenzustand funktioniert diese einfache Strategie nicht: Er lässt sich nicht beliebig vervielfältigen. Quantenfehlerkorrektur verteilt die Information deshalb über einen gemeinsamen Zustand mehrerer physischer Qubits. Zusammen bilden sie ein logisches Qubit.
Der Oberflächencode ordnet Datenqubits und Hilfsqubits in einem Gitter an. Die Hilfsqubits werden mit Nachbarn gekoppelt und gemessen. Ihre Ergebnisse liefern Konsistenzprüfungen, aus denen ein klassischer Rechner wahrscheinliche Fehler erschließt. Dieser Decoder liest gewissermaßen die Spuren einer Störung, während die geschützte Information in den Datenqubits verbleibt.
Dabei gibt es zwei grundlegende Fehlerarten: Bitfehler und Phasenfehler. Letztere verändern die Beziehung zwischen Anteilen eines Quantenzustands. Die Arbeit untersucht deshalb zwei Speicherbasen, X und Z. Ein Eingriff kann ihnen unterschiedlich helfen. Wer beide Ergebnisse zu einer einzigen Erfolgszahl zusammenzieht, verliert genau die Unterschiede, die für die technische Verbesserung wichtig sind.
Der gleiche Bauplan trifft auf verschiedene Nachbarn
Ein quadratisches Gitter passt gut zu einem Oberflächencode, weil die benötigten Nachbarschaftsverbindungen direkt vorhanden sind. Dennoch unterscheiden sich einzelne Qubits und Kopplungen in ihrer Fehleranfälligkeit. Ein Schutzbereich ist damit auch eine Auswahl konkreter Bauteile. Schon seine Verschiebung verändert, welche dieser Bauteile an der Arbeit beteiligt sind.
Im Ausgangsversuch prüfen die Autoren 88 nutzbare Platzierungen eines kleinen Codes. Nach fünf Messrunden liegt die logische Fehlerwahrscheinlichkeit beim Z-Speicher je nach Platz zwischen 3,4 und 17,2 Prozent, beim X-Speicher zwischen 6,0 und 39,8 Prozent. Diese Spannen beschreiben unterschiedliche Positionen auf demselben untersuchten Prozessor unter dem Ausgangsablauf. Sie sind keine Rangliste verschiedener Quantencomputer.
Für weitere Untersuchungen wählt das Team geeignete Bereiche aus. Das ist ein sinnvoller experimenteller Schritt, prägt aber auch die Bedeutung späterer Bestwerte: Der gemessene Schutz gehört zu einer bestimmten Anordnung auf einer bestimmten Hardware. Ein Code hat auf dem Papier eine geometrische Größe; im Labor bekommt diese Geometrie eine Adresse.
Beim Auslesen warten die wichtigsten Qubits
Die Schutzprüfung wiederholt sich in Runden. Kopplungen übertragen Fehlerhinweise auf Hilfsqubits, anschließend werden diese ausgelesen und gegebenenfalls zurückgesetzt. Während der Messung warten die Datenqubits. Ihr empfindlicher Zustand entwickelt sich auch dann weiter, wenn der Ablauf gerade keine nützliche Operation an ihnen ausführt.
Im Standardablauf beansprucht das Auslesen rund 1,94 Mikrosekunden einer etwa 2,39 Mikrosekunden langen Runde. Die Messung belegt also ungefähr vier Fünftel der Zeit. Eine kürzere Variante benötigt 1,14 Mikrosekunden. Das erklärt, weshalb ausgerechnet die vermeintliche Kontrollarbeit ein großer Hebel ist: Jeder wiederholte Messvorgang verlängert die Zeit, in der die eigentliche Information Störungen ausgesetzt bleibt.
Hinzu kommt das Zurücksetzen der Hilfsqubits. IBM beschreibt für Nighthawk r2 einen eigenen Reset-Mechanismus je Qubit, der auch im laufenden Schaltkreis verfügbar ist. Die Forscher kombinieren kurze Messung und integrierten Reset mit einem Echo auf den wartenden Datenqubits. Solche gezielten Pulse können bestimmte Phasenstörungen teilweise ausgleichen.
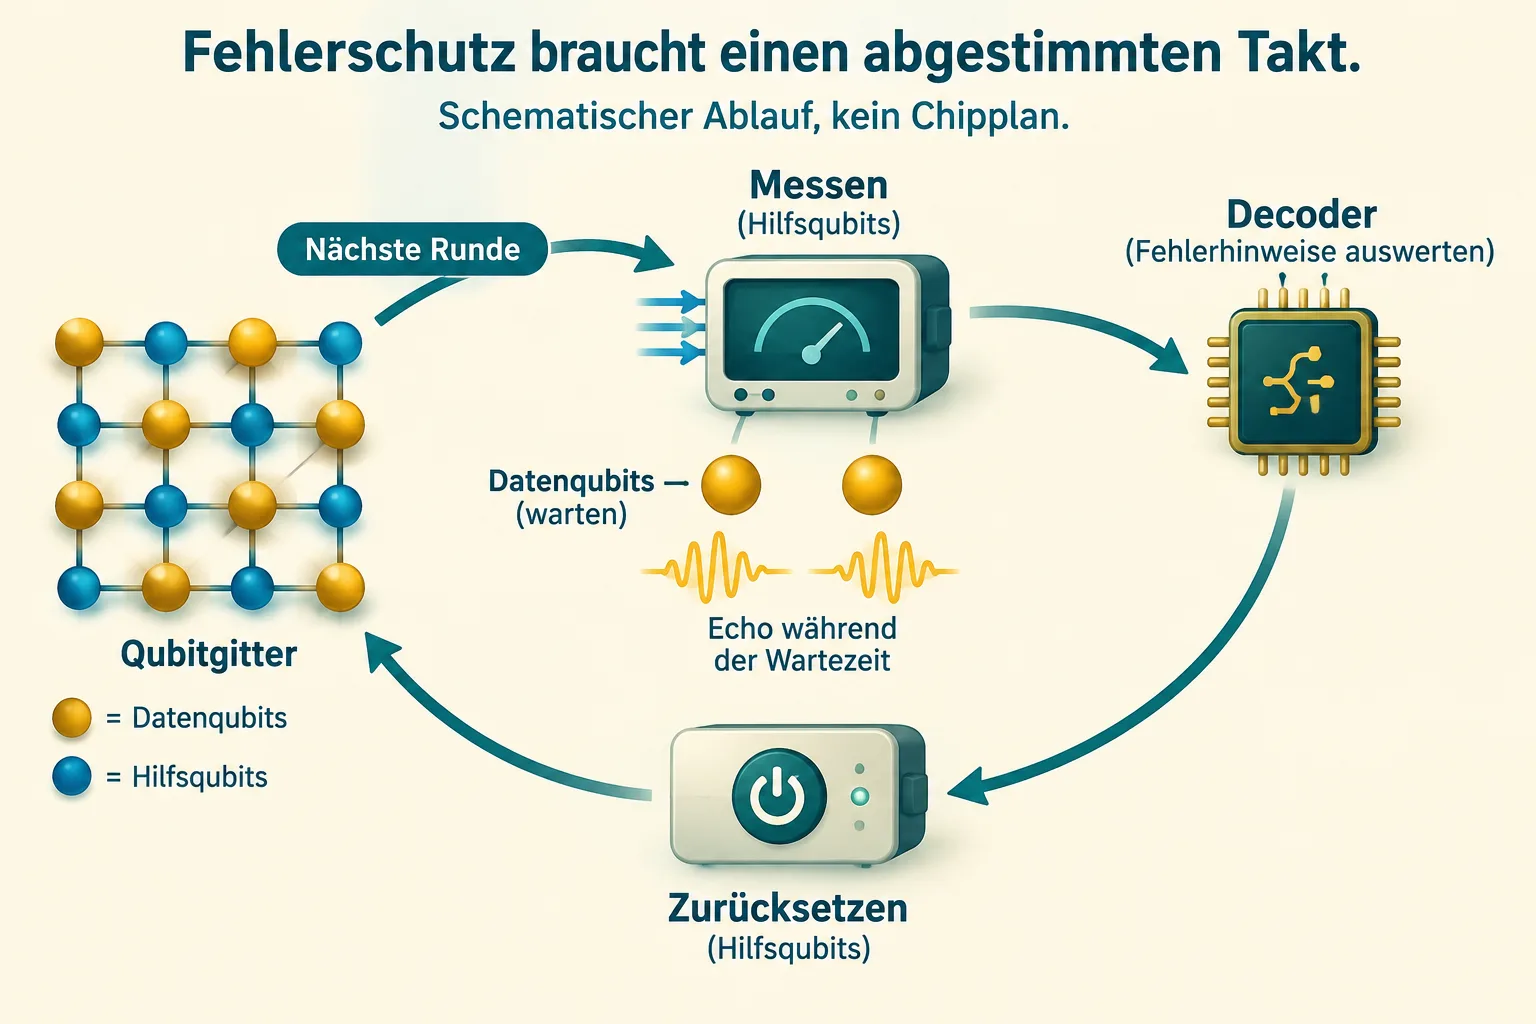
Ein längeres Echo ist allerdings nicht automatisch besser. Reicht die Pulsfolge über das Messfenster hinaus, verlängert sie die Runde und schafft zusätzliche Wartezeit. Die Untersuchung findet dann wieder steigende Fehlerraten. Der Mechanismus ähnelt einer gut gemeinten Reparatur, die länger dauert als die Pause, in der sie stattfinden sollte. Entscheidend ist, ob die einzelnen Maßnahmen zeitlich zusammenpassen.
Mehr Abstand hilft – unter konkreten Bedingungen
Der Codeabstand beschreibt, wie lang eine unbemerkte Fehlerkette mindestens sein muss, um die geschützte Information zu verändern. Ein größerer Abstand kann deshalb mehr Schutz bringen. Er benötigt aber zusätzliche Qubits und Operationen, die ihrerseits Fehler verursachen können. Das Verhältnis zwischen gewonnenem Schutz und zusätzlicher Fehlerlast entscheidet über den Nutzen.
Mit dem abgestimmten Ablauf senkt eine Vergrößerung der geschützten Distanz von drei auf sechs die Fehler pro Runde in den ausgewählten kurzen Versuchen ungefähr auf die Hälfte. Die andere Distanz des rechteckigen Codes bleibt dabei bei drei. Gegenüber dem Ausgangsablauf verbessert die Kombination aus kurzer Messung, Reset und Echo die untersuchten Formen ebenfalls, besonders deutlich beim X-Speicher.
Auch der Decoder gehört zu diesem Ergebnis. Zwei Auswerteverfahren können aus denselben Messaufzeichnungen unterschiedlich zuverlässig auf die ursprüngliche Information schließen. Die Arbeit vergleicht verschiedene Verfahren und Fehlermodelle. Eine genauere Anpassung einzelner Fehlerstatistiken hilft dabei nicht jedem Decoder. Hardware, Modell und Auswertung müssen gemeinsam funktionieren; eine bessere Teilkomponente garantiert noch keinen besseren Speicher.
Ein Speicher muss seinen Vorteil behalten
Für eine längere Rechnung zählt, ob der Schutz viele Runden übersteht. In den Versuchen bis 150 Runden verliert der größere Code einen erheblichen Teil seines anfänglichen Vorsprungs. Gleichzeitig häufen sich Fehlerhinweise, deren Zusammenhang über mehrere Runden bestehen bleibt. Als mögliche Ursachen diskutieren die Autoren unter anderem Zustände außerhalb des vorgesehenen Rechenbereichs und langsame Veränderungen der Umgebung. Die aufgezeichneten binären Messergebnisse lassen die genaue Ursache offen.
Eine unabhängige Nature-Arbeit von Google Quantum AI zum Willow-Prozessor zeigt, wie ein anderer Aufbau diese Aufgabe behandelt: Dort gehört die aktive Entfernung solcher höheren Zustände aus Datenqubits zum wiederholten Ablauf. Die Forscher demonstrieren zudem Schutz mit einem Echtzeitdecoder. Unterschiedliche Hardware, Codes und Auswertung erlauben daraus keinen direkten Zahlenvergleich mit dem IBM-Versuch. Gemeinsam machen beide Arbeiten aber verständlich, weshalb dauerhafter Fehlerschutz eine Aufgabe des gesamten Systems ist.
Beim nächsten Bericht über einen größeren Quantencode lohnt deshalb der Blick auf drei zusammenhängende Fragen: Welche physischen Qubits tragen ihn, wie läuft jede Schutzrunde ab und bleibt der Vorteil über längere Zeit erhalten? Erst diese Verbindung macht aus zusätzlichem Chipplatz einen belastbaren Speichergewinn.
Quellen
- Shuwen Kan et al.: Demonstration of Logical Error Suppression in a Surface Code Memory on a Cloud-Accessible IBM Superconducting Processor, Preprint, 16. Oktober 2026.
- IBM Quantum: IBM Quantum Nighthawk r2—more circuits, faster, technische Herstellerbeschreibung, abgerufen am 20. Oktober 2026.
- Google Quantum AI and Collaborators: Quantum error correction below the surface code threshold, Nature 638, 920–926 (2025), aktuelle Fassung mit Korrekturhinweis, abgerufen am 20. Oktober 2026.
Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft.