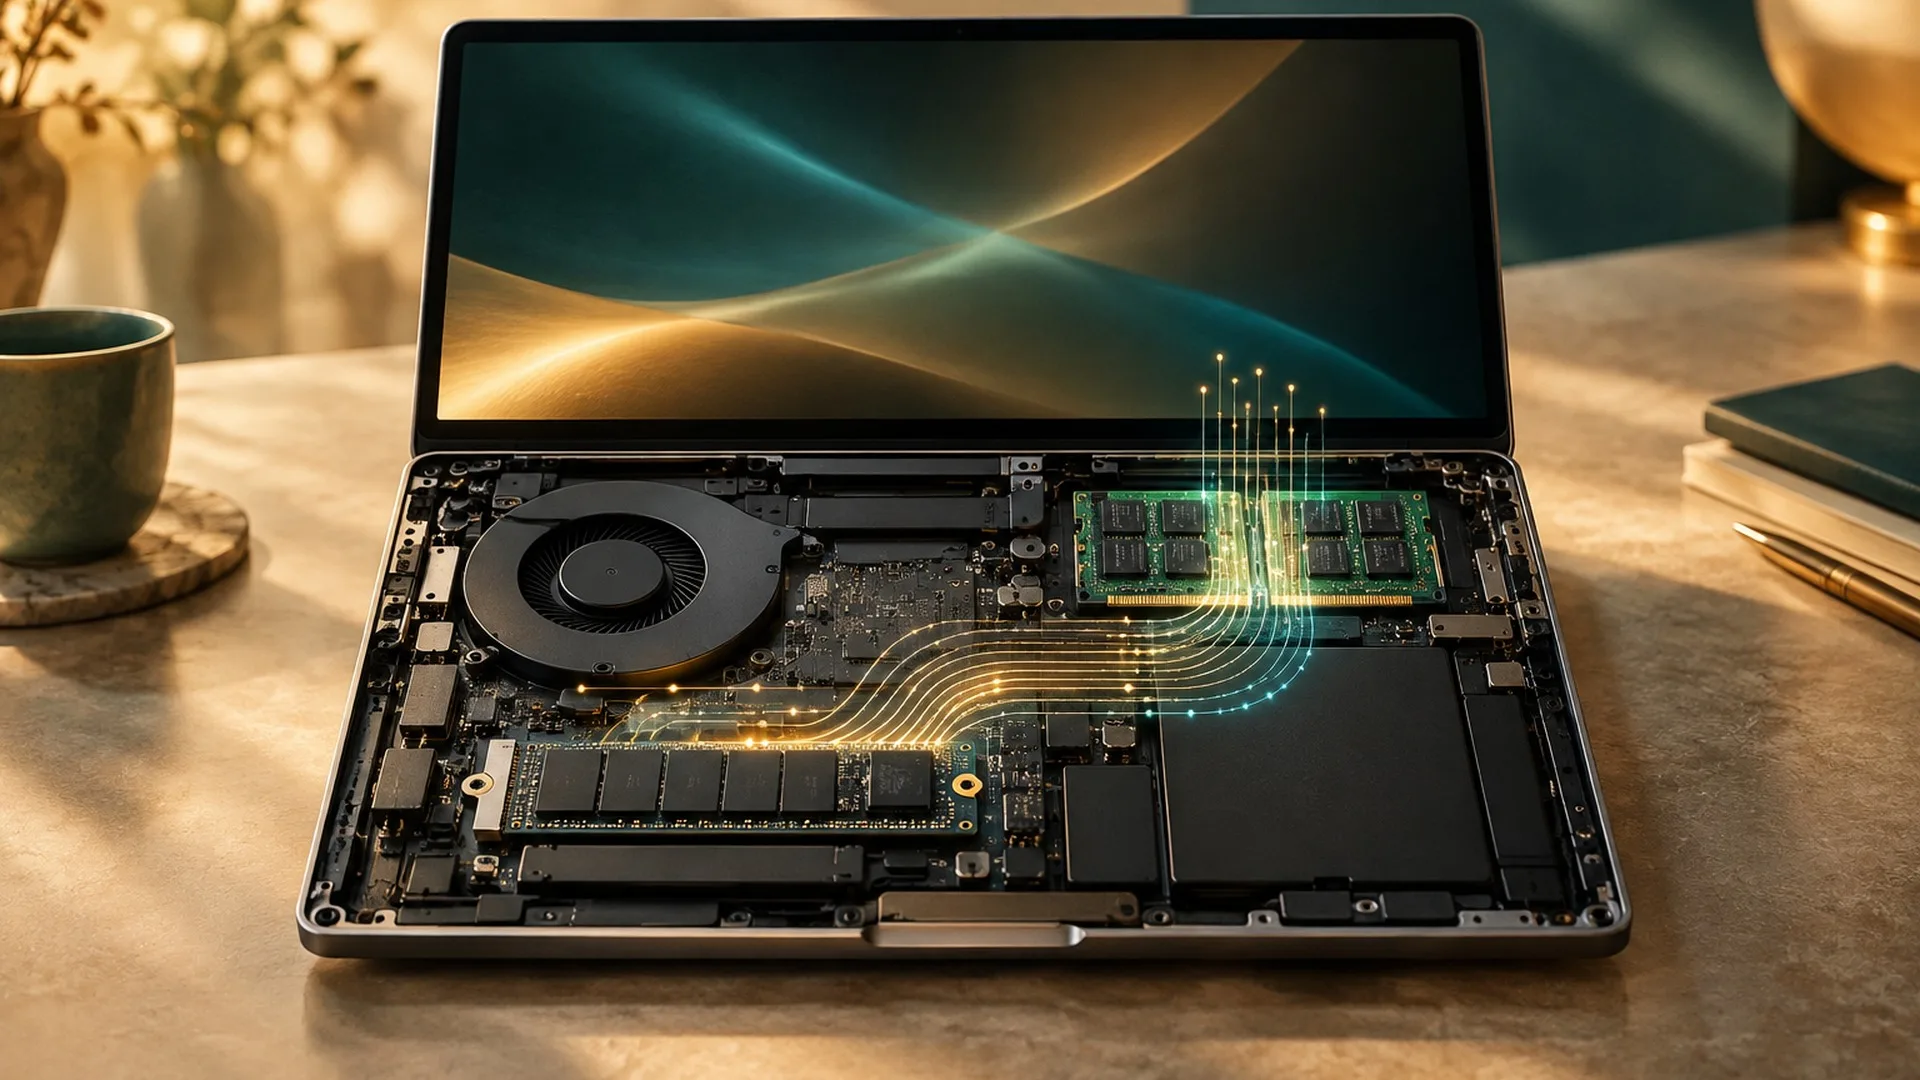
Ein großes KI-Modell muss nicht vollständig im schnellen Arbeitsspeicher liegen, um eine Antwort zu erzeugen. Bei einer Architektur mit vielen spezialisierten Teilnetzen lassen sich benötigte Teile von einer SSD nachladen. Ein Entwickler hat diesen Ansatz auf einem Mac mit 32 Gigabyte Arbeitsspeicher ausprobiert. Der Preis für den geringeren Speicherbedarf ist zusätzliche Datenbewegung: Wie schnell die Antwort entsteht, hängt davon ab, welche Teile schon im Cache liegen und welche erst von der SSD kommen müssen.
Der dokumentierte Versuch zeigt eine konkrete Möglichkeit, ein großes Modell auf begrenzter Hardware auszuführen. Er ist kein allgemeiner Geschwindigkeitsvergleich für alle Rechner und Modelle.
Warum ein Modell überhaupt Experten hat
Ein Sprachmodell verarbeitet Text in kleinen Einheiten, den Tokens. Ein Token kann beispielsweise ein Wort oder ein Wortteil sein. Um das nächste Token zu bestimmen, führt das Modell viele Rechenschritte mit gespeicherten Zahlen aus. Diese Zahlen heißen Gewichte. Bei großen Modellen brauchen sie viel Speicher.
Eine Mixture-of-Experts-Architektur, kurz MoE, verteilt einen Teil dieser Arbeit auf mehrere Teilnetze, die Experten heißen. Ein zusätzlicher Bestandteil, der Router, wählt für ein Token nur wenige davon aus. Die Dokumentation von Hugging Face beschreibt diese Auswahl als Bestandteil der Expertenarchitektur. Das Wort Experte bezeichnet hier ein Teilnetz des Modells, keinen menschlichen Fachmann.
Das ist der Ausgangspunkt für das Nachladen: Wenn bei einem einzelnen Schritt nur ein Teil der Experten gebraucht wird, müssen nicht zwingend alle ihre Gewichte gleichzeitig im Arbeitsspeicher bereitliegen. Das vollständige Modell verschwindet dadurch nicht. Seine gespeicherten Daten müssen weiterhin irgendwo vorhanden sein und zum benötigten Zeitpunkt zur Verfügung stehen.
SSD als Vorrat, RAM als Zwischenlager
Eine SSD speichert Daten dauerhaft. Der Arbeitsspeicher hält Daten bereit, die ein Programm gerade benötigt. Beim Expert Streaming liegen die Expertengewichte auf der SSD; ein begrenzter Bereich im RAM dient als Cache, also als Zwischenlager. Fragt die Berechnung einen Experten an, der bereits im Cache liegt, kann sie auf die vorhandene Kopie zugreifen. Fehlt er, muss das System seine Daten von der SSD nachladen.
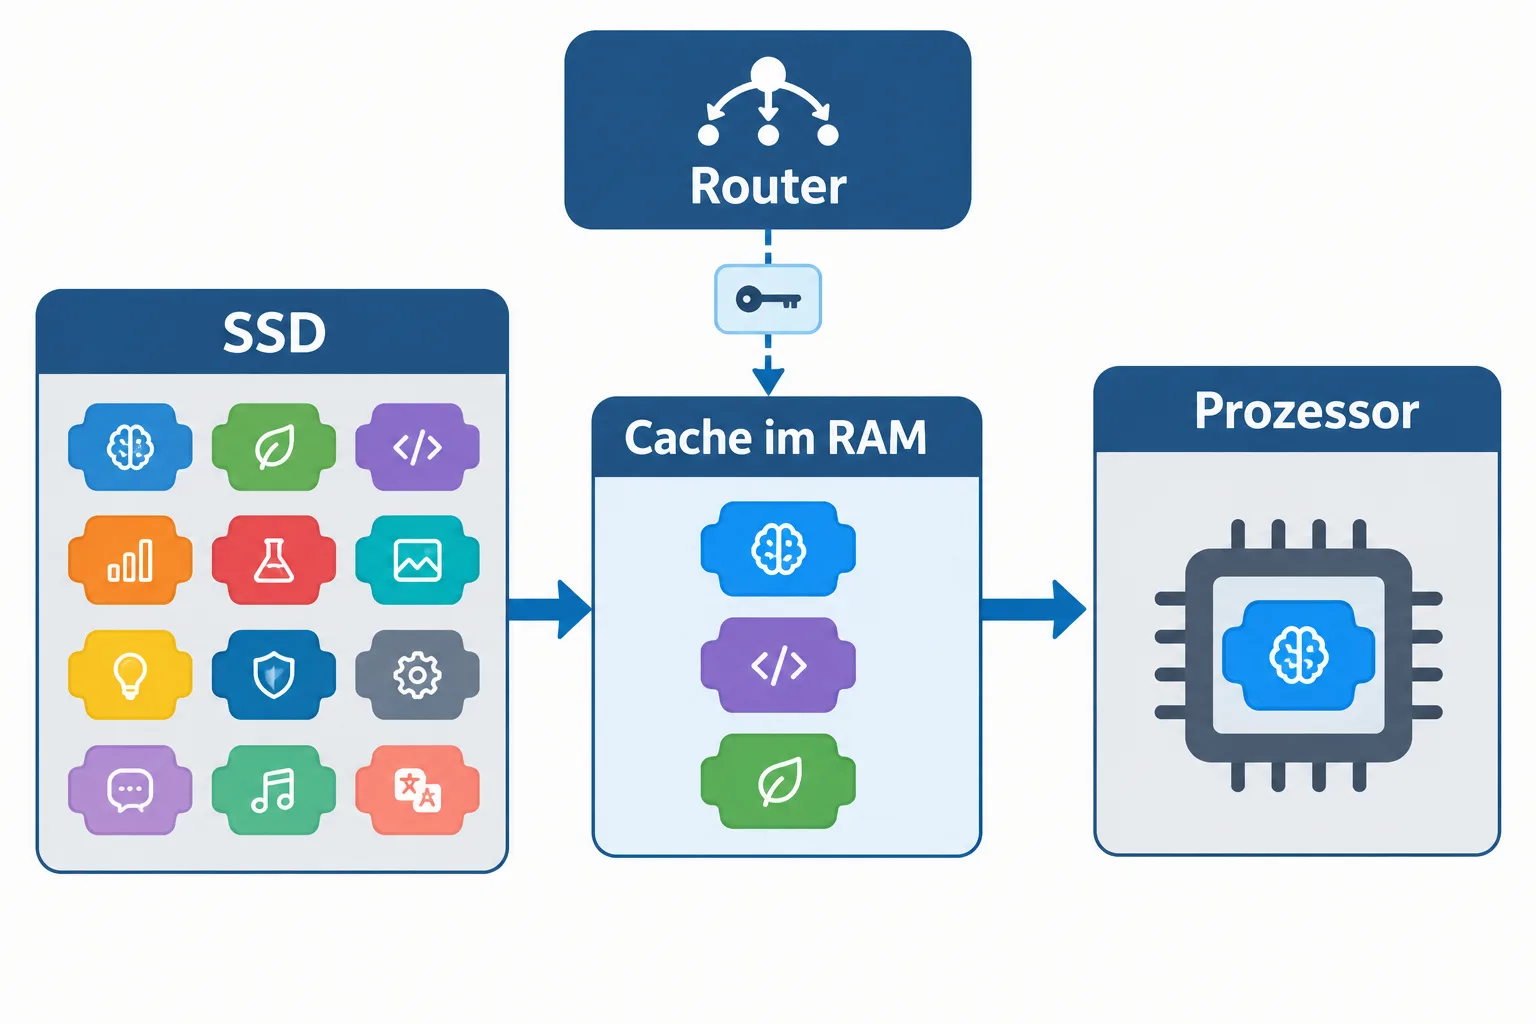
Das Zwischenlager ist begrenzt. Sind viele unterschiedliche Experten gefragt, müssen gespeicherte Daten Platz für andere machen. Werden dagegen dieselben Experten wiederholt benötigt, können sie im Cache bleiben. Wie oft das gelingt, beeinflusst die Menge der Daten, die erneut von der SSD gelesen werden muss.
Man kann sich das wie eine kleine Werkbank neben einem großen Materiallager vorstellen: Was schon auf der Bank liegt, ist schnell griffbereit. Für anderes Material muss jemand zum Lager gehen. Der Vergleich erklärt den Engpass, sagt aber nicht voraus, wie häufig das Modell tatsächlich dieselben Experten auswählt.
Was der Versuch auf dem Mac zeigt
Im Bericht beschreibt der Entwickler einen M5-Mac mit 32 GB Arbeitsspeicher. Die Expertengewichte des untersuchten Modells umfassten laut Bericht zunächst 121 GB in einem FP8-Format. Durch eine Quantisierung auf drei Bit wurden daraus 49 GB auf der SSD. Quantisierung bedeutet hier, dass die Gewichte mit weniger Bits dargestellt werden. So sinkt der Speicherbedarf; die Zahlen sind dabei weniger fein abgestuft.
Für den Cache wurden 12 GiB vorgesehen. Bei einem Prompt mit 6.000 Tokens nennt der Bericht einen Spitzenspeicherbedarf von 25,4 GiB. Ein Prompt ist die Eingabe an das Modell. Die Werte beziehen sich auf die beschriebene Konfiguration; GB und GiB sind unterschiedliche Maßeinheiten und sollten nicht einfach gleichgesetzt werden.
Der Entwickler berichtet nach Optimierungen außerdem von 13,9 erzeugten Tokens pro Sekunde. Für den Vergleich mit Strata nennt er 14,8 Tokens pro Sekunde, jeweils bei 200 erzeugten Tokens, demselben Rechner und denselben Prompts. Die Zahlen stammen aus dem Entwicklerbericht. Sie zeigen, was unter diesen Bedingungen gemessen wurde, nicht eine unabhängig bestätigte Rangliste sämtlicher Lösungen.
Weshalb weniger RAM nicht automatisch schneller bedeutet
Das Verfahren verschiebt eine Grenze. Ein Modell, dessen Expertengewichte nicht vollständig in den verfügbaren Arbeitsspeicher passen, kann durch das Nachladen trotzdem nutzbar werden. Dafür entsteht ein neuer Flaschenhals: Die Daten müssen zwischen SSD und Speicher übertragen werden. Ein Cache-Treffer spart diesen Lesevorgang; bei einem Fehltreffer muss die Berechnung auf die benötigten Gewichte warten.
Die praktische Geschwindigkeit hängt deshalb nicht nur von der Größe des Modells ab. Auch die verfügbare Bandbreite, die Cache-Größe und die Abfolge der angeforderten Experten spielen eine Rolle. Ein größerer Cache benötigt mehr RAM, kann aber mehr Gewichte bereithalten. Ein kleinerer Cache lässt mehr Speicher für anderes frei, erhöht jedoch möglicherweise den Nachladebedarf. Welche Einstellung am besten passt, muss am konkreten System ermittelt werden.
Auch der Energiebedarf lässt sich nicht aus der Mac-Messung ablesen. Eine separate Modellanalyse untersucht SSD-Offloading auf einer anderen Hardwarekonfiguration und beschreibt für ihren Vergleich einen bis zu zwölffachen Energiebedarf pro Token gegenüber HBM, einem schnellen Speicher nahe am Prozessor. Das ist kein Messwert für den Mac-Versuch. Es zeigt, warum geringerer Bedarf an schnellem Speicher und geringerer Energieverbrauch verschiedene Fragen sind.
Der Versuch macht damit einen technischen Tausch sichtbar: Das Modell gewinnt Spielraum beim Arbeitsspeicher, indem es einen Teil der Gewichte bei Bedarf nachlädt. Ob sich das im Alltag lohnt, entscheiden die konkrete Modellgröße, der Cache, der Datentransport und die Anforderungen an Antwortzeit und Ressourcen.
Quellen
- Hugging Face: MoE Expert Streaming, Entwicklerbericht
- Hugging Face: Experts Interface, Dokumentation
- arXiv: Analyse zu SSD-Offloading und Energiebedarf
Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft.