Wenn ein Auto weniger Kraftstoff pro Kilometer verbraucht, muss seine nächste Fahrt nicht weniger Kraftstoff benötigen. Sie kann auch länger werden. Ein ähnlicher Zusammenhang steckt in Microsofts Bericht über MAI-Base-2. Das Unternehmen beschreibt eine verbesserte Trainingsmethode und erklärt zugleich, die gewonnene Effizienz in ein größeres Modell investiert zu haben.
Der am 15. Oktober veröffentlichte Bericht handelt vom abgeschlossenen Vortraining eines Basismodells. Die anschließende Anpassung an praktische Aufgaben läuft noch. Für Leser ist deshalb zunächst eine andere Frage ergiebiger als ein erwarteter Platz in einer Chatbot-Rangliste: Was bedeutet Effizienz, wenn Modellgröße, Daten und Recheninfrastruktur gemeinsam verändert werden?
Zwei Größen eines Modells
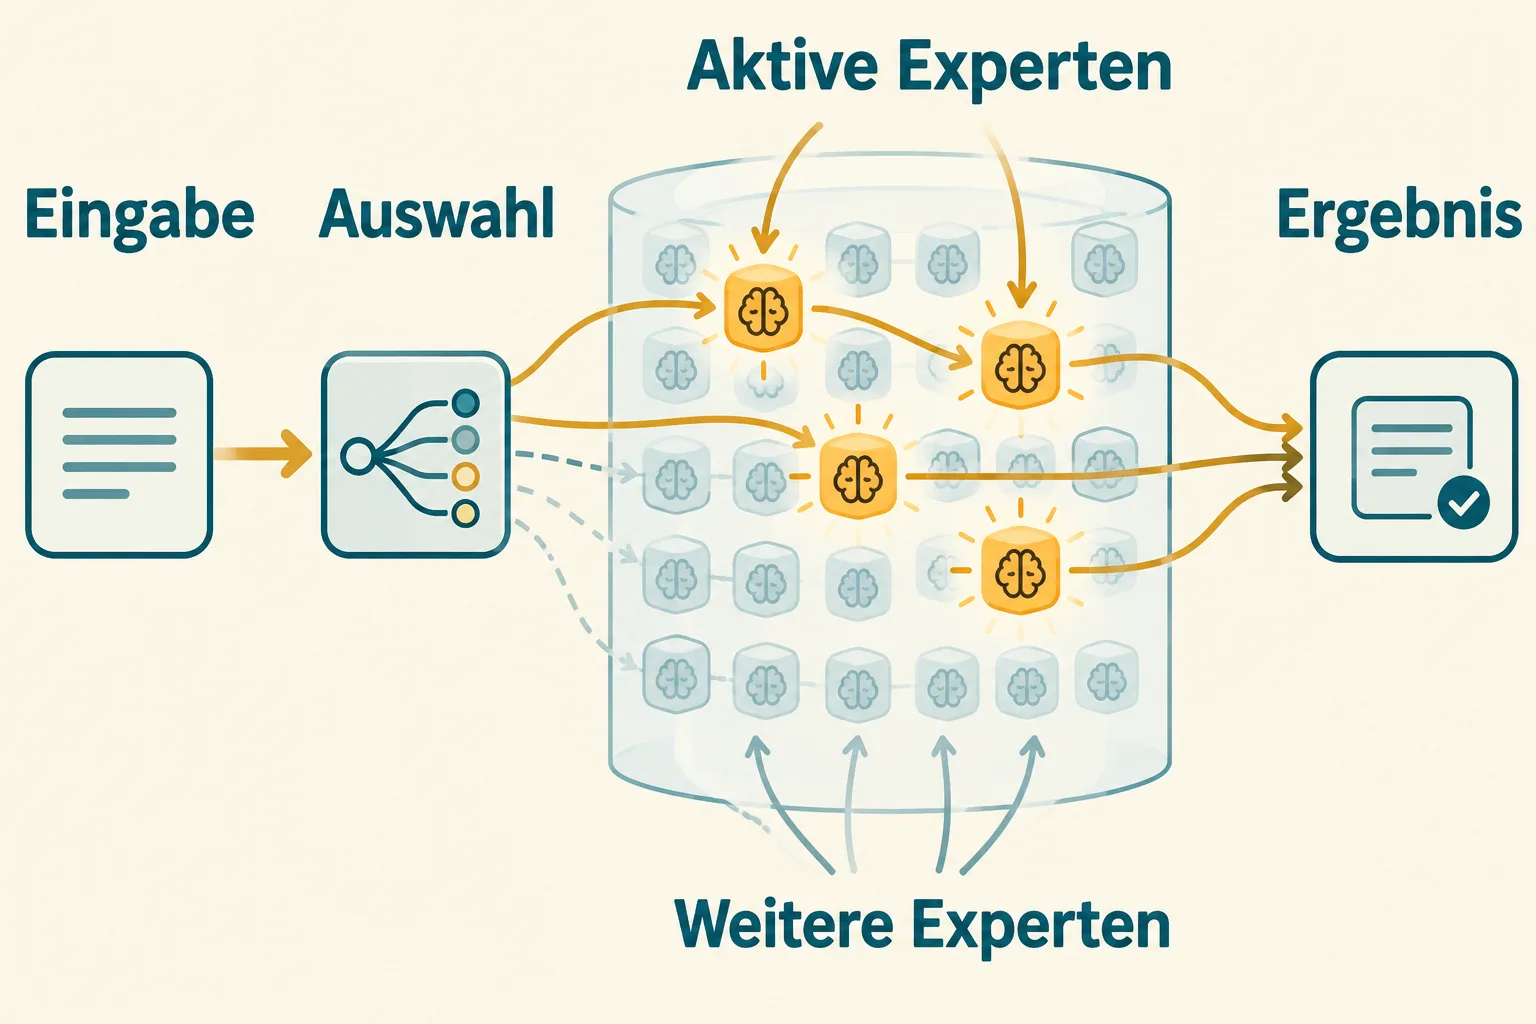
MAI-Base-2 besitzt nach Microsofts Angaben insgesamt 2,8 Billionen Parameter, von denen bei der Verarbeitung 80 Milliarden aktiv sind. Parameter sind die während des Trainings gelernten Zahlen, mit denen ein Modell Eingaben verarbeitet. Die beiden Angaben unterscheiden sich, weil das Modell auf eine Architektur mit spezialisierten Teilnetzen setzt, einen sogenannten Mixture of Experts.
Anschaulich gleicht das einem großen Betrieb, in dem nicht jede Abteilung jeden einzelnen Vorgang bearbeitet. Eine Zuordnung entscheidet, welche Experten für die aktuelle Eingabe rechnen. Der gesamte Betrieb kann dadurch mehr Wissen in seinen Gewichten tragen, als bei jedem Schritt gleichzeitig verwendet wird.
Die Gesamtzahl der Parameter bleibt trotzdem technisch relevant. Diese Zahlen müssen gespeichert und innerhalb der Infrastruktur verfügbar gemacht werden. Die aktive Zahl beschreibt wiederum einen Teil der laufenden Rechenarbeit. Wer nur eine der Größen betrachtet, übersieht deshalb entweder den Speicheraufwand oder die Arbeitsteilung bei der Verarbeitung.
Auch die Spezialisierung hat ihren Preis. Eingaben müssen zu den gewählten Teilnetzen gelangen und Ergebnisse anschließend wieder zusammengeführt werden. Wenn besonders viele Eingaben dieselben Experten benötigen, entstehen ungleich verteilte Lasten. Dann kann ein Teil der Hardware warten, während ein anderer Teil noch beschäftigt ist.
Rechenoperationen und Zeit laufen auseinander
Das erklärt, warum ein mathematisch sparsameres Verfahren in der Praxis nicht zwingend schneller ist. Es kann weniger Operationen benötigen, aber zusätzliche Kommunikation verursachen. Der Gewinn wird dann teilweise vom Datentransport aufgezehrt. Hardware und Trainingsverfahren müssen zusammenpassen.
Microsoft beschreibt dafür Änderungen an der Verarbeitung stark ausgelasteter Experten. Statt überzählige Eingaben zu verwerfen, arbeitet das System sie gegebenenfalls in weiteren Runden ab. Die Organisation soll zugleich den Speicherbedarf besser kontrollierbar machen. Die wesentliche Idee ist verständlich: Ungleich verteilte Arbeit wird in einen geregelten Ablauf gebracht, anstatt dafür beliebig große Reserven vorzuhalten.
Für eine Beurteilung gibt es deshalb mindestens zwei sinnvolle Stoppuhren. Die eine zählt rechnerische Arbeit in FLOPs, also Gleitkommaoperationen. Die andere misst die tatsächlich vergangene Zeit bis zu einem gewünschten Ergebnis. Die erste hilft, die Methode zu verstehen. Die zweite enthält zusätzlich die Eigenschaften des realen Systems.
Stellen wir uns zwei Küchen vor, die dasselbe Gericht kochen. Eine benötigt weniger Handgriffe, hat aber nur eine schmale Tür zwischen Vorbereitung und Herd. Die andere macht einige zusätzliche Handgriffe und kann Zutaten ohne Wartezeit weitergeben. Eine reine Zählung der Handgriffe würde den Engpass der ersten Küche übersehen. Bei verteiltem KI-Training übernehmen Speicher und Datenverbindungen einen Teil dieser Rolle.
Was der große Effizienzfaktor misst
Der von Microsoft genannte Vergleich von ungefähr vier- bis zwölfmal höherer FLOPs-Effizienz bezieht sich auf ein bestimmtes Verfahren. Das Unternehmen passt Skalierungsfunktionen an eigene Modellversuche an und schätzt, wie viel Rechenarbeit seine Trainingsmethode für das Niveau eines externen Basismodells benötigen würde.
Gemessen wird dabei die Vorhersagegüte auf zurückgehaltenem Text, ausgedrückt in Bits pro Byte. Vereinfacht gefragt: Wie überraschend ist dem Modell der tatsächliche Text? Ein niedrigerer Wert bedeutet in diesem Vergleich eine bessere Vorhersage. Die Byte-Größe hilft, Modelle mit unterschiedlichen Zerlegungen von Text in Tokens nebeneinander zu betrachten.
Ein solches Maß ist nützlich, bleibt aber an die gewählten Daten und die Methode gebunden. Eine Modellierung des Rechenaufwands für ein Vorhersageziel ist eine andere Aussage als die Laufzeit einer fertigen Anwendung. Für einen Programmierassistenten interessieren beispielsweise zusätzlich die Zuverlässigkeit seiner Änderungen und die Kosten eines vollständig erledigten Auftrags.
Der Unterschied ist keine Nebensache. Ein Modell kann Text besser vorhersagen und anschließend durch weiteres Training lernen müssen, Anweisungen passend zu befolgen. Deshalb steht der Status des Basismodells früh in der Nachricht. Der Bericht erklärt einen Trainingsschritt innerhalb der Entwicklung eines Produkts.
21 Prozent und 89 Prozent haben verschiedene Nenner
Microsoft nennt für den Trainingslauf zwei weitere Kennzahlen: 21 Prozent durchschnittliche Modell-FLOPs-Auslastung und 89 Prozent Goodput. Die erste vergleicht die gezählte Modellrechenarbeit mit einer definierten theoretischen Rechenleistung der GPUs. Die zweite bezeichnet den Zeitanteil, in dem das Training voranschritt.
Beide Werte können gleichzeitig zutreffen. Ein System kann während eines großen Teils der Zeit Fortschritte machen und dennoch weit unter seiner theoretischen Spitzenrechenleistung bleiben. Kommunikation, Speicherzugriffe und unterschiedliche Arbeitsschritte beeinflussen, wie viele der möglichen Operationen tatsächlich für den gezählten Modellteil genutzt werden.
Man sollte die Prozentsätze deshalb weder voneinander abziehen noch als direkten Wirkungsgrad des gesamten Rechenzentrums behandeln. Ihre Bezugsgrößen beantworten unterschiedliche Betriebsfragen. Für eine Energiebilanz wären zusätzlich gemessene elektrische Leistungen, Laufzeiten und eine klare Systemgrenze nötig.
Ein guter Vergleich hält das Ziel fest
Wer Trainingsfortschritte vergleichen möchte, kann zunächst eine Zielgüte festlegen und anschließend nach dem Aufwand bis zu diesem Punkt fragen. Dann werden zwei Methoden am gleichen Ziel gemessen. Ein anderer Vergleich hält das Rechenbudget konstant und untersucht, welche Güte damit erreicht wird. Beide Perspektiven sind sinnvoll, führen aber zu unterschiedlichen Aussagen.
Beim ersten Ansatz bedeutet der Gewinn weniger Aufwand für eine bekannte Leistung. Beim zweiten kann derselbe Gewinn in ein besseres Ergebnis fließen. Genau deshalb sollte eine Effizienzangabe zusammen mit der festgehaltenen Größe gelesen werden. Andernfalls wird aus einer technischen Verbesserung vorschnell eine Aussage über die Größe des nächsten Trainingslaufs.
Hinzu kommt die Wiederholung von Trainingsdaten. Wenn ein kleiner Versuch dieselben Beispiele anders oft sieht als ein großer, verändert sich seine Lernaufgabe. Die Übertragung zwischen Modellgrößen muss deshalb berücksichtigen, welche Daten neu sind und welche erneut vorkommen. Microsofts Bericht behandelt diese Abstimmung als eigenen Teil der Skalierung. Ein kleiner Test soll schließlich die Bedingungen des großen Laufs möglichst sinnvoll vorwegnehmen.
Der Gewinn kann in mehr Modell fließen
Der große Trainingslauf verdeutlicht die wirtschaftliche Entscheidung hinter der Technik. Microsoft setzt Verbesserungen daran ein, mit vorhandenen Ressourcen ein leistungsfähigeres Modell zu trainieren. Effizienz schafft damit Handlungsspielraum. Ob dieser für geringere Kosten, kürzere Entwicklungszeit oder größere Modelle verwendet wird, ist eine weitere Entscheidung.
Dieser Zusammenhang ist für Unternehmen relevant, die später KI-Dienste einkaufen. Ein Fortschritt im Training kann das Angebot verbessern, ohne dass sich daraus unmittelbar ein bestimmter Preis oder Verbrauch pro Nutzer ergibt. Zwischen Trainingsmethode und Kundenrechnung liegen Modellwahl, Betrieb, Auslastung und Produktgestaltung.
MAI-Base-2 macht vor allem sichtbar, wie eng die nächste Modellgeneration mit ihrer Infrastruktur verwoben ist. Die Zahl der Parameter erzählt einen Teil der Geschichte. Wie die Arbeit verteilt wird, wie Daten ausgewählt werden und woran die Entwickler den Erfolg messen, bestimmt mit, was aus dieser Größe wird.
Quellen
Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft.