Ein Assistent soll einen Termin im Kalender vorbereiten. Die Anfrage ist kurz, aber auf dem Gerät müssen mehrere Bausteine zusammenarbeiten: Ein Sprachmodell versteht den Wunsch, eine Laufzeit führt das Modell auf der Hardware aus und eine Anwendung verbindet es mit einem Kalender. Erst diese Kombination entscheidet, ob aus einer Antwort eine brauchbare Handlung wird.
Lokale KI kann dabei mehr Kontrolle über die Verarbeitung persönlicher Eingaben ermöglichen. Doch lokal bedeutet zunächst nur, dass die Modellberechnung auf dem eigenen Gerät stattfindet. Ob eine Kalenderabfrage Daten ins Netz sendet, wie schnell die Antwort kommt und ob der Assistent einen Fehler abfängt, hängt vom gesamten System ab.
Zwei Entwicklungen zeigen die unterschiedlichen Ebenen: Das Projekt llama.cpp stellt Software zum Ausführen von Modellen bereit. Tether AI Research hat mit BotPsy ein kleines Sprachmodell vorgestellt, das auf Werkzeugaufrufe trainiert ist. Zusammengenommen illustrieren sie eine Richtung: Nützliche lokale Assistenten brauchen sowohl passende Modelle als auch verlässliche Verbindungen zur übrigen Software.
Vom Wunsch zum Werkzeug
Ein Sprachmodell erzeugt zunächst eine Ausgabe. Soll es einen Termin vorbereiten, muss die Anwendung diese Ausgabe so verwenden, dass ein Kalenderprogramm sie versteht. Das Modell könnte etwa ein Werkzeug auswählen und Datum und Uhrzeit als Argumente übergeben. Der Kalender verarbeitet den Aufruf und meldet das Ergebnis zurück. Welche Werkzeuge verfügbar sind und ob ein Termin sofort gespeichert wird, bestimmt die Anwendung.
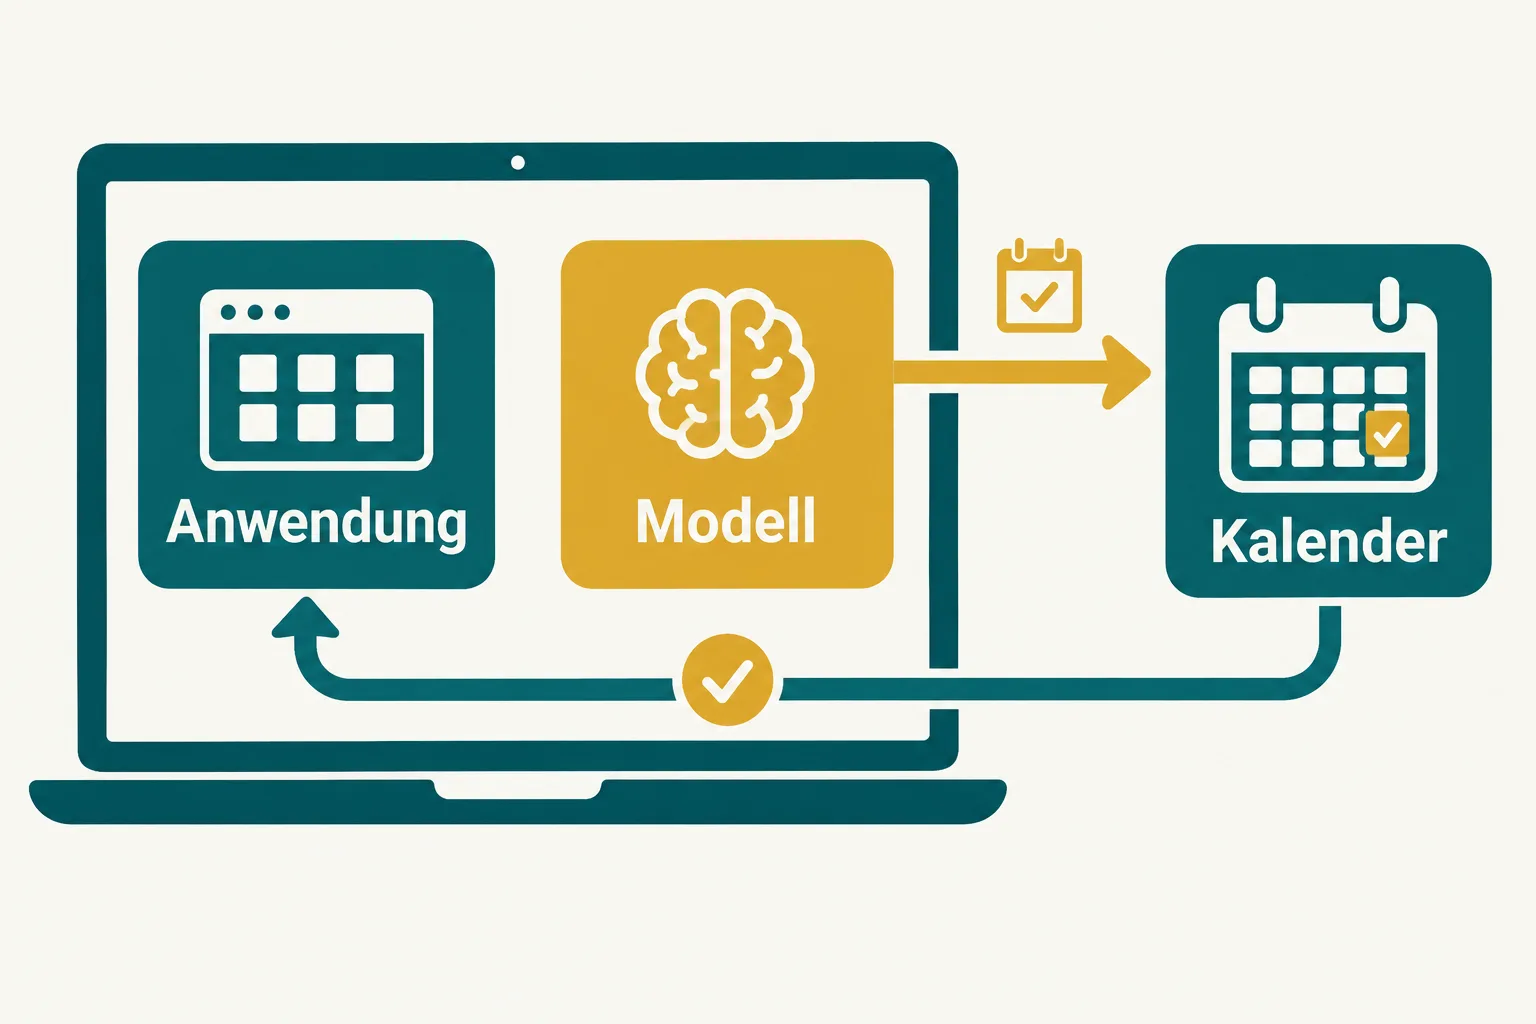
BotPsy ist für solche Aufgaben ein Forschungsbeispiel. Es baut auf einem Modell mit 0,8 Milliarden Parametern auf. Parameter sind gelernte Zahlenwerte; ihre Anzahl beschreibt einen Teil der Modellgröße, aber nicht allein die Qualität. Die Entwickler haben das Modell nach eigenen Angaben für Werkzeugauswahl und passende Aufrufe weitertrainiert. Es ist für einfache bis mittelschwere Aufgaben vorgesehen.
Ein korrekt geformter Aufruf ist allerdings erst ein Schritt. Fehlt im Wunsch eine Uhrzeit, muss die Anwendung nachfragen oder einen Fehler behandeln. Liefert ein Werkzeug eine falsche oder veraltete Information zurück, kann das Modell sie weiterverwenden. Die Qualität einer Antwort hängt also auch von Datenquelle und Fehlerbehandlung ab.
Warum eine Laufzeit gebraucht wird
Das Modell allein ist noch kein ausführbares Assistentenprogramm. Eine Laufzeit lädt seine Daten und organisiert die Berechnungen auf dem verfügbaren Prozessor oder einem anderen unterstützten Rechenbaustein. Sie bildet damit die Verbindung zwischen Modell und Hardware. Die Anwendung wiederum entscheidet, wie Menschen Fragen stellen und welche Werkzeuge sie freigibt.
llama.cpp ist eine solche Software für unterschiedliche Geräte. Das Projekt setzt unter anderem auf Quantisierung: Dabei werden Modellwerte mit geringerer Genauigkeit dargestellt, um Ressourcen zu sparen. Verschiedene technische Anpassungen, sogenannte Backends, ermöglichen die Ausführung auf unterschiedlicher Hardware. Welche Kombination funktioniert, hängt von Modell, Laufzeitversion und Gerät ab.
Mit Version 1.0 haben die Entwickler Regeln für Änderungen an öffentlichen Schnittstellen hervorgehoben. Diese Schnittstellen sind die vereinbarten Verbindungen, über die andere Programme die Bibliothek nutzen. Erkennbare Änderungen helfen App-Entwicklern bei Aktualisierungen. Für Nutzer bedeutet die Versionsnummer aber weder automatisch eine schnellere Antwort noch ein neues Modell. Die einzelne Anwendung muss die Software erst einbauen und passend konfigurieren.
Speicher sparen hat einen Preis
Ein großes Modell kann mehr Speicher benötigen, als ein Gerät zur Verfügung hat. Komprimierte Zahlenwerte helfen, ein Modell unterzubringen. Dabei stehen Speicherbedarf, Antwortqualität und Rechenaufwand in einem Verhältnis, das von der jeweiligen Methode und Hardware abhängt.
Eine Forschungsarbeit zu lokalen Sprachmodellen untersuchte Modelle verschiedener Größen und mehrere Quantisierungsmethoden auf handelsüblicher Hardware. In ihren Tests schnitten stärker komprimierte größere Modelle häufig besser ab als kleinere Modelle mit höherer Genauigkeit. Zugleich zeigten sich Grenzen bei sehr starker Kompression. Das ist ein Ergebnis der untersuchten Kombinationen und keine feste Regel für jedes Telefon und jede Aufgabe.
Auch ein kleines Modell ist nicht automatisch das beste Werkzeug. Bei einer einfachen, klaren Kalenderanfrage kann eine spezialisierte Anwendung ausreichen. Eine komplizierte Recherche mit mehreren Schritten stellt andere Anforderungen. BotPsy nennt gerade bei mehrstufiger Informationssuche Schwächen. Ein leistungsfähigeres entferntes Modell kann für manche Aufgaben sinnvoll sein; dann verlassen die dafür übermittelten Daten allerdings das Gerät.
Lokal heißt nicht automatisch privat
Das Modell kann auf dem Laptop laufen, während ein verbundenes Werkzeug einen Onlinekalender oder eine Websuche abfragt. Dann können Angaben aus der Anfrage über das Netz übertragen werden. Umgekehrt kann eine Anwendung mit lokalen Dateien arbeiten, ohne für jede Modellantwort einen entfernten Dienst zu benötigen. Entscheidend sind die konkreten Werkzeuge und ihre Einstellungen.
Mit Werkzeugen wachsen außerdem die Folgen eines Fehlers. Eine Anwendung, die nur einen Terminvorschlag anzeigt, hat andere Möglichkeiten als eine, die Nachrichten versenden oder Dateien verändern darf. Wer einen Assistenten einsetzt, sollte deshalb erkennen können, welche Dienste er nutzt und ob eine Aktion vor ihrer Ausführung bestätigt werden muss.
Das Sicherheitsprojekt OWASP beschreibt ein weiteres Problem: Fremde Inhalte wie Webseiten oder Dateien können Anweisungen enthalten, die das Modell zu einem unerwünschten Verhalten verleiten. Begrenzte Rechte, geprüfte Aufrufe und eine Freigabe für folgenreiche Aktionen können den möglichen Schaden reduzieren. Der Ort der Modellberechnung allein löst dieses Problem nicht.
Eine gute Demo ist noch kein zuverlässiger Alltag
Hersteller messen Werkzeugfähigkeiten oft mit Benchmarks, also vorgegebenen Testaufgaben. Tether berichtet für BotPsy bessere Ergebnisse als für sein Ausgangsmodell. Solche Werte helfen beim Vergleich unter den gewählten Bedingungen. Sie sagen nicht direkt, wie oft ein Assistent die eigenen Dokumente, Apps und Gewohnheiten richtig verarbeitet.
Hinzu kommt die Qualität der Tests selbst: Eine Prüfung von Epoch AI fand in einer Stichprobe des Werkzeug-Benchmarks BFCL v4 Aufgaben mit Bewertungsmängeln. Das betrifft den Test und nicht speziell BotPsy. Für den Alltag bleibt daher die konkrete Anwendung entscheidend: Kann sie fehlende Angaben erkennen, Fehler verständlich melden und eine geplante Aktion zeigen, bevor sie ausgeführt wird?
Lokale KI wird dann praktisch, wenn diese Teile zusammenpassen: Das Modell muss die Aufgabe bewältigen, die Laufzeit auf dem Gerät funktionieren und die Anwendung den Werkzeugzugriff begrenzen. Ein schneller Textgenerator allein kann das nicht garantieren. Erst die Verbindung aus brauchbarer Leistung und nachvollziehbarer Kontrolle macht aus ihm einen Assistenten.
Quellen
- ggml-org: llama.cpp v1.0.0, 13. November 2026
- Tether AI Research: BotPsy, 11. November 2026
- Song et al.: A Systematic Evaluation of On-Device LLMs, Fassung vom 16. März 2026
- OWASP: Prompt Injection
- Epoch AI: BFCL-v4-Benchmarkprüfung
Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft.