Ein KI-Modell lernt aus Beispielen. Doch welche Beispiele sollen seinen Lernprozess besonders stark prägen? Diese Frage lässt sich selbst zu einer Rechenaufgabe machen. Das Training erhält dann eine zweite Ebene: Während das Modell seine Parameter anpasst, verändert ein weiteres Verfahren die Gewichte seiner Trainingsdaten. So soll die spätere Leistung darüber mitentscheiden, welchen Einfluss ein Beispiel bekommt.
Der Gedanke ist leicht nachzuvollziehen, die Berechnung weniger. Schon eine kleine Änderung an der Gewichtung verändert das Training. Um ihre Wirkung zu beurteilen, muss man also berücksichtigen, wie das Modell darauf reagieren wird. Genau diese Verschachtelung macht den Ansatz interessant: Die Auswahl der Lernbedingungen wird Teil des Lernens.
Zwei Aufgaben, zwei Arten von Gewichten
Stellen wir uns als vereinfachtes Beispiel eine Bilderkennung vor. Sie erhält Fotos von Tassen und Tellern. Einige Beschriftungen sind falsch, manche Motive selten, andere tausendfach ähnlich vorhanden. Das Modell soll Muster erkennen, die ihm auch bei späteren Bildern helfen. Seine inneren Parameter bestimmen, wie es aus einem Bild eine Vorhersage bildet.
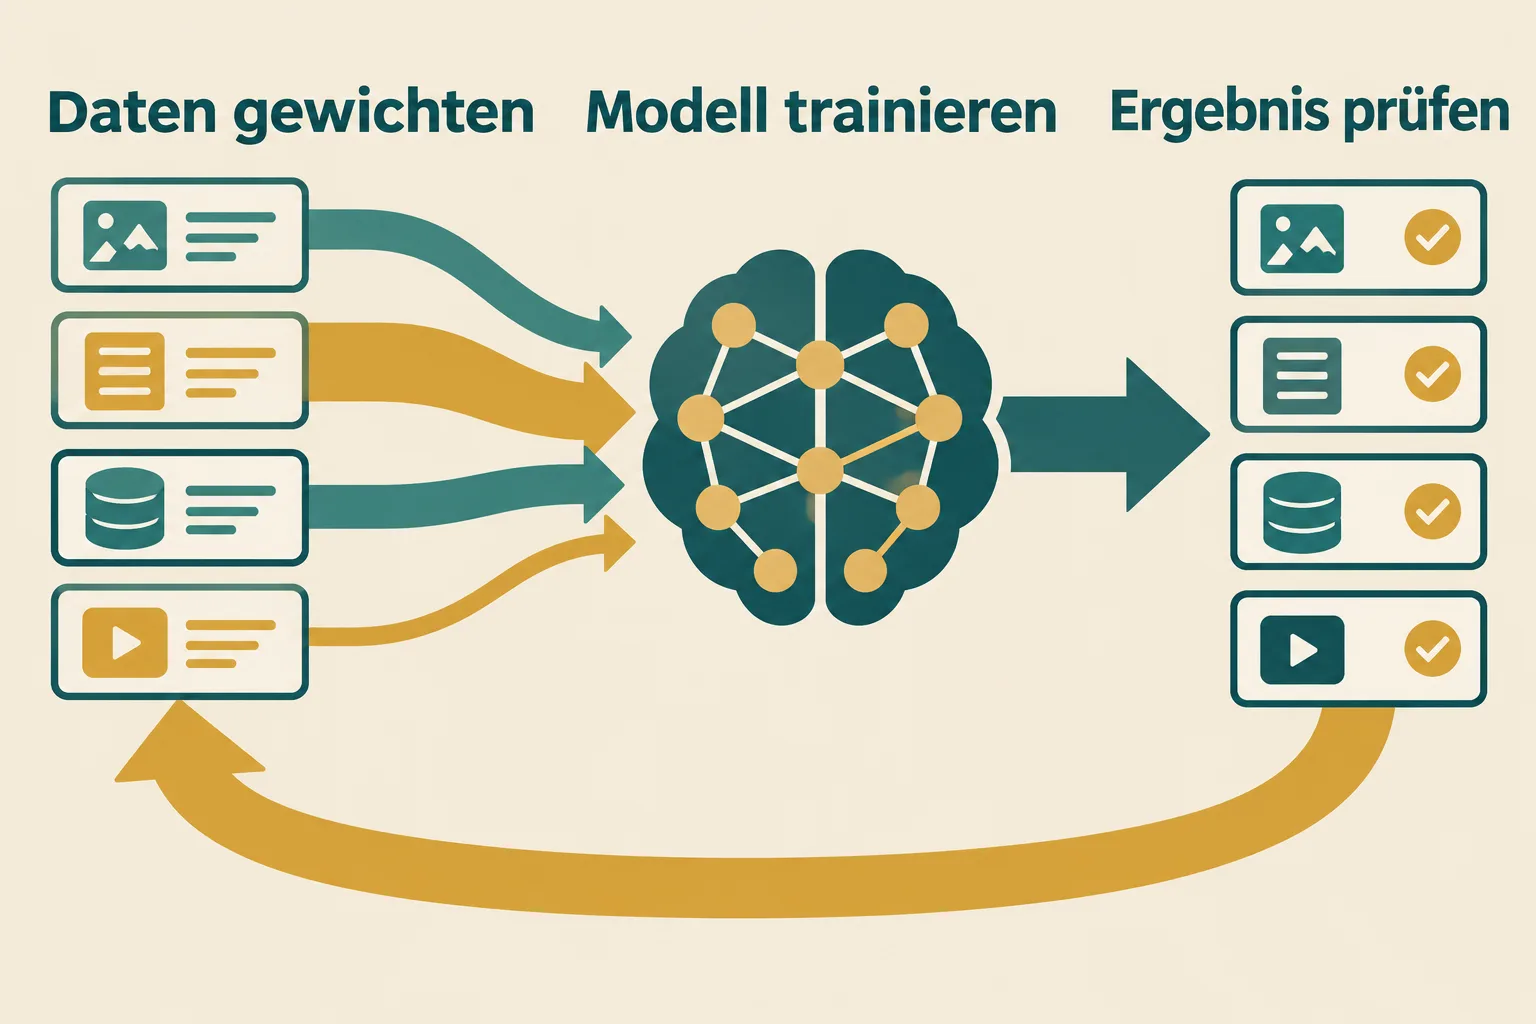
Davon zu unterscheiden sind die Gewichte der Trainingsbeispiele. Sie regeln, wie stark ein Fehler bei einem bestimmten Beispiel die Trainingsaufgabe beeinflusst. Ein Foto mit hohem Gewicht zählt bei dieser Aufgabe stärker als eines mit kleinem Gewicht. Die Daten müssen dafür nicht aus der Sammlung verschwinden. Ihr Einfluss auf das Lernen kann sich ändern, während sie weiterhin vorhanden sind.
Nun kommt eine zweite Sammlung ins Spiel: sorgfältig ausgewählte Beispiele, an denen die Entwickler prüfen, ob eine veränderte Gewichtung hilfreich war. Die innere Aufgabe lautet, ein Modell mit den gerade gewählten Datengewichten zu trainieren. Die äußere Aufgabe lautet, diese Gewichte anhand der Leistung auf den Prüfdaten anzupassen. Weil die äußere Entscheidung von der Lösung der inneren abhängt, spricht man von Bilevel- oder zweistufiger Optimierung.
Warum ein schwieriges Beispiel trotzdem wertvoll sein kann
Eine hohe Fehlerzahl verrät für sich genommen noch nicht, welche Daten man schwächer gewichten sollte. Im Gedankenexperiment könnte das Modell gerade mit dunklen Tassen Schwierigkeiten haben, weil diese im Training selten sind. Würde man alle schwierigen Fotos zurückstufen, würde es dieses Motiv noch seltener wirksam sehen. Ein falsch beschriftetes Foto kann ebenfalls einen hohen Fehler erzeugen, hat aber eine andere Ursache.
Eine getrennte Bewertung hilft, diese einfache Verwechslung zu vermeiden. Entscheidend wird die Frage, ob der Einfluss eines Beispiels bei der gewählten Zielaufgabe nützt. Das ist anspruchsvoller, als nur besonders leichte oder besonders schwere Beispiele zu sammeln. Zugleich hängt das Ergebnis davon ab, was die Prüfsammlung überhaupt abbildet.
Die Grundidee ist älter als die aktuelle Studie. Mengye Ren und Kollegen beschrieben 2018 ein Verfahren, das Trainingsbeispiele mithilfe einer kleinen sauberen Validierungsmenge gewichtet. Dabei nutzen sie die Richtung der Änderungen, die Beispiele beim Lernen anstoßen. Die aktuelle Forschung knüpft somit an eine bestehende Frage an: Wie lässt sich der Einfluss der Daten so bestimmen, dass das gelernte Modell bei einer getrennten Aufgabe besser abschneidet?
Wenn die innere Aufgabe mehrere gleich gute Antworten hat
Optimierung wird oft als Suche nach dem tiefsten Punkt einer Landschaft erklärt. Die Höhe steht dabei für einen Fehlerwert, der möglichst klein werden soll. Eine glatt geformte Schüssel hat einen klaren tiefsten Punkt. Eine Landschaft kann aber auch einen flachen Talboden besitzen: Mehrere Positionen erreichen dieselbe Höhe.
Ein eigenes mathematisches Miniaturbeispiel macht das greifbar. Zwei verstellbare Zahlen sollen zusammen den Wert zehn ergeben. Bewertet wird nur die Abweichung ihrer Summe von zehn. Dann erfüllen fünf und fünf die Aufgabe ebenso gut wie vier und sechs. Die innere Bewertung unterscheidet diese Lösungen nicht. Für eine zusätzliche äußere Aufgabe könnten sie jedoch unterschiedliche Folgen haben.
Damit wird die Frage nach der Reaktion schwieriger. Wer einen äußeren Regler bewegt, kann nicht mehr einfach von genau einer inneren Lösung ausgehen. Welche Lösung verfolgt das Rechenverfahren? Welche Richtungen verändern den inneren Fehler überhaupt? Die Mehrdeutigkeit ist eine Eigenschaft der beschriebenen Aufgabe, nicht bloß ein Problem ungenauer Rechner.
Was die Krümmung beim Rechnen verrät
Newton-Verfahren nutzen neben der lokalen Steigung auch die Krümmung der Zielfunktion. Im Landschaftsbild fragen sie damit zusätzlich, wie sich das Gefälle in verschiedenen Richtungen verändert. Das kann helfen, einen passenden nächsten Schritt zu bestimmen. Die mathematischen Grundlagen beschreibt etwa das Lehrbuch Convex Optimization von Boyd und Vandenberghe.
In einer flachen Richtung kann die Krümmungsinformation jedoch keine eindeutige Korrektur vorgeben. Die gewöhnliche Rechnung mit einer umkehrbaren Krümmungsmatrix passt dann nicht unmittelbar. Mehr Aufwand allein beseitigt diese strukturelle Frage nicht. Das Verfahren muss die vorhandenen Richtungen und die Bedingungen der Aufgabe gezielt berücksichtigen.
Der neue Preprint von Youran Dong und Kollegen vom 19. Oktober entwickelt dafür Newton-basierte Varianten von GALET und BAMM. Ihre Garantien gelten unter jeweils bestimmten Bedingungen: GALET benötigt unter anderem einen positiven Abstand der relevanten Krümmungswerte von null; BAMM nutzt Konvexität der inneren und starke Konvexität der äußeren Aufgabe bezüglich der inneren Variablen. Weitere Regularitätsannahmen gehören dazu. Die Autoren bündeln verwandte Ansätze außerdem im Rahmen GNBO.
Ein guter Prüfdatensatz bleibt eine bewusste Entscheidung
Auch ein besseres Optimierungsverfahren braucht eine sinnvolle Bewertung. Die Dokumentation von scikit-learn zur Kreuzvalidierung erläutert das Grundproblem: Wer ein Modell auf denselben Daten lernt und bewertet, kann eine Leistung messen, die bei unbekannten Daten nicht trägt. Ebenso kann wiederholtes Anpassen an einen Testdatensatz dessen Aussagekraft beschädigen.
Für unseren Tassenversuch bedeutet das: Die Sammlung, mit der die Datengewichtung gesteuert wird, dient bereits einer Lernentscheidung. Eine weitere, davon getrennte Prüfung muss zeigen, wie gut das Ergebnis außerhalb dieser Anpassung funktioniert. Enthält die steuernde Sammlung nur helle Tassen, wird auch die ausgefeilte Gewichtung nicht automatisch eine ausgewogene Aufgabe erhalten.
Im neuen Preprint stehen mathematische Beispiele, Datenbereinigung und ein GPT-2-Versuch nebeneinander. Beim Sprachmodell verwenden die Autoren gezielt beschädigte Antworten. Newton-basiertes GALET passt die Quellgewichte anfangs schneller an als die Vergleichsmethode; zusätzliche Berechnungen zweiter Ordnung erhöhen dabei den Spitzenspeicherbedarf. Das beschreibt einen konkreten Versuchsaufbau und dessen Aufwand.
Die weiterführende Einsicht liegt im Zusammenspiel: Ein Lernverfahren kann die Bedeutung seiner Beispiele verändern, doch es benötigt dafür ein Ziel außerhalb des bloßen Trainingsfehlers. Mathematik hilft, diese verschachtelte Entscheidung berechenbar zu machen. Welche Daten und welche Fähigkeiten wichtig sein sollen, bleibt eine Frage, die Entwickler in der Aufgabe und ihrer Bewertung festlegen müssen.
Quellen
- Dong, Yang, Yao und Zhang: Newton-Based Methods for Bilevel Optimization Beyond Lower-Level Strong Convexity (2026-10-19)
- Ren et al.: Learning to Reweight Examples for Robust Deep Learning (2018; Fassung2019-05-05)
- scikit-learn: Cross-validation: evaluating estimator performance
- Boyd und Vandenberghe: Convex Optimization, Kapitel9.5 (2004)
Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft.