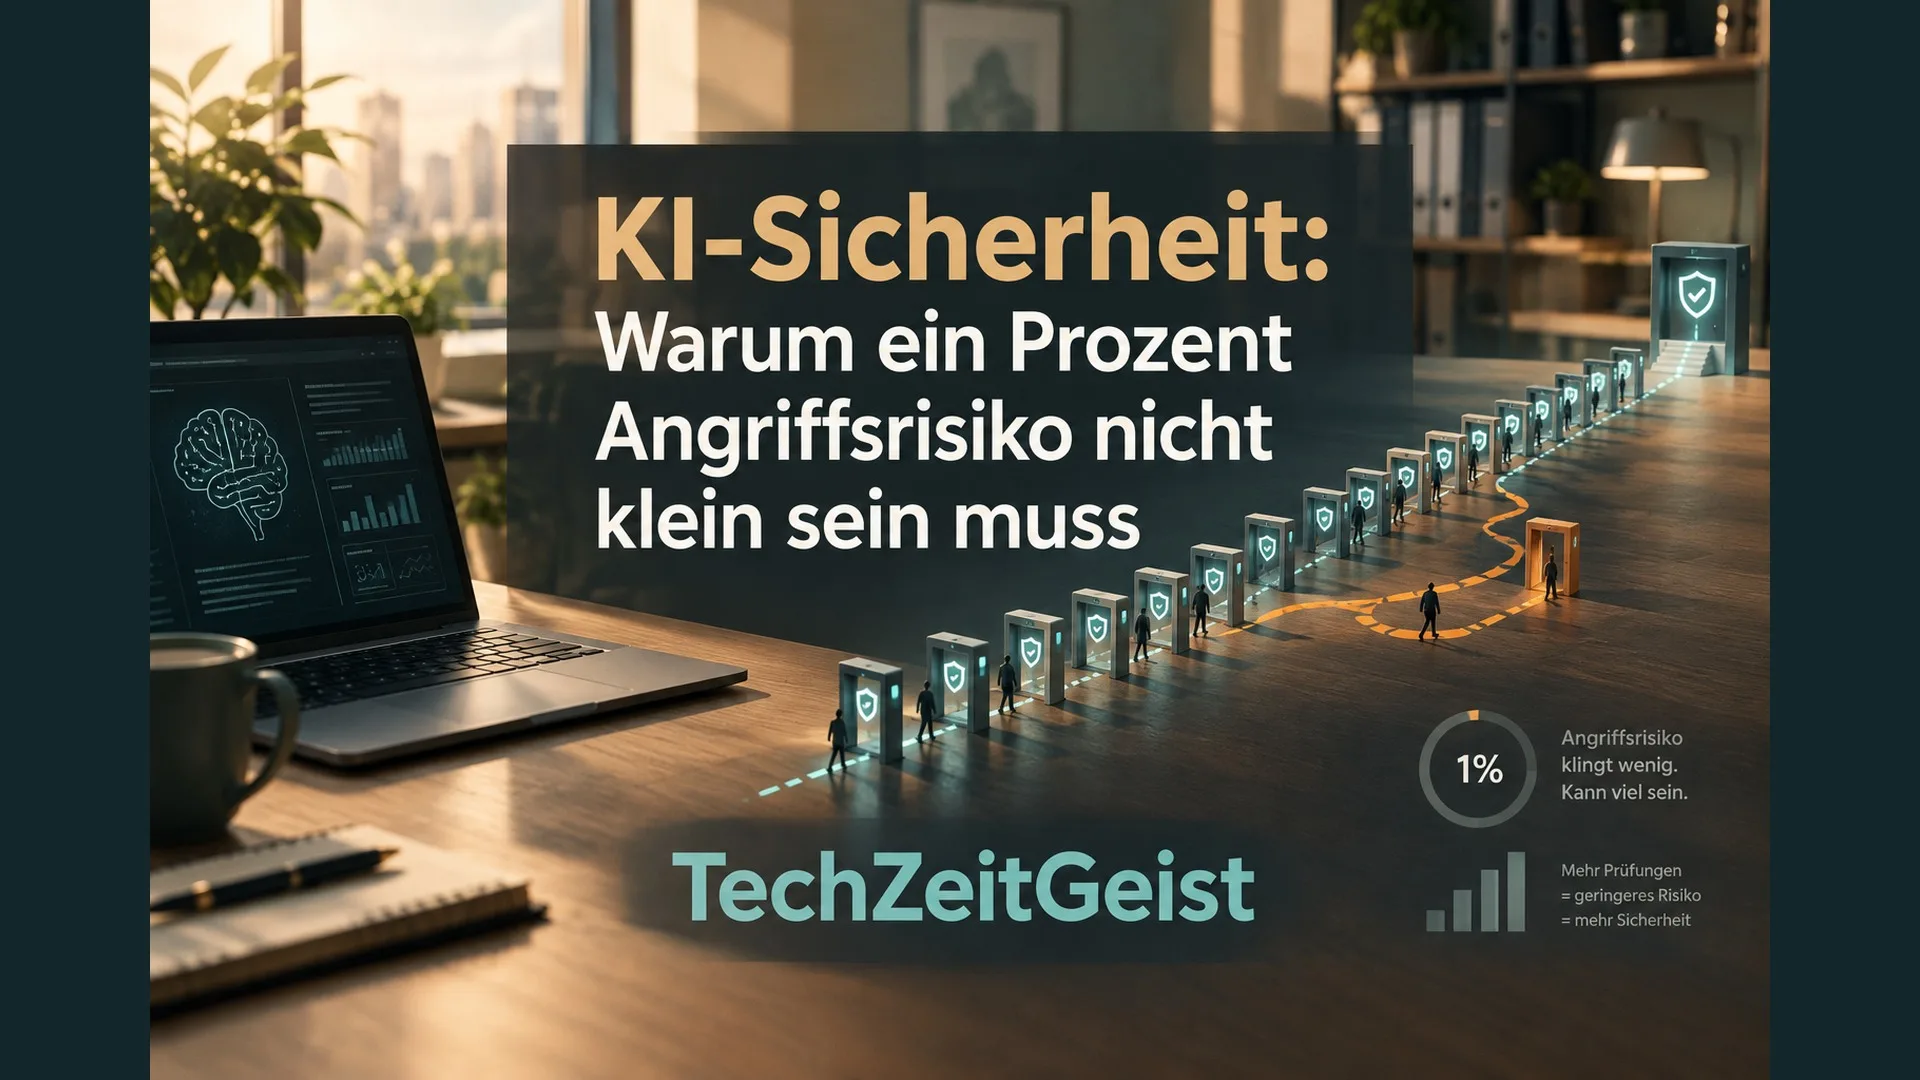
Ein Prozent erfolgreiche Angriffe klingt nach einem weitgehend beherrschten Problem. Für einen KI-Agenten, der viele fremde Inhalte liest und anschließend handeln darf, ist diese Zahl allein aber erstaunlich wenig aussagekräftig. Entscheidend ist, wie sie gemessen wurde: gegen welche Angreifer, mit wie vielen Versuchen, bei welchen Aufgaben und mit welchen möglichen Folgen. Die Entwicklung der Prompt-Injection-Forschung zeigt, weshalb diese Bedingungen inzwischen ins Zentrum der Sicherheitsbewertung rücken.
Die These lautet: Mit zunehmender Automatisierung wird die einzelne Abwehrquote zu einer unvollständigen Betriebskennzahl. Man muss zusätzlich verstehen, wie oft das System einer Angriffsgelegenheit begegnet und was nach einem Durchbruch passieren kann. Der Weg führt damit von der Frage, ob ein Modell einen verdächtigen Satz erkennt, zur Bewertung eines vollständigen Arbeitsablaufs.
Der Angreifer liest mit
Bei indirekter Prompt Injection steckt eine manipulative Anweisung in Material, das ein Agent im Rahmen einer legitimen Aufgabe liest: etwa in einer Webseite oder einem Dokument. Der Text soll dann mehr Einfluss erhalten, als ihm als Quelle zusteht. Je nachdem, welche Werkzeuge das System verwenden darf, kann daraus eine falsche Antwort oder eine unerwünschte Handlung werden.
Schon 2025 wurde deutlich, wie stark die Ergebnisse vom Angreifermodell abhängen. Eine Arbeit von Qiusi Zhan und Kollegen bei NAACL Findings untersuchte acht Abwehransätze mit adaptiven Angriffen. Die Forschenden berichten, alle acht in ihren Tests umgangen und jeweils Angriffserfolge von mehr als 50 Prozent erreicht zu haben. Adaptiv bedeutet hier: Der Angriff wird auf die untersuchte Abwehr eingestellt.
Das Ergebnis beschreibt diese untersuchten Ansätze unter den jeweiligen Testbedingungen. Es ist vor allem ein methodisches Signal: Eine feste Liste bekannter Angriffe kann ein System erheblich günstiger aussehen lassen als ein Gegner, der seine Versuche gezielt anpasst. Ein Schutzmechanismus muss sich daran messen lassen, was ein informierter Angreifer nach mehreren Rückmeldungen noch erreichen kann.
Eine bessere Abwehr verändert den Test nicht in eine Garantie
Am 24. November 2025 beschrieb Anthropic Fortschritte bei der Absicherung seiner Browsernutzung. Der Anbieter berichtete unter anderem von einer Angriffserfolgsrate von einem Prozent in einer internen adaptiven Auswertung. Dabei erhielt der Angreifer 100 Versuche pro Umgebung. Training, Klassifikatoren und weitere Schutzmaßnahmen gehörten zum betrachteten System.
Diese Zahl ist ein ernst zu nehmender Gegenbefund zu der Vorstellung, dass Verbesserungen grundsätzlich nichts bringen. Zugleich lässt sie sich nicht direkt mit den über 50 Prozent aus der anderen Arbeit verrechnen. Untersuchte Systeme, Verteidigungen, Aufgaben und Angriffsbudgets unterscheiden sich. Eine gemeinsame Rangliste aus solchen Einzelwerten würde mehr Vergleichbarkeit voraussetzen, als die Zahlen mitbringen.
Besonders wichtig ist der Nenner. Eine Erfolgsrate über ausgewählte angegriffene Umgebungen beschreibt etwas anderes als das Risiko pro gelesenem Dokument oder pro Arbeitstag. Die 100 Versuche innerhalb einer Evaluation sind ebenfalls etwas anderes als 100 voneinander unabhängige Vorgänge im Betrieb. Wer die Werte verwendet, muss diese Einheiten mitführen.
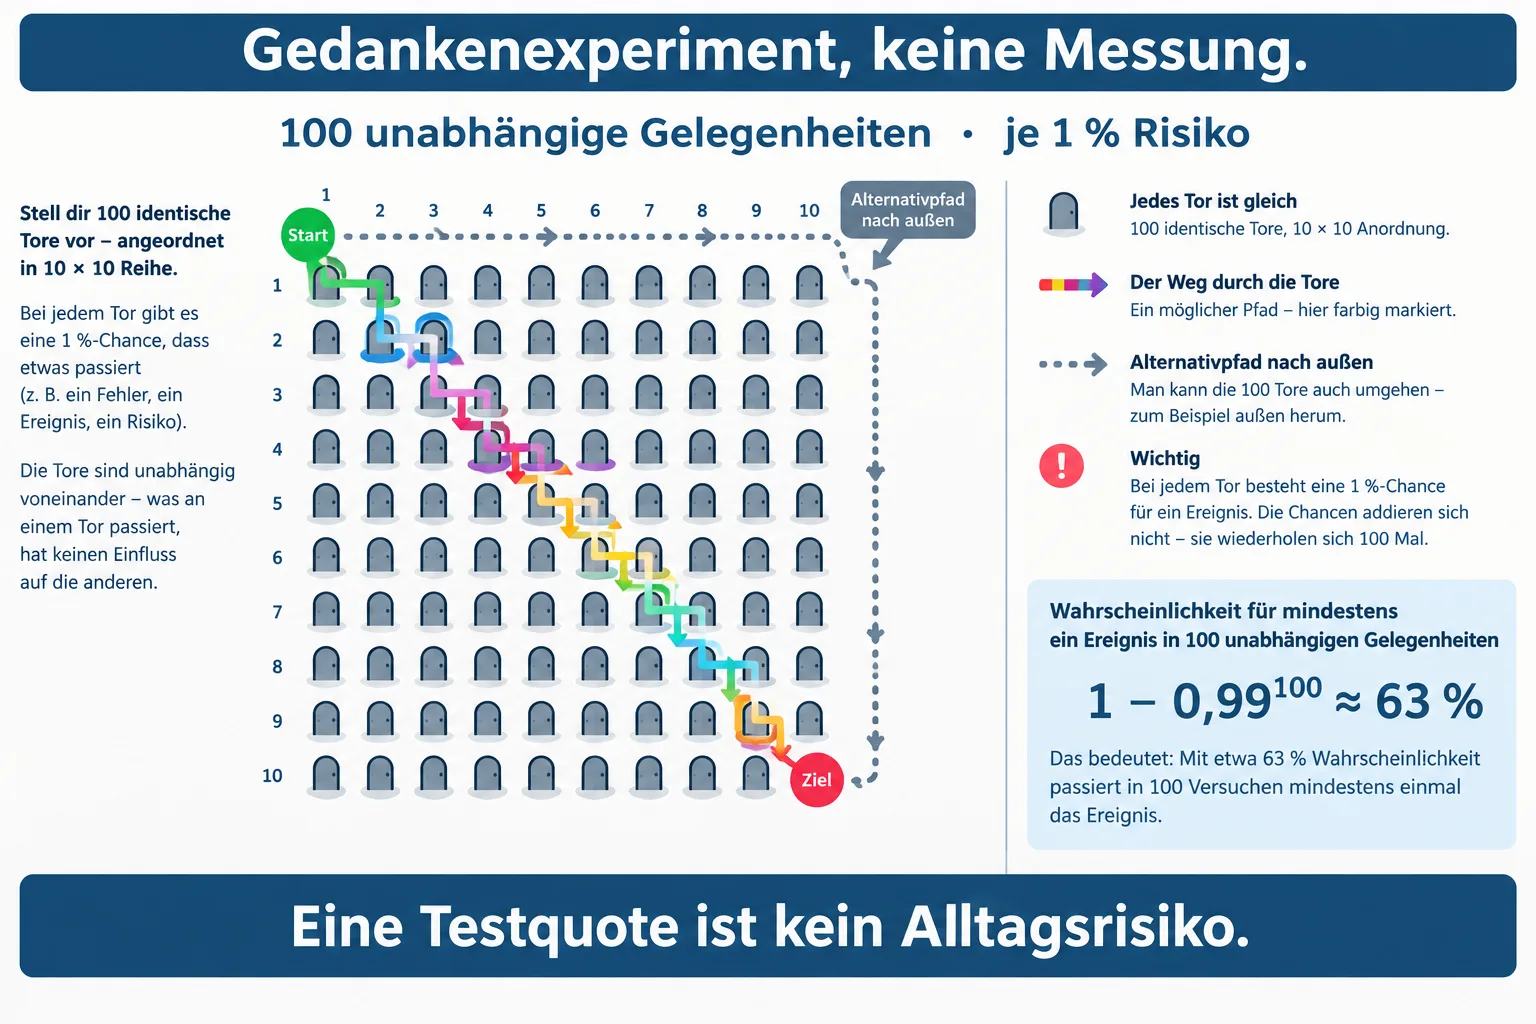
Was Wiederholung aus einem kleinen Risiko macht
Ein bewusst einfaches Gedankenexperiment zeigt, warum die Häufigkeit der Nutzung eine eigene Größe ist. Angenommen, bei jeder von 100 unabhängigen Gelegenheiten bestünde genau ein Prozent Risiko für ein unerwünschtes Ereignis. Dann beträgt die Wahrscheinlichkeit, dass alle 100 ohne dieses Ereignis bleiben, 0,99 hoch 100. Die Gegenwahrscheinlichkeit für mindestens ein Ereignis liegt bei rund 63,4 Prozent.
Das ist eine eigene mathematische Beispielrechnung. Die Unabhängigkeit und das gleichbleibende Risiko sind ihre Voraussetzungen. Ein realer Agent kann beides verletzen: Ähnliche Dokumente können dieselbe Schwachstelle treffen, Abwehrmechanismen können mehrere Versuche gemeinsam begrenzen und ein Angreifer kann aus vorigen Antworten lernen. Die Rechnung erklärt daher den Einfluss wiederholter Gelegenheiten, keine konkrete Gefahrenquote eines Produkts.
Im Betrieb kommt noch ein weiterer Unterschied hinzu: Nicht jede gelesene Seite enthält einen Angriff. Eine Laborquote unter absichtlich angegriffenen Aufgaben sagt nichts darüber, wie häufig solche Inhalte in einem bestimmten Arbeitsbereich vorkommen. Ein System, das nur einen eng begrenzten internen Bestand verarbeitet, begegnet einer anderen Quellenlandschaft als ein Agent, der offen im Netz recherchiert.
Auch ein Fehlalarm ist ein Betriebsergebnis
Wer nur die abgewehrten Angriffe zählt, übersieht die normale Arbeit. Ein Filter kann sehr vorsichtig sein und dadurch viele harmlose Inhalte blockieren. Dann sieht die Abwehrleistung gut aus, während Nutzer ständig eingreifen oder Aufgaben erneut starten müssen. Die Sicherheitsbewertung braucht deshalb auch die Zahl erfolgreich erledigter erlaubter Aufgaben und die Fehlalarme.
Ein zweites fiktives Zahlenbeispiel macht den Effekt sichtbar: Von 10.000 harmlosen Inhalten würden bei einem Prozent Fehlalarmrate 100 markiert. Kämen 50 schädliche Inhalte dazu und würden 90 Prozent davon erkannt, wären weitere 45 Markierungen richtig. Von insgesamt 145 Alarmen beträfen dann nur 45 tatsächlich einen Angriff, also etwa 31 Prozent. Alle Zahlen sind frei gewählte Rechengrößen.
Ein hoher Erkennungswert kann somit mit einer erheblichen Prüfaufgabe einhergehen. Umgekehrt darf eine geringe Zahl von Warnungen nicht automatisch als gute Sicherheit gelten. Sinnvoll wird der Vergleich erst, wenn Angriffserkennung, Fehlalarme und erledigte Aufgaben auf derselben Datenbasis betrachtet werden.
Schon die Größe einer Auswertung setzt dem Schluss Grenzen. Wenn ein Test unter hundert Versuchen keinen Durchbruch findet, sind zunächst hundert bestimmte Versuche ohne beobachteten Durchbruch dokumentiert. Daraus folgt keine Wahrscheinlichkeit von exakt null für jede künftige Aufgabe. Andere Quellen, längere Abläufe und gezieltere Angriffe können neue Bedingungen schaffen.
Für einen fairen Vergleich sollten zwei Systeme deshalb möglichst dieselben erlaubten Aufgaben und dieselben Angriffsgelegenheiten erhalten. Auch das Budget des Gegners gehört dazu. Zehn gezielt optimierte Versuche lassen sich nicht wie zehn zufällige verdächtige Sätze behandeln. Ebenso sollte eine blockierte Aufgabe nicht stillschweigend als erfolgreich abgeschlossene sichere Arbeit zählen.
Eine nachvollziehbare Auswertung hält diese Ergebnisse getrennt fest und zeigt anschließend, welche Kombination im konkreten Einsatz passt. Für einen reinen Lesehelfer kann ein unterbrochener Auftrag leichter hinnehmbar sein als für einen zeitkritischen Arbeitsprozess. Das verändert die Bewertung eines Fehlalarms, ohne aus ihm einen erfolgreichen Angriff zu machen. Gerade diese Trennung macht Zahlen vergleichbar und Entscheidungen überprüfbar.
Der Schaden braucht eine eigene Grenze
Microsoft beschrieb am 29. Juli 2025 eine mehrschichtige Abwehr, die neben Erkennung auch die Begrenzung möglicher Folgen umfasst. Dazu gehören Datenzugriffe, Einwilligungsabläufe und technische Sperren für bekannte Wege des Datenabflusses. Die OWASP-Empfehlungen verbinden ähnliche Ebenen: Prüfung von Inhalten, Kontrolle der Werkzeugaufrufe und möglichst kleine Zugriffsrechte.
Für die Bewertung eines Arbeitsablaufs ist der Unterschied greifbar. Ein Recherchehelfer, der einen Entwurf in einem isolierten Ordner ablegt, hat bei derselben Fehlinterpretation andere mögliche Folgen als ein System, das vertrauliche Dokumente versenden oder Datensätze löschen kann. Die Abwehrquote des Modells allein bildet diesen Handlungsspielraum nicht ab.
Ein brauchbarer Betriebsnachweis verbindet daher mehrere Fragen: Welche erlaubte Arbeit gelingt? Welche Angriffe wurden mit welchem Budget versucht? Wie häufig gibt es Fehlalarme? Welche Handlungen sind nach einem Durchbruch technisch noch erreichbar? Dazu muss die Software nicht fehlerfrei sein. Ihre Grenzen müssen aber so konkret sein, dass sich die Folgen eines Fehlers einschätzen lassen.
Der Fortschritt seit den frühen Prompt-Injection-Tests liegt auch darin, dass diese Fragen gemeinsam betrachtet werden. Adaptive Angriffe prüfen die Widerstandsfähigkeit, bessere Modelle und Filter können sie erhöhen, und begrenzte Werkzeuge verkleinern den möglichen Schaden. Erst diese Kombination macht aus einer beeindruckenden Testzahl eine belastbare Grundlage für Automatisierung.
Quellen
- Zhan et al.;ACL: Adaptive Attacks Break Defenses Against Indirect Prompt Injection Attacks on LLM Agents (2025-04).
- Microsoft;Andrew Paverd: How Microsoft defends against indirect prompt injection attacks (2025-07-29).
- Anthropic: Mitigating the risk of prompt injections in browser use (2025-11-24).
- OWASP: LLM Prompt Injection Prevention Cheat Sheet (Abruf 19.10.2026).
Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft.