Eine teure KI kann ihr Geld wert sein und trotzdem zu früh eingesetzt werden. Wer zunächst nur die grobe Richtung einer Lösung sucht, braucht möglicherweise weniger Präzision als kurz vor dem Ziel. Damit verändert sich während derselben Arbeit, welche Informationsquelle wirtschaftlich ist. Der günstigste Weg kann mit einem einfachen Verfahren beginnen und mit einem genaueren enden.
Das lässt sich an einer vertrauten Tätigkeit verstehen: Für den Zuschnitt eines Brettes genügt zunächst ein grobes Maß. Beim Einpassen eines Bauteils werden kleinere Abweichungen entscheidend. Niemand gewinnt etwas, wenn er den ersten Blick auf die Werkbank bereits mit dem teuersten Messinstrument bezahlt. Umgekehrt hilft ein preiswerter Zollstock wenig, wenn die verbleibende Lücke schmaler ist als seine Ablesegenauigkeit.
Die Rechnung verändert sich unterwegs
Swati Gupta und Tianjiao Li untersuchen diesen Gedanken in einem Preprint vom 15. Oktober 2026 für Optimierung mit unterschiedlich teuren Informationsquellen. Sie berücksichtigen systematische Fehler, zufällige Streuung und die angestrebte Genauigkeit. Ihre Theorie gilt für glatte, stark konvexe Zielfunktionen: vereinfacht eine Landschaft mit eindeutigem Tiefpunkt. Bei unbekannten Fehlern prüfen vertrauenswürdige Kontrollschritte den Fortschritt.
Ein Experiment mit KI-ergänzten Daten zeigt bei zehn Prozent fehlenden Einträgen rund 72 statt 240 US-Dollar äquivalente Informationskosten. Die etwa 70 Prozent Ersparnis beruhen auf einer Vergleichsrechnung, die vorab angefallene Ergänzungskosten auf Beobachtungen verteilt. Bei 20 Prozent fehlenden Daten bleibt die adaptive Methode dagegen bei günstigen Quellen. Zusätzliche Präzision lohnt sich somit innerhalb der Versuche unterschiedlich. Eine solche Rechnung verändert sich, sobald einmal erworbene Daten kostenlos wiederverwendet werden können.
Streuung und Schieflage sind verschiedene Probleme
Für das Verständnis hilft ein eigenes Gedankenexperiment mit einer Zielscheibe. Eine Informationsquelle liefert Richtungsangaben, mit denen wir uns dem Zentrum nähern. Sind die Angaben etwas unruhig, landen einzelne Schritte links und rechts der eigentlich richtigen Richtung. Mehrere unabhängige Beobachtungen können ein klareres Bild ergeben. Der einzelne Hinweis darf ungenau sein, solange die nächste Bewegung zuverlässig genug wird.
Anders sieht es aus, wenn das Messinstrument dauerhaft nach rechts zeigt. Dann kann jede weitere Messung dieselbe Schieflage bestätigen. Eine große Menge von Hinweisen erzeugt ein sehr überzeugendes falsches Zentrum. Diesen Unterschied zwischen zufälliger Streuung und systematischer Verschiebung bezeichnet die Statistik als Varianz und Bias. Für eine grobe Annäherung können beide zunächst erträglich sein. Beim Treffen eines kleinen Zielbereichs fallen dieselben Abweichungen stärker ins Gewicht.
Übertragen auf eine Datentabelle: Werden Werte nur etwas unruhig geschätzt, kann eine große Datenmenge diese Unruhe teilweise ausgleichen. Werden bestimmte Fälle konsequent in dieselbe Richtung falsch ergänzt, verschiebt sich die Grundlage der weiteren Rechnung. Eine präzise berechnete Lösung kann dann zur verzerrten Tabelle passen. Die Genauigkeit der Rechnung und die Verlässlichkeit ihrer Eingaben sind zwei verschiedene Eigenschaften.
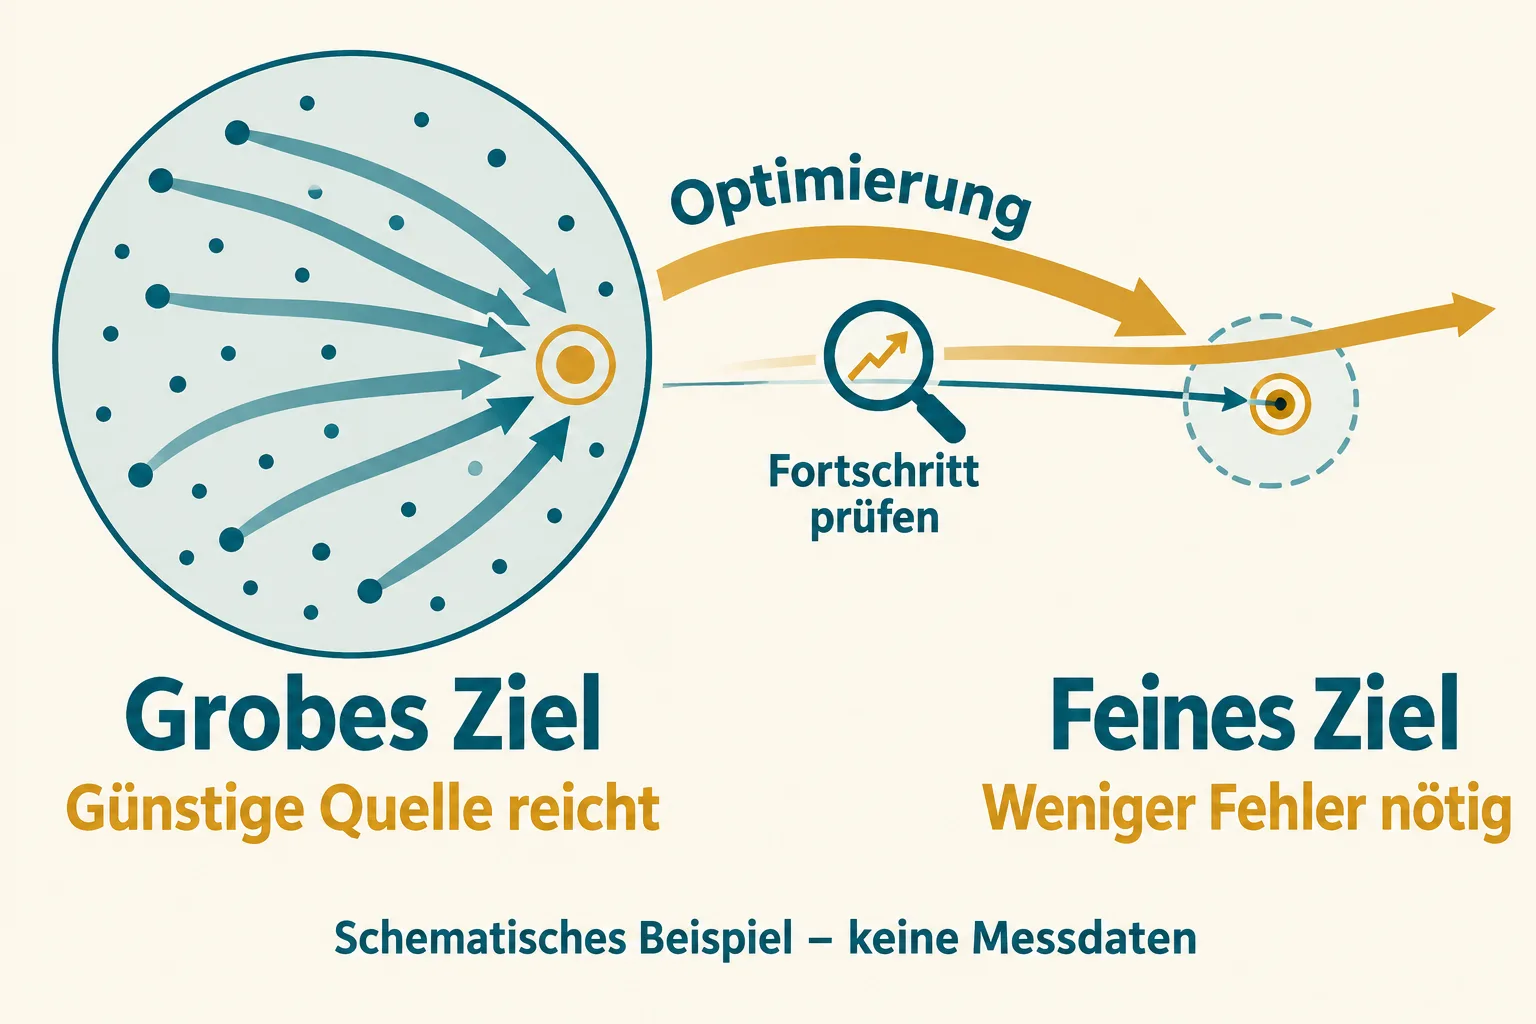
Ein Modellwechsel lässt sich ohne Produktnamen durchrechnen
Nehmen wir ein ausdrücklich erfundenes Beispiel mit drei Arbeitsstufen. Jede Stufe soll denselben vorher festgelegten Fortschritt erreichen, unabhängig vom gewählten Verfahren. Quelle A ist beim groben Schritt günstig, wird bei feineren Zielen aber aufwendig. Quelle B kostet pro Stufe mehr als A am Anfang, benötigt dafür später weniger Wiederholungen. Alle Beträge sind fiktive Recheneinheiten und keine Preise realer KI-Modelle.
| Quelle | Grobes Ziel | Mittleres Ziel | Feines Ziel |
|---|---|---|---|
| A | 1 | 3 | 12 |
| B | 4 | 4 | 4 |
Wer immer A verwendet, bezahlt insgesamt 16 Einheiten. Wer von Beginn an B nimmt, kommt auf zwölf. Die Kombination A, A, B benötigt acht. Unsere eigene Addition zeigt, warum die Antwort auf die Frage nach der günstigsten Quelle während der Arbeit wechseln kann. B ist für das feine Ziel preiswert und für das grobe Ziel unnötig teuer. Sein Preis bleibt gleich; sein Nutzen verändert sich.
Die Kombination funktioniert hier, weil wir annehmen, dass alle Stufen vergleichbare, nutzbare Zwischenstände liefern. Muss beim Wechsel die gesamte Vorarbeit wiederholt werden, fällt die Rechnung anders aus. Dasselbe gilt, wenn A die nächste Stufe grundsätzlich nicht zuverlässig erreichen kann. Ein niedriger Preis pro Versuch macht ein unerreichbares Ziel nicht günstiger.
Wer den Fortschritt prüft, gehört in die Rechnung
Ergänzen wir unser Beispiel um drei Kontrollpunkte. Kostet jeder eine Einheit, steigt der Aufwand des gemischten Weges von acht auf elf. Er bleibt unter den zwölf Einheiten des durchgehend genaueren Verfahrens. Verdoppeln sich die zusätzlichen Kontrollkosten auf insgesamt sechs, kostet die Mischung 14. Der Vorteil verschwindet. Diese vereinfachte Rechnung nimmt an, dass B ohne diese zusätzlichen Zwischenkontrollen auskommt; gemeinsame Abschlussprüfungen würden beide Wege gleichermaßen belasten.
Kontrollen haben dabei zwei Aufgaben: Sie stellen fest, ob wir näher am Ziel sind, und können einen falschen Weg früh beenden. Eine Prüfung nach jedem winzigen Schritt kann den Ablauf verteuern. Eine einzige Prüfung ganz am Ende lässt dagegen viel Zeit für Arbeit in die falsche Richtung. Der passende Abstand hängt davon ab, wie teuer die Kontrolle ist und wie viel Aufwand zwischen zwei Kontrollen verloren gehen könnte.
Auch der Prüfer braucht eine belastbare Grundlage. Zwei Systeme, die dieselbe falsche Annahme teilen, können einander zustimmen. Im Zielscheibenbild wäre das ein zweites Messgerät, dessen Nullpunkt mit dem ersten falsch eingestellt wurde. Für eine nützliche Kontrolle ist daher entscheidend, woher der Maßstab kommt. Ein weiterer Modellaufruf ist zunächst eine zusätzliche Auskunft.
Routing beantwortet eine andere Frage
Die ältere Arbeit RouteLLM von Isaac Ong und Kollegen wählt zwischen einem stärkeren und einem schwächeren Sprachmodell anhand der jeweiligen Anfrage. Der Router wird mit Präferenzdaten trainiert. Er soll abschätzen, wann die stärkere Variante einen ausreichend großen Vorteil bringt. Im Mittelpunkt steht damit die Verteilung unterschiedlicher Anfragen.
FrugalGPT von Lingjiao Chen, Matei Zaharia und James Zou untersucht dagegen unter anderem Modellkaskaden: Kombinationen von Modellen werden für verschiedene Anfragen genutzt. Beide Ansätze helfen, Modellwahl als eigenständige Entscheidung zu verstehen. Der hier betrachtete zeitliche Mechanismus fragt zusätzlich, wie sich der Wert einer Quelle innerhalb eines Optimierungsvorgangs verändert.
Für die Praxis folgt daraus eine präzisere Frage als die Suche nach einem dauerhaft günstigsten Modell: Welche Abweichung verträgt der nächste Schritt, und lässt sich sein Fortschritt zu vertretbaren Kosten prüfen? Manchmal rechtfertigt die Antwort einen Wechsel. Manchmal reicht die günstige Quelle bis zum Ende. Präzision wird dann wertvoll, wenn sie eine konkrete verbleibende Schwierigkeit löst.
Quellen
- Swati Gupta und Tianjiao Li: When is a better LLM worth paying for? Stochastic Optimization with Switching Mixed-Fidelity Oracles, Preprint, 15. Oktober 2026.
- Isaac Ong et al.: RouteLLM: Learning to Route LLMs with Preference Data, Fassung vom 23. Februar 2025, erstmals eingereicht am 26. Juni 2024.
- Lingjiao Chen, Matei Zaharia und James Zou: FrugalGPT: How to Use Large Language Models While Reducing Cost and Improving Performance, 9. Mai 2023.
Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft.