Ein KI-Agent erledigt eine Forschungsaufgabe in wenigen Stunden. Heißt das, dass ein ganzes Forschungsteam nun entsprechend schneller arbeitet? Die verfügbaren Messungen geben diese Rechnung nicht her. Sie zeigen, dass KI bei manchen Aufgaben weit kommt und bei anderen deutlich weniger. Ob daraus schnellerer Erkenntnisgewinn wird, hängt auch davon ab, was Menschen prüfen, verbinden und anschließend tun müssen.
Neue interne Daten von OpenAI und unabhängige Experimente der Forschungsorganisation METR beleuchten verschiedene Teile dieser Frage. Zusammen ergeben sie kein allgemeines Tempo für die Forschung. Sie zeigen vielmehr, warum die Art der Aufgabe und die Art der Messung den Ausschlag geben.
Was die Erfolgsquote tatsächlich misst
OpenAI berichtet, dass seine Agenten im Oktober 2026 geschätzt 46 Prozent der untersuchten Forschungsaufgaben selbstständig lösten, für die Menschen zwei bis vier Stunden benötigen würden. Im März lag der entsprechende Wert bei 23 Prozent. Bei Aufgaben mit vier bis acht Stunden geschätzter menschlicher Arbeitszeit stieg die Quote von 13 auf 35 Prozent.
Das sind Erfolgsquoten für ausgewählte Aufgaben. Sie besagen, wie häufig ein Agent eine Aufgabe nach dem jeweiligen Prüfmaßstab bewältigte. Sie sagen nicht unmittelbar, um wie viel schneller ein Team ein ganzes Forschungsvorhaben abschließt. Dafür müsste man unter anderem wissen, wie die ausgewählten Aufgaben in den gesamten Arbeitsablauf passen und wie viel menschliche Arbeit vor und nach ihnen anfällt.
OpenAI misst die eigenen Forschungsabläufe und beschreibt das Bild selbst als unvollständig. Die Daten sind dennoch aufschlussreich: Sie zeigen, dass ein Durchschnitt sehr verschiedene Tätigkeiten zusammenfasst. In der internen Aufschlüsselung gelang die Überwachung von Trainingsläufen in 79 Prozent der Fälle, das Starten solcher Läufe in 35 Prozent und das Schreiben von Code für Inferenz und Bereitstellung in 25 Prozent. Inferenz bezeichnet hier die Ausführung eines bereits trainierten Modells.
Von der Aufgabe zum Ergebnis
Ein Forschungsprojekt besteht aus mehr als einer Folge austauschbarer Aufgaben. Jemand muss eine Frage formulieren, die Ergebnisse einzelner Schritte einordnen und entscheiden, welcher Versuch als Nächstes sinnvoll ist. Auch ein brauchbarer Codevorschlag muss in den Zusammenhang passen, in dem er später verwendet wird.
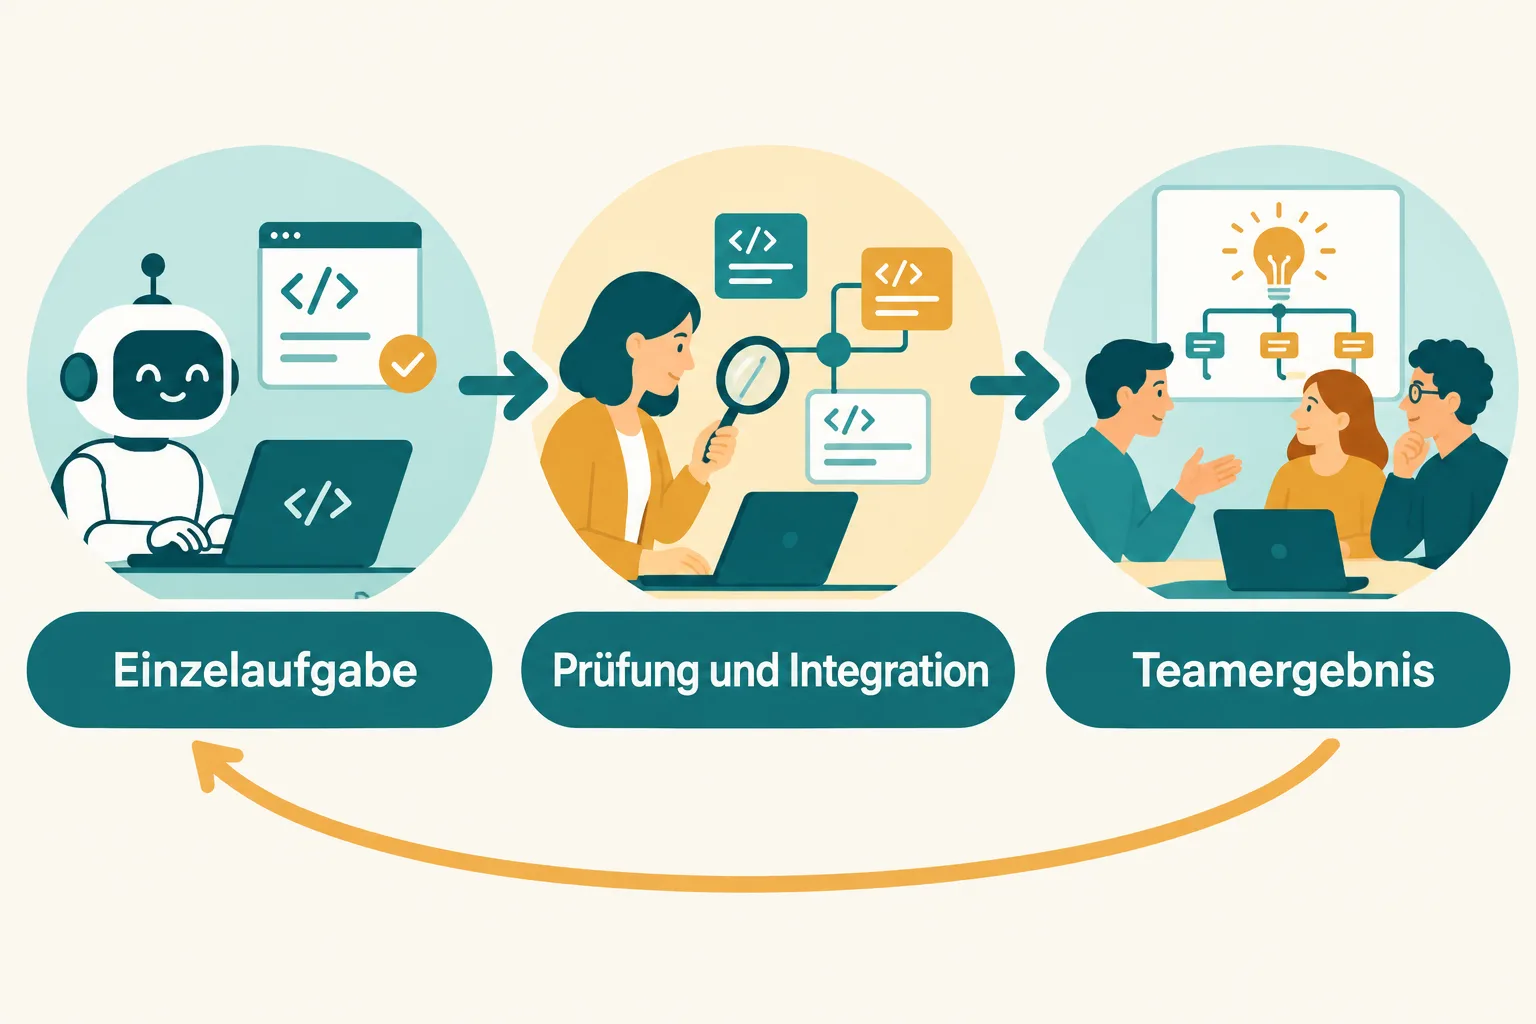
Ein Gedankenbeispiel macht den Unterschied sichtbar: Angenommen, ein Agent erstellt schnell eine Auswertung für einen Versuch. Eine Forscherin muss dennoch prüfen, ob die Daten zur Frage passen und die Auswertung richtig interpretiert wird. Vielleicht führt das Ergebnis zu einer neuen Frage, vielleicht muss der Versuch wiederholt werden. Die gesparte Zeit bei der Auswertung kann nützlich sein; die Erfolgsquote dieser einen Aufgabe verrät aber nicht, wann das gesamte Projekt eine belastbare Antwort erreicht.
Mehrere Agenten gleichzeitig einzusetzen kann außerdem die Verteilung der Arbeit verändern. Menschen können Ergebnisse vergleichen und neue Aufträge vergeben, während andere Schritte laufen. Gleichzeitig entstehen Entscheidungen darüber, was überprüft und zusammengeführt werden muss. Welche Seite überwiegt, lässt sich aus der Zahl paralleler Agenten allein nicht ablesen.
Ein unabhängiger Gegenbefund aus der Softwareentwicklung
Wie stark das Ergebnis vom Arbeitsplatz und den verwendeten Werkzeugen abhängt, zeigt ein randomisiertes Experiment von METR. Die Organisation untersuchte Anfang 2025 16 erfahrene Entwickler, die an ihren eigenen größeren Open-Source-Projekten arbeiteten. Insgesamt meldeten sie 246 reale Aufgaben an. Für jede Aufgabe wurde zufällig festgelegt, ob KI-Werkzeuge erlaubt waren.
In diesem Versuch brauchten die Entwickler mit erlaubter KI im Durchschnitt 19 Prozent länger als ohne sie. Vorab hatten sie eine Beschleunigung erwartet; auch nach dem Versuch schätzten sie ihre eigene Arbeit mit KI als schneller ein. METR untersuchte damit tatsächliche Bearbeitungszeiten in einem bestimmten Entwicklungsumfeld, nicht den Durchsatz ganzer Forschungsteams.
Das Ergebnis ist keine allgemeine Aussage darüber, dass KI Entwickler oder Forschende ausbremst. Die Teilnehmer kannten ihre Projekte bereits gut, die Aufgaben und Werkzeuge stammten aus dem Untersuchungszeitraum. Andere Menschen, Aufgaben und neuere Systeme können zu anderen Ergebnissen führen. Umgekehrt ist eine hohe Erfolgsquote eines autonomen Agenten kein direkter Gegenbeweis: Die Messungen betrachten unterschiedliche Arbeit unter unterschiedlichen Bedingungen.
Warum neue Messungen schwierig bleiben
METR versuchte später, den Versuch mit mehr Entwicklern und neueren Werkzeugen fortzuführen. In einem Bericht vom Februar 2026 erklärt die Organisation, warum sie ihre neuen Daten für ein unzuverlässiges Maß des aktuellen Produktivitätseffekts hält.
Ein Teil der Entwickler wollte nicht teilnehmen, wenn er zeitweise ohne KI arbeiten müsste. Andere reichten bestimmte Aufgaben nicht ein, weil sie diese nicht ohne KI erledigen wollten. Gerade Aufgaben und Personen mit möglicherweise hohem Nutzen können deshalb in der Stichprobe fehlen. Zugleich wurde die Vergütung gegenüber der ersten Studie gesenkt, was die Auswahl ebenfalls beeinflusst haben kann.
METR hält es aufgrund von Gesprächen für wahrscheinlich, dass Entwickler Anfang 2026 stärker von KI beschleunigt wurden als im früheren Versuch. Wie groß dieser Unterschied ist, lässt sich aus den verzerrten Daten aber nur sehr schwach ableiten. Die Richtung einer plausiblen Entwicklung und ihre genaue Größe sind hier zwei verschiedene Aussagen.
Hinzu kommt ein praktisches Messproblem: Wenn ein Entwickler mehrere Agenten parallel arbeiten lässt und selbst an einer anderen Aufgabe sitzt, ist die auf eine einzelne Aufgabe entfallende Zeit schwerer zu erfassen. Auch die Qualität oder der Umfang von Tests und Dokumentation können sich zwischen Arbeitsweisen unterscheiden. Eine reine Stoppuhr beantwortet dann nicht jede Frage nach dem Wert des Ergebnisses.
Welche Messung für welche Frage?
Wer wissen will, ob ein Agent eine bestimmte Aufgabe allein lösen kann, braucht klar beschriebene Aufgaben und nachvollziehbare Erfolgskriterien. Wer den Nutzen für einen Menschen messen will, muss auch dessen Zusammenarbeit mit dem Werkzeug betrachten. Für ein Team interessiert schließlich, welche Ergebnisse in welcher Qualität entstehen und welche anderen Ressourcen dabei eingesetzt werden.
Diese Ebenen ergänzen sich. Eine Aufgabenquote kann zeigen, wo ein System Fortschritte macht. Ein kontrollierter Versuch kann unter seinen Bedingungen den Unterschied zwischen Arbeit mit und ohne Werkzeug messen. Beobachtungen aus Teams zeigen, wie sich Arbeitsweisen verändern. Keine dieser Größen lässt sich ohne weitere Annahmen in die anderen umrechnen.
Die stärkste Schlussfolgerung lautet deshalb nicht, dass KI Forschung schneller oder langsamer macht. Sie lautet: Der Weg von einer verbesserten Einzelaufgabe zu mehr Forschungsergebnissen führt über Menschen, andere Arbeitsschritte und Entscheidungen. Wer den Gesamteffekt verstehen will, muss diesen Weg mitmessen.
Quellen
- OpenAI: Research acceleration: The jagged frontier, 18. November 2026.
- METR: Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity, 10. Juli 2025.
- METR: We are Changing our Developer Productivity Experiment Design, 24. Februar 2026.
Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft.