Eine KI soll vorhersagen, welche Farbe ein neuer Farbstoff aufnimmt oder aussendet. Im Test liefert sie beeindruckende Werte. Doch vielleicht kennt sie das getestete Molekül bereits – nur aus einer anderen Flüssigkeit. Ein Forschungsteam aus Vietnam und Norwegen zeigt in einer neuen Studie, wie stark diese scheinbar kleine Unterscheidung die Aussage eines KI-Tests verändert.
Die am 17. Oktober in Scientific Reports veröffentlichte Arbeit untersucht organische Farbstoffe aus der Familie der Benzothiadiazole. Werden die Daten nach ganzen Molekülen statt nach einzelnen Messungen aufgeteilt, fällt die Modellgüte deutlich niedriger aus. Für die Materialforschung entscheidet die Aufteilung damit darüber, welche Frage ein guter Testwert überhaupt beantwortet.
701 Messungen sind keine 701 Moleküle
Die untersuchten Farbstoffe nehmen Licht bestimmter Wellenlängen auf und können Licht wieder abgeben. Solche Eigenschaften sind beispielsweise für Leuchtmaterialien und fluoreszierende Markierungen interessant. Welche Wellenlängen auftreten, hängt sowohl vom Aufbau des Moleküls als auch von seiner Umgebung ab. Ein anderer gelöster Farbstoff und derselbe Farbstoff in einem anderen Lösungsmittel sind deshalb zwei verschiedene Arten von Veränderung.
Der verwendete Datensatz enthält 701 Einträge, aber nur 174 unterschiedliche Moleküle. Viele wurden in mehreren Flüssigkeiten untersucht; insgesamt sind 26 Lösungsmittel vertreten. Eine Tabellenzeile beschreibt jeweils eine Kombination aus Molekül und Lösungsmittel samt gemessenen Lichtwellenlängen.
Für einen üblichen Test bekommt das Modell einen Teil der Zeilen zum Lernen. Die übrigen bleiben zur Prüfung zurück. Bei einer zufälligen Aufteilung können Messungen desselben Moleküls auf beiden Seiten landen. Die KI hat dann schon etwas über dessen Struktur gelernt und muss vor allem einschätzen, wie das Lösungsmittel seine optischen Eigenschaften verschiebt.
Die Trennung verändert die Prüfungsfrage
Das Team um Duc Toan Truong hielt deshalb zusätzlich alle Messungen eines Moleküls zusammen. Taucht eine Struktur im Test auf, darf keine ihrer Lösungsmittelvarianten im Training stehen. Das Verfahren prüft also, wie gut die Modelle mit bisher ungesehenen Molekülen innerhalb dieser Farbstofffamilie umgehen.
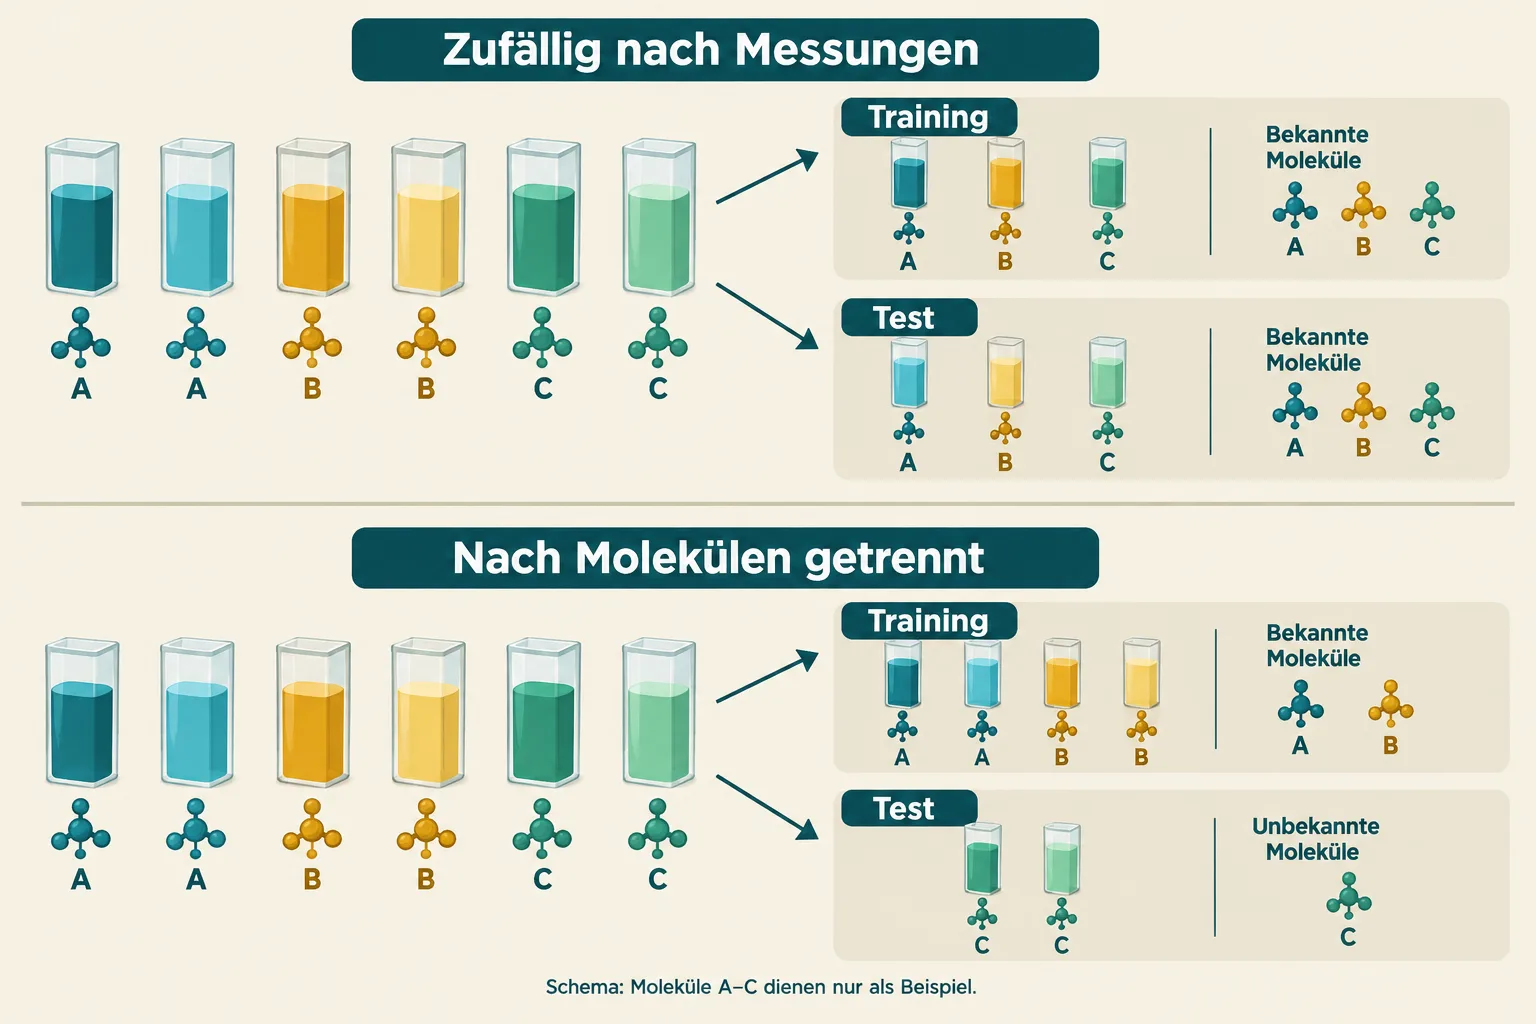
Bei zufällig getrennten Messzeilen erreichten die besten Baummodelle R²-Werte von 0,941 für die Lichtaufnahme und 0,916 für die Lichtabgabe. R² beschreibt, wie gut ein Modell die Unterschiede der Messwerte erklärt; es ist keine Quote richtig geratener Moleküle. Gegenüber diesen Bestwerten lag der strengere Gruppentest nach Angaben der Autoren um ungefähr 0,27 bis 0,29 R²-Punkte niedriger.
Verglichen werden dabei ein zufälliger Test mit besonders guten Ergebnissen und eine gruppierte Kreuzvalidierung, bei der wechselnde Molekülgruppen zurückgehalten werden. Die Zahlen zeigen somit die Bedeutung verschiedener Prüfverfahren. Als einheitliche Fehlerquote aller Materialmodelle lassen sie sich nicht lesen.
Wie stark auch einzelne Trainingsläufe streuen, zeigt das untersuchte tiefe neuronale Netz: Sein bester R²-Wert für die Lichtaufnahme lag bei 0,954. Über 20 zufällige Initialisierungen gemittelt waren es 0,831. Ein Spitzenwert und das typische Verhalten desselben Verfahrens erzählen also ebenfalls unterschiedliche Geschichten.
Was ein molekularer Fingerabdruck verrät
Auch die Darstellung der Moleküle spielt eine Rolle. Die Forschenden verglichen sogenannte Morgan-Fingerabdrücke: Zahlenfolgen, die charakteristische Teilstrukturen erfassen. Eine binäre Variante hält fest, ob ein Baustein vorkommt. Eine zählende Variante bewahrt zusätzlich, wie oft er vorkommt. Das ähnelt dem Unterschied zwischen einer Zutatenliste und einem Rezept mit Mengenangaben.
Für diesen Datensatz erwies sich die zählende Darstellung als starke Grundlage. Aufwendigere Ansätze wie Graphen-Netzwerke lieferten in den untersuchten Vergleichen keinen besseren Ersatz. Wiederkehrende chemische Bausteine enthalten hier wichtige Information darüber, wie sich Ladung im Molekül verteilt und dadurch seine Lichtwechselwirkung verändert.
Für die praktische Nutzung ergeben sich zwei Aufgaben: Wer zu einem bekannten Farbstoff ein passendes Lösungsmittel sucht, kann von den untersuchten Modellen profitieren. Wer neue Molekülstrukturen entwerfen will, braucht Trainingsdaten mit größerer struktureller Vielfalt. Die Arbeit prüft diese Frage intern an den 174 Benzothiadiazol-Molekülen; eine zusätzliche externe Datensammlung wurde nicht getestet. Der entscheidende Blick auf einen KI-Erfolg beginnt damit schon vor dem Ergebnis: Was durfte das Modell während des Lernens bereits sehen?
Quellen
- Duc Toan Truong, Phuong Chu Thi Hong, Phuong Nam Le Pham und Thuat T. Trinh: Molecule-aware machine learning for predicting absorption and emission of benzothiadiazole derivatives, Scientific Reports, 17. Oktober 2026, akzeptierte Frühfassung.
- Dieselben Autoren: Akzeptiertes Originalmanuskript mit Methoden und Ergebnisvergleichen, 17. Oktober 2026.
Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft.