Eine Software kann nach ihrem Umbau fehlerfrei starten und trotzdem den falschen Betrag ausgeben. Genau diese Schwierigkeit rückt OpenAI mit zwei am 19. Oktober vorgestellten Programmiertests in den Mittelpunkt. Sie untersuchen, wie KI mit seltener genutzten Sprachen wie COBOL und Fortran zurechtkommt. Für Menschen, die solche Systeme warten, entscheidet sich der Nutzen an einer anspruchsvollen Frage: Bleibt nach einer Änderung auch das Verhalten erhalten?
Der eine Test lässt Modelle eine Datenbank in verschiedenen Sprachen bauen. Der andere verlangt, vorhandene COBOL-Programme in eine andere Sprache zu übertragen. Damit trennt die Veröffentlichung von OpenAI zwei Aufgaben, die im Alltag leicht unter dem Wort Programmieren verschwinden: neue Funktionen schaffen und bestehende Regeln bewahren.
Ein kleiner Rechenunterschied verändert das Ergebnis
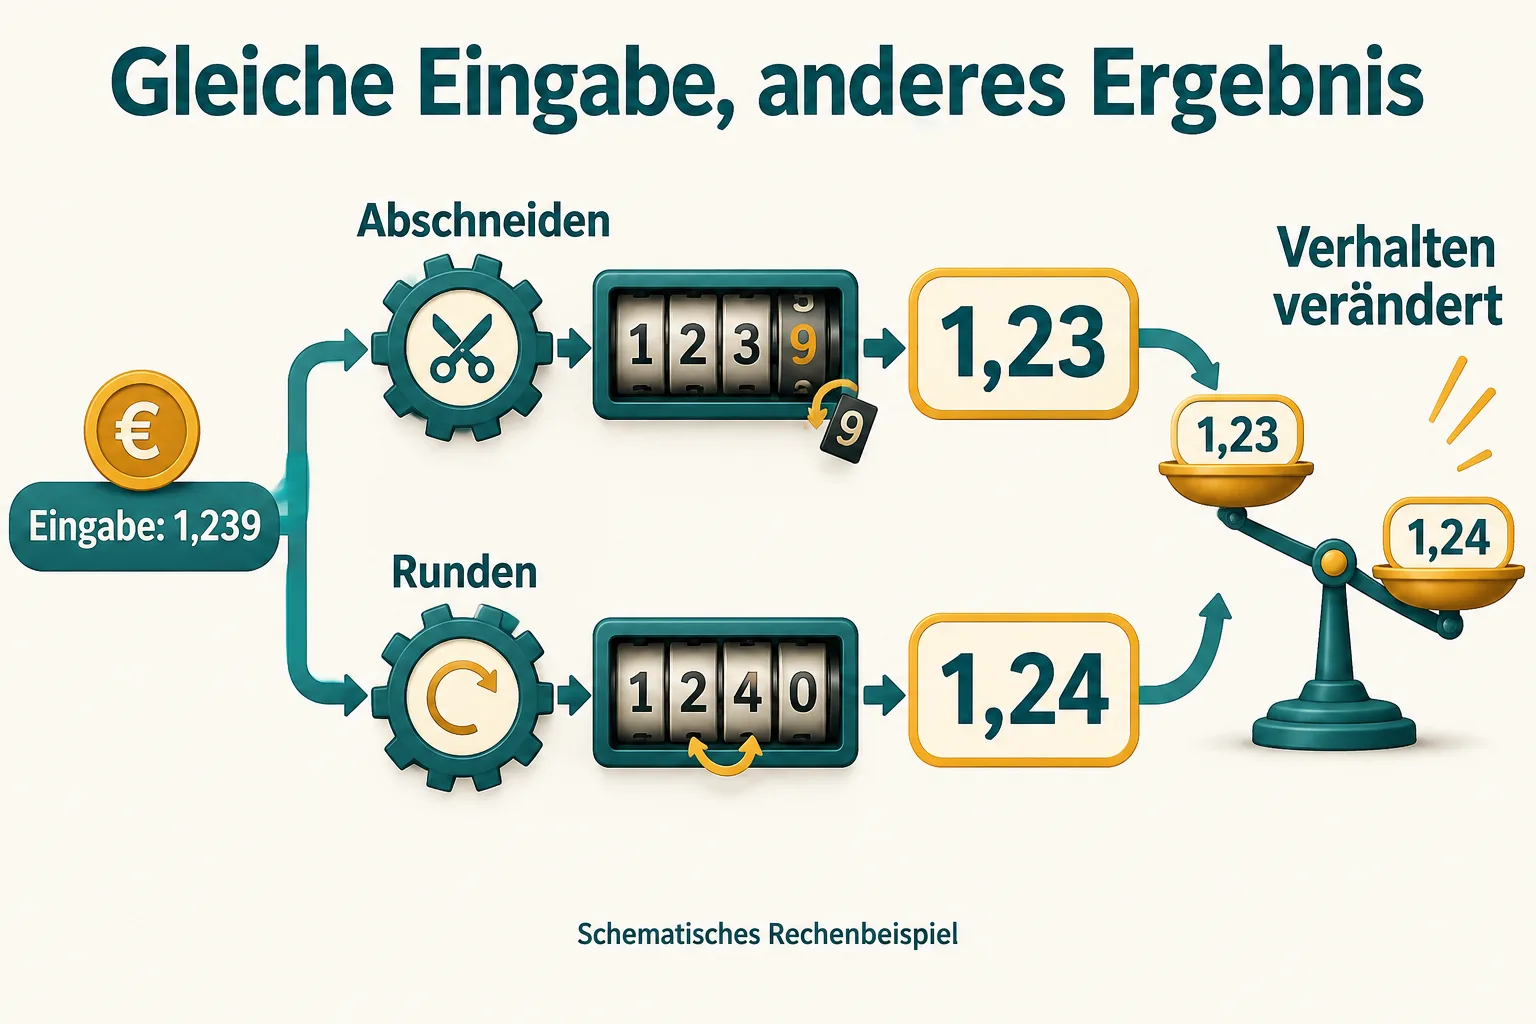
Man stelle sich ein Programm vor, das den Wert 1,239 in einem Feld mit zwei Nachkommastellen speichert. Beim Abschneiden bleibt 1,23 übrig. Beim Runden entsteht 1,24. Beide Ergebnisse sehen ordentlich aus. Beide lassen sich weiterverarbeiten. Welches richtig ist, hängt von der vorgegebenen Rechenregel ab.
Dieser Unterschied ist besonders tückisch, weil ein modernerer Programmtext durchaus verständlicher wirken kann. Wer dabei eine Rechenoperation austauscht, verändert jedoch möglicherweise die Bedeutung des alten Ablaufs. Der Umbau ähnelt der Übersetzung einer Spielanleitung: Die neuen Sätze dürfen flüssiger sein, aber die Spieler müssen hinterher noch dieselben Züge machen dürfen.
OpenAI beschreibt seine separate Migrationsprüfung deshalb als Vergleich der beobachtbaren Ausgaben bis auf das einzelne Byte. Nur wenn sämtliche Tests bestehen, gilt eine Übertragung als erfolgreich. Für GPT‑6.1 Sol nennt das Unternehmen bei hohem Denkaufwand 97,9 Prozent erfolgreiche Fälle. Diese Zahl gehört zu dieser konkreten Prüfung mit versteckten Tests.
Eine Datenbank wird zum gemeinsamen Prüfstand
Beim veröffentlichten MultiLangBench dient dagegen SQLite als Vorlage. Die KI soll eine kompatible Datenbank in einer vorgegebenen Sprache nachbauen. Die Dokumentation im Repository nennt SQLite 3.40.1. Ein Test besteht aus einer Ausgangsdatenbank, einer auszuführenden SQL-Anweisung und einer anschließenden Kontrollabfrage.
Die erzeugte Implementierung verändert zunächst die Daten. Danach prüft das echte SQLite, ob der neue Zustand zur erwarteten Ausgabe führt. Dadurch kann derselbe Ablauf Implementierungen in unterschiedlichen Sprachen vergleichen. Eine elegante Lösung bekommt keinen Sonderbonus: Entscheidend ist, was nach der Verarbeitung tatsächlich in der Datenbank steht.
Das Repository beschreibt rund 24.000 konvertierte Tests aus der SQLite-Testsammlung. Für reguläre Evaluationen sieht es eine Teilmenge von 272 Tests vor; größere Durchläufe sollen ausdrücklich kenntlich gemacht werden. Der Prüfstand ist öffentlich unter Apache 2.0 lizenziert. Während der Evaluation ist kein Internetzugriff erlaubt, vorhandene SQLite-Implementierungen sollen aus der Umgebung entfernt werden.
Was Unternehmen aus den Zahlen mitnehmen können
Die beiden Prüfungen beantworten damit unterschiedliche Fragen. Eine Datenbank neu aufzubauen verlangt, viele Funktionen zu einem zusammenhängenden System zu verbinden. Eine vorhandene Anwendung zu übertragen verlangt zusätzlich Treue zu ihren bisherigen Entscheidungen. Ein hoher Wert im ersten Verfahren ersetzt deshalb keinen erfolgreichen Durchlauf im zweiten.
Für ein eigenes Modernisierungsprojekt lässt sich daraus eine praktische Reihenfolge ableiten: Zunächst müssen die bisherigen Ergebnisse beobachtbar und vergleichbar werden. Dazu gehören gewöhnliche Eingaben ebenso wie Grenzfälle. Im Rechenbeispiel wäre ein Test nur mit 1,230 wenig hilfreich: Abschneiden und Runden liefern dort denselben Wert. Erst eine passend gewählte Eingabe macht den Unterschied sichtbar.
Auch eine Übertragung, die viele Standardfälle beherrscht, kann an einer seltenen Eingabe scheitern. Ein leerer Datensatz oder eine Zahl knapp unter einer Rundungsgrenze ist deshalb ein sinnvollerer Prüfstein als ein weiterer gewöhnlicher Betrag. Solche Beispiele machen die verborgenen Annahmen einer Anwendung sichtbar.
Damit wird die Testsammlung selbst zu einem wichtigen Teil des Umbaus. Sie beschreibt, welches Verhalten erhalten bleiben soll. Der öffentlich nachvollziehbare Datenbank-Prüfstand liefert dafür ein anschauliches Modell: Eingabe, Verarbeitung, überprüfbares Ergebnis. Für die eigene Anwendung müssen die Entwickler diese Verbindung mit ihren tatsächlichen Regeln herstellen.
Quellen
- OpenAI: Improving performance on low-resource programming languages, 19. Oktober 2026.
- OpenAI: MultiLangBench, README und Testsammlung, abgerufen am 20. Oktober 2026; Veröffentlichungsdatum im README nicht angegeben.
Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft.