KI-Rechenleistung wird jedes Jahr deutlich billiger. Trotzdem steigen Nutzung, Rechenbedarf und Mietpreise für Grafikprozessoren. Ein Ökonom aus dem 19. Jahrhundert hat dieses Muster zuerst beschrieben.
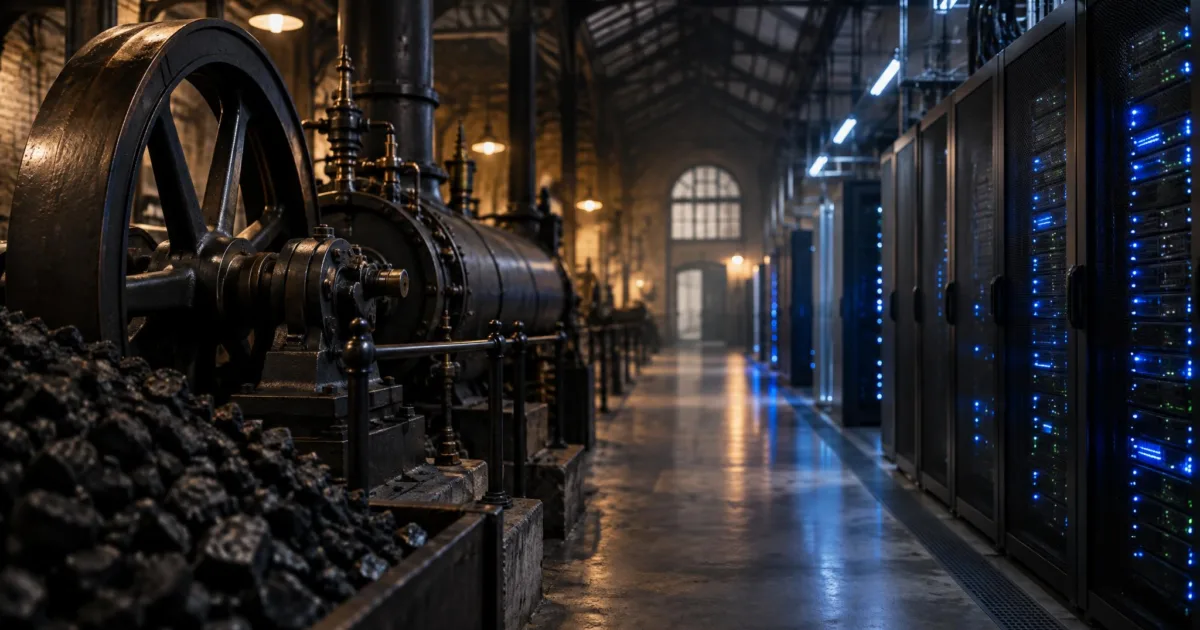
Im Jahr 1865 veröffentlichte der englische Ökonom William Stanley Jevons ein Buch über die Kohlevorräte Großbritanniens. Darin stellte er eine These auf, die bis heute zitiert wird. Nach seiner Beobachtung ließen sparsamere Dampfmaschinen den Kohleverbrauch des Landes steigen. Mehr als anderthalb Jahrhunderte später passt der Gedanke auffällig gut zur künstlichen Intelligenz.
Kurz gesagt
Das Jevons-Paradox beschreibt, dass Effizienzgewinne den Gesamtverbrauch einer Ressource erhöhen können. Bei KI sinkt der Preis pro Token für eine gegebene Leistung nach Messungen von Epoch AI und a16z um ein Vielfaches pro Jahr. Gleichzeitig wächst die Zahl der verarbeiteten Token auf Plattformen wie OpenRouter stark, und Grafikprozessoren kosten zur Miete mehr als zu Jahresbeginn.
Was Jevons 1865 beobachtete
Das Buch trägt den Titel „The Coal Question“. Jevons fragte darin, wie lange die britische Industrie mit ihren Kohlevorräten auskommen würde. Im siebten Kapitel geht es um die Ökonomie des Brennstoffs. Dort steht der zentrale Satz.
„It is wholly a confusion of ideas to suppose that the economical use of fuel is equivalent to a diminished consumption. The very contrary is the truth.“ Auf Deutsch heißt das sinngemäß, es sei eine reine Begriffsverwirrung, sparsamen Brennstoffeinsatz mit geringerem Verbrauch gleichzusetzen. Das Gegenteil sei wahr.
Jevons belegte das mit der Geschichte der Dampfmaschine. Die frühe Maschine von Newcomen verbrauchte so viel Kohle, dass sie sich nur in wenigen Bergwerken lohnte. Erst die Verbesserungen von Smeaton und vor allem von James Watt machten die Maschine wirtschaftlich. Jevons schreibt, die gesamte Geschichte der Dampfmaschine sei eine Geschichte der Ersparnis.
Jevons zitiert dazu den Ingenieur James Brindley. Der hielt die frühe Maschine für unpraktisch, solange ihr Kohleverbrauch nicht sinke. Smeaton gelang es später, die Effizienz der Maschine nahezu zu verdoppeln. Damit wurde sie nach Jevons erstmals wirtschaftlich nutzbar.
Mit jeder Ersparnis wurde die Dampfkraft für neue Zwecke rentabel. Fabriken, Eisenhütten und Pumpwerke setzten sie ein. Der Kohleverbrauch des Landes stieg. Die effizientere Technik hatte die Nachfrage nach ihrem Brennstoff vergrößert.
Der Mechanismus hinter dem Paradox
Ökonomen erklären das Paradox mit dem Preis pro Einheit. Wird eine Leistung effizienter erbracht, sinken ihre Kosten. Bei sinkenden Kosten fragen Kunden mehr davon nach. Wie stark die Nachfrage reagiert, beschreibt die Preiselastizität.
Ist die Nachfrage wenig elastisch, bleibt ein Teil der Einsparung erhalten. Die Fachliteratur spricht dann von einem Rebound-Effekt. Ist die Nachfrage sehr elastisch, frisst der Mehrverbrauch die Einsparung vollständig auf oder übertrifft sie. Für diesen Fall gibt es den Begriff Backfire.
Ein Teil des Effekts entsteht durch neue Anwendungen. Eine Technik, die vorher zu teuer war, lohnt sich dann für viele kleine Aufgaben. Bei der Dampfmaschine war das so, und bei KI zeigt sich ein ähnliches Muster.
Alltagsbeispiele gibt es viele. Ein sparsameres Auto senkt die Kosten pro Kilometer, und manche Halter fahren dann mehr. Sparsame Leuchten verleiten dazu, mehr Räume länger zu beleuchten.
Das britische Forschungszentrum UKERC hält in seiner Auswertung trotzdem fest, dass Energieeffizienz ein wirksamer Weg bleibt, um Verbrauch und Emissionen zu senken. Der Rebound-Effekt muss nach Einschätzung der Forscher aber offener berücksichtigt werden.
Licht, Rechenleistung, Bandbreite
Der US-Ökonom William Nordhaus hat die Geschichte der Beleuchtung über Jahrtausende nachgezeichnet. In einer Studie für das National Bureau of Economic Research von 1996 schätzt er, dass die Effizienz der Beleuchtung zwischen 1800 und 1992 um den Faktor 900 gestiegen ist. Das entspricht nach seiner Rechnung 3,6 Prozent pro Jahr. Nordhaus zeigt außerdem, dass klassische Preisindizes den Preisverfall des Lichts deutlich unterschätzen.
Mit dem billigeren Licht kamen beleuchtete Straßen, Fabriken mit Nachtschichten und Wohnungen, in denen abends lange Licht brennt. Die Menge an genutztem Licht wuchs mit dem sinkenden Preis.
Bei Computern lief es ähnlich. Gordon Moore sagte 1965 voraus, dass sich die Zahl der Bauteile auf einem Chip jedes Jahr verdoppeln werde. Laut Computer History Museum korrigierte er die Rate 1975 auf eine Verdopplung alle zwei Jahre. Die Rechenleistung pro Euro stieg enorm.
Zugleich wanderten Rechner vom Rechenzentrum ins Büro, in die Wohnung und in die Hosentasche. Die Zahl der Geräte und Anwendungen wuchs mit jeder Generation.
Für die Bandbreite gibt es eine ähnliche Faustregel. Der Usability-Forscher Jakob Nielsen schätzt, dass die Bandbreite von Nutzern mit schnellen Anschlüssen um etwa 50 Prozent pro Jahr wächst. Seine Daten reichen von 1983 bis 2023. Mit jeder Stufe kamen neue Dienste hinzu, von Musik über Video bis zu Cloud-Speichern.
Wie schnell KI billiger wird
Für Sprachmodelle gibt es inzwischen mehrere Messungen. Das Forschungsinstitut Epoch AI hat 2025 untersucht, wie schnell der Preis für eine bestimmte Leistung in Benchmarks fällt. Je nach Leistungsniveau sanken die Preise um das 9-Fache bis 900-Fache pro Jahr. Der Median lag beim 50-Fachen.
Der Wagniskapitalgeber Andreessen Horowitz, kurz a16z, kam 2024 zu einem ähnlichen Ergebnis. Als GPT-3 im November 2021 öffentlich zugänglich wurde, kostete eine Million Token 60 Dollar. Ein Modell mit vergleichbarer Leistung im Benchmark MMLU kostete laut a16z zuletzt 0,06 Dollar. Das ist ein Rückgang um den Faktor 1.000 in drei Jahren.
a16z beschreibt das als Trend von etwa einer Zehnerpotenz pro Jahr. Die Autoren betonen, dass jede solche Preissenkung neue Anwendungen wirtschaftlich macht. Jevons hatte denselben Zusammenhang für die Dampfmaschine beschrieben.
Eine Einschränkung gehört dazu. Diese Zahlen gelten für eine feste Leistungsstufe. Die jeweils besten Modelle sind nicht im selben Maß billiger geworden. Laut a16z kostete das damalige Spitzenmodell o1 pro Ausgabe-Token so viel wie GPT-3 zum Start.
Nutzung und Rechenbedarf steigen
Die Nachfrage entwickelt sich in die Gegenrichtung. a16z hat am 23. Oktober 2026 eine Grafik mit Daten der Plattform OpenRouter veröffentlicht. OpenRouter leitet Anfragen von Entwicklern an viele Sprachmodelle weiter und veröffentlicht Ranglisten nach verarbeiteten Token.
Die Grafik zeigt die wöchentliche Token-Menge mit Datenstand 18. Oktober 2026. Im November 2025 lag sie unter zehn Billionen Token pro Woche. Im Oktober 2026 waren es mehr als 150 Billionen. Das ist mehr als das Fünfzehnfache in knapp einem Jahr.
a16z weist selbst darauf hin, dass OpenRouter nur einen kleinen Ausschnitt des Marktes abbildet. Große Anbieter wie OpenAI, Google oder Anthropic verkaufen den größten Teil ihrer Kapazität direkt. Die Kurve taugt deshalb als Indikator für die Richtung und weniger für die absolute Größe.
Der zweite Indikator sind die Mietpreise für Grafikprozessoren. Nach Daten von Ornn Data, die a16z auswertet, kostet jedes erfasste Modell zur Miete mehr als zu Jahresbeginn. Das gilt auch für den A100 aus dem Jahr 2020. Gegenüber einer linearen Abschreibung über sechs Jahre liegen die Preise laut a16z zwischen 9 und 143 Prozent höher.
Wo der Vergleich an Grenzen stößt
Das Jevons-Paradox ist keine Naturgesetzmäßigkeit. Ob ein Effizienzgewinn den Verbrauch erhöht, hängt davon ab, wie viel ungedeckte Nachfrage es gibt. Bei Kohle im 19. Jahrhundert war diese Nachfrage riesig.
Bei KI spricht derzeit vieles für einen ähnlichen Befund. Die Datenlage ist allerdings dünn.
Ein Teil des Wachstums hat zudem eigene Ursachen. KI-Agenten erledigen längere Aufgaben und verbrauchen dabei mehr Token pro Auftrag. Neue Modelle denken vor der Antwort länger nach. Beides erhöht den Token-Verbrauch auch ohne Preiseffekt.
Mehr Nutzung führt außerdem nicht automatisch zu mehr Umsatz. Billige Modelle übernehmen viel Volumen, während ein großer Teil des Geldes an teure Spitzenmodelle geht. Wie Nutzung und Ausgaben auseinanderlaufen, zeigt unsere Analyse zu vielen KI-Token und wenig Umsatz.
Was das für Strom und Rechenzentren bedeutet
Für die Energiefrage ist dieser Zusammenhang zentral. Sparsamere Chips und bessere Software senken den Strombedarf pro Anfrage. Ob der Gesamtverbrauch sinkt, hängt von der Zahl der Anfragen ab. Wie viel bessere Software aus vorhandener Hardware herausholen kann, beschreibt unser Beitrag zu Software und Auslastung in Rechenzentren.
Der Ausbau der Infrastruktur hängt dabei an Netzanschlüssen, Genehmigungen und Bauzeiten. Aus angekündigten Kapazitäten wird erst nach und nach nutzbare Rechenleistung. Warum Ausbau und Baustopp gleichzeitig auftreten, erklärt unser Text zu KI-Rechenzentren.
Für Unternehmen, die KI einsetzen, folgt daraus eine praktische Regel. Ein sinkender Preis pro Token senkt nicht automatisch die Rechnung. Wer mehr Prozesse automatisiert, zahlt am Ende oft mehr. Wie Preisunterschiede bei kleinen Modellen aussehen, zeigt unser Beitrag zu Claude Haiku 5.5 und den API-Preisen.
Für die kommenden Monate lohnen drei Kennzahlen einen regelmäßigen Blick. Die erste ist der Preis pro Million Token für eine feste Leistungsstufe. Die zweite ist die verarbeitete Token-Menge auf offenen Plattformen wie OpenRouter. Die dritte sind die Mietpreise für Grafikprozessoren.
Fallen die Preise weiter, während Menge und Mietpreise steigen, bestätigt sich das Muster. Sinkt die Menge trotz fallender Preise, wäre die Nachfrage gesättigt. Einen anhaltenden Rückgang zeigen die öffentlichen Daten bisher nicht.
Fazit
Jevons beschrieb 1865 eine Wirkung, die sich bei Licht, Computern und Bandbreite wiederholt hat. Wird eine Leistung billiger, wächst ihre Nutzung oft schneller, als der Preis fällt. Die verfügbaren Daten deuten darauf hin, dass KI diesem Muster folgt.
Belastbar ist vor allem die Richtung. Die Preise pro Token sinken, die gemessene Nutzung steigt, und Rechenleistung bleibt knapp. Wie groß der Effekt im gesamten Markt ist, lässt sich mit öffentlichen Daten bisher nicht genau beziffern.
Quellen
- William Stanley Jevons, The Coal Question, London 1865 (Internet Archive)
- a16z, Charts of the Week, Attention is All You Need, 23.10.2026
- OpenRouter, LLM Rankings
- a16z, Welcome to LLMflation, 12.11.2024
- Epoch AI, LLM inference prices have fallen rapidly but unequally across tasks
- William D. Nordhaus, Do Real-Output and Real-Wage Measures Capture Reality? The History of Lighting Suggests Not, NBER 1996
- Computer History Museum, Moore’s Law Predicts the Future of Integrated Circuits
- Jakob Nielsen, Nielsen’s Law of Internet Bandwidth
- UKERC, The Rebound Effect
Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft.