Ein lesbares Gesprächsprotokoll spart Arbeit. Es kann aber auch genau dort unzuverlässig werden, wo eine Mitschrift mehr sein soll als eine bequeme Erinnerung: bei Zahlen, Eigennamen, Negationen oder einer nachträglich geglätteten Selbstkorrektur. Googles neues Modell Gemini 3.5 Transcribe setzt an dieser Lücke zwischen Roh-Audio und brauchbarem Text an.
Der Fortschritt liegt nach dem dokumentierten Produktstand vor allem in einer zusätzlichen Aufbereitungsstufe. Google unterscheidet zwischen einem kontinuierlichen Live-Weg und der Verarbeitung aufgezeichneter Dateien. Beide liefern Text, erfüllen aber unterschiedliche Aufgaben. Aus dieser Trennung folgt auch eine praktische Grenze: Transkription ist noch kein Sprachagent, der verlässlich handeln darf.
Zwei Wege für unterschiedliche Arbeitsabläufe
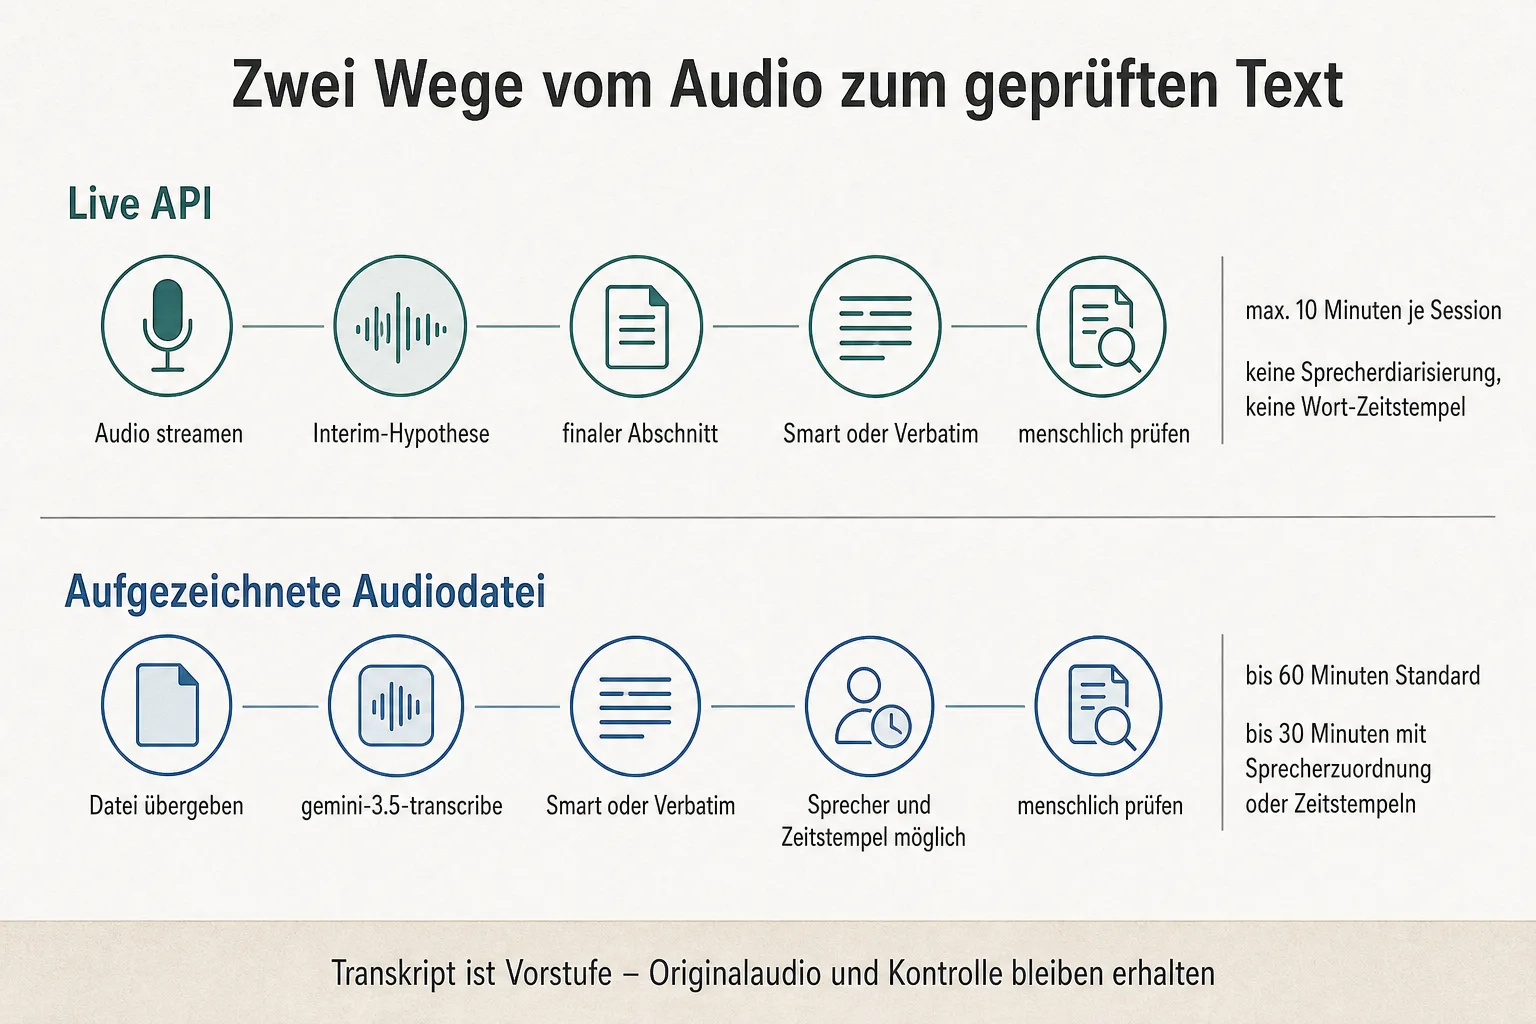
Für laufendes Audio ist gemini-3.5-transcribe-live über die Live API vorgesehen. Der Dienst liefert während des Sprechens vorläufige Textabschnitte und nach einer Pause oder dem Ende eines Gesprächszugs einen finalisierten Abschnitt. Google dokumentiert für diese Sessions eine Grenze von zehn Minuten. Sprecherzuordnung und Wort-Zeitstempel gibt es im Live-Weg nicht.
Aufgezeichnete Audiodateien laufen dagegen über die Interactions API an gemini-3.5-transcribe. Dort dokumentiert Google zusätzlich Sprecherzuordnung und Wort-Zeitstempel. Standard-Anfragen können bis zu einer Stunde Audio verarbeiten; mit Sprecherzuordnung oder Wort-Zeitstempeln liegt die dokumentierte Grenze bei 30 Minuten. Das ist für ein Meetingprotokoll oder die nachträgliche Auswertung eines Gesprächs etwas anderes als Untertitel in einer laufenden Sitzung.
Für Teams ist diese Unterscheidung wichtiger als der Modellname. Wer während eines Gesprächs schnell mitlesen will, muss vorläufige Ausgaben von finalem Text trennen. Wer nachvollziehen muss, wer was wann gesagt hat, braucht eher den aufgezeichneten Weg – und muss dessen Grenzen bei Dauer und Sprecherzuordnung mit einplanen.
Smart macht Texte lesbarer, Verbatim hält die Spur offen
Google bietet für beide Wege einen Smart- und einen Verbatim-Modus an. Smart entfernt Füllwörter, bearbeitet Selbstkorrekturen und formatiert den Text. Das kann aus einer mündlichen, sprunghaften Aussage eine brauchbare Mitschrift machen. Verbatim bleibt näher am Wortlaut.
Diese Unterscheidung ist keine technische Fußnote. Eine Smart-Fassung kann für Notizen sehr hilfreich sein und zugleich eine Zahl, eine Einschränkung oder einen Eigennamen anders wiedergeben, als er gesagt wurde. Ars Technica beschreibt nach einem begrenzten Rambler-Test eine brauchbare Bereinigung kurzer Textblöcke, weist aber ebenfalls darauf hin, dass der Wortlaut dabei verändert wird. Für Verträge, medizinische Gespräche, Kundendaten oder freizugebende Entscheidungen bleibt deshalb das Originalaudio wichtig. Eine Verbatim-Spur und eine menschliche Kontrolle sind die naheliegenden Ergänzungen.
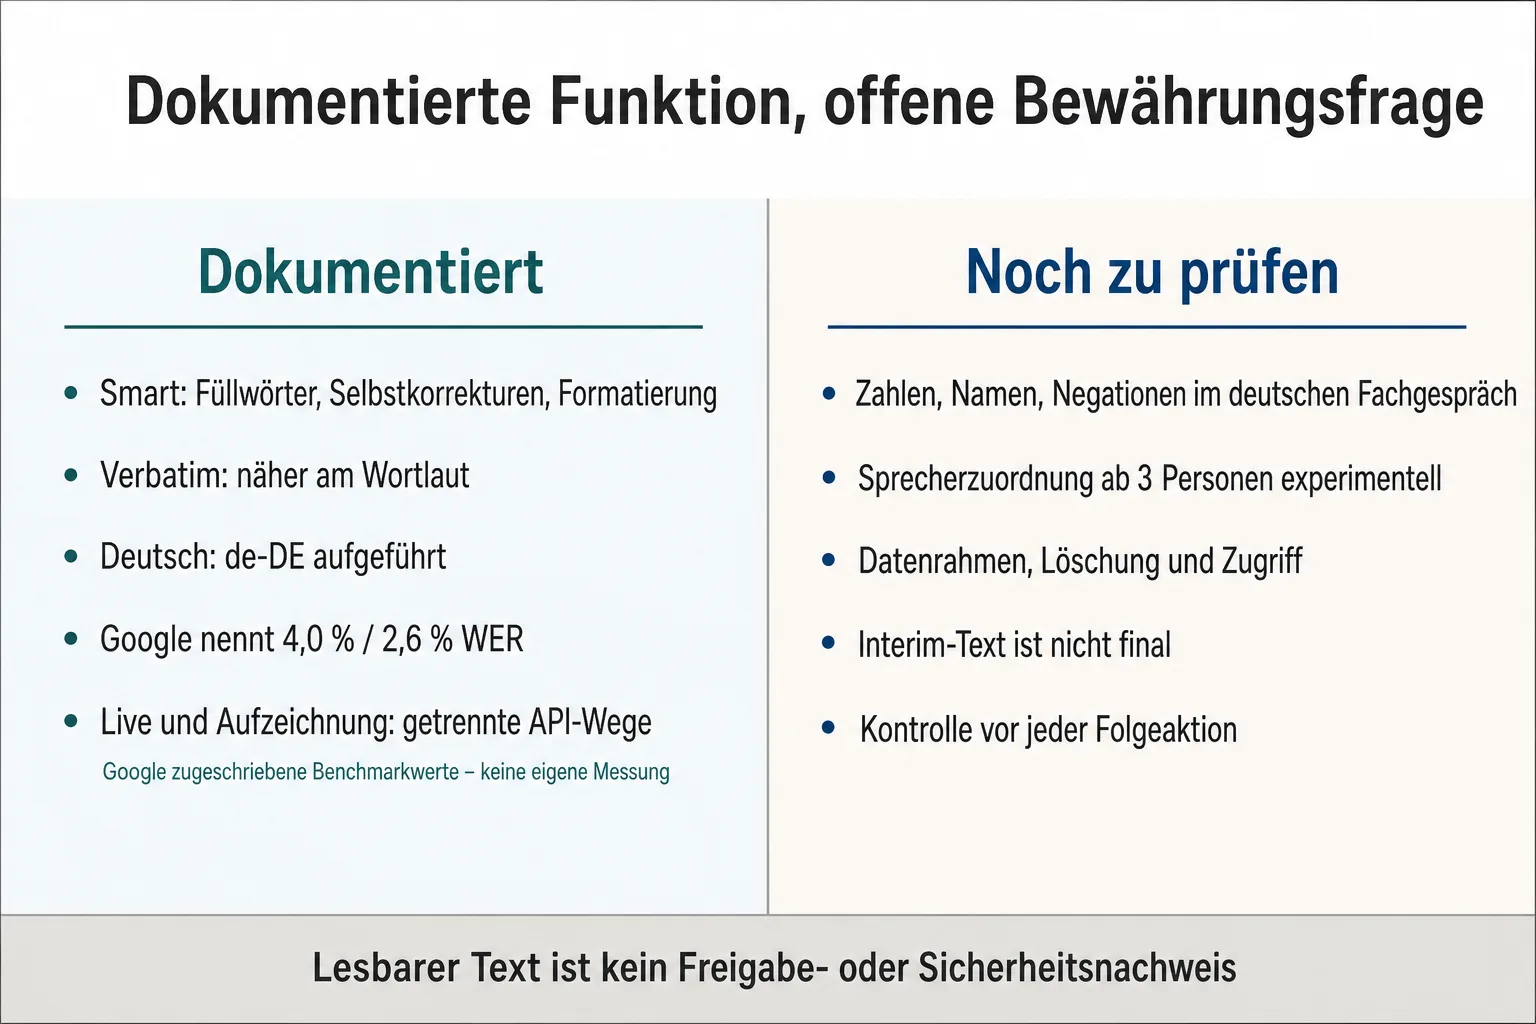
Auch die Sprecherfunktion verlangt eine genaue Lesart. Die aktuelle Dokumentation nennt bis zu acht Sprecher, markiert die Zuordnung ab drei Personen aber als experimentell. Die ursprüngliche Google-Ankündigung spricht vorsichtiger von bis zu drei Sprechern. Daraus lässt sich keine robuste Diarisierung für große Runden ableiten. Zudem lassen sich Smart-Transkription, Sprecherdiarisierung und Wort-Zeitstempel laut Dokumentation nicht beliebig kombinieren.
Benchmarkwerte beschreiben keine deutsche Alltagssituation
Google nennt unter Verweis auf Artificial Analysis eine durchschnittliche Word Error Rate von 4,0 Prozent für Streaming und 2,6 Prozent für nicht gestreamtes Audio. Außerdem soll die Zeit bis zum finalen Transkript gegenüber Chirp 3 um 70 Prozent gesunken sein. Das sind konkrete Hinweise auf den angestrebten Produktfortschritt, aber keine Fehlerfreiheitsgarantie.
Die Redaktion hat diese Werte nicht selbst gemessen. Artificial Analysis bietet einen eigenen Vergleichskontext für Wortfehlerrate, Geschwindigkeit und Preis, die konkreten Zahlen waren in der direkt lesbaren Oberfläche jedoch nicht als stabile Tabellenzeilen sichtbar. Deshalb bleiben sie Google zugeschriebene Benchmarkangaben. Sie beantworten nicht, wie gut ein deutsches Fachgespräch mit Hintergrundlärm, wechselnden Mikrofonen, Bestellnummern oder regionalen Akzenten funktioniert.
Wo die eigentliche Arbeitsprüfung beginnt
Google stellte Gemini 3.5 Transcribe am 26. August 2026 vor und bietet die Modellvarianten für Entwickler nach eigenen Angaben als Public Preview an. Deutsch ist in der Dokumentation als de-DE aufgeführt. Beides sagt noch nichts darüber aus, ob der Zugang für jedes Konto, Land oder jeden Produktionsablauf verfügbar ist.
Für einen realen Einsatz wäre ein kontrollierter Ablauf sinnvoll: Originalaudio bleibt erhalten, Smart- und Verbatim-Fassung lassen sich vergleichen, vorläufige Live-Ausgaben werden nicht als endgültig behandelt. Erst danach sollte ein Mensch Zahlen, Namen, Negationen, Sprecher und Kontext prüfen. Wenn aus einem Transkript später ein Tool-Aufruf oder eine andere Aktion entstehen soll, braucht auch dieser Schritt eine eigene Freigabe und Protokollierung.
Audioaufnahmen, Sprecheridentitäten und Kundendialoge können personenbezogene oder sensible Informationen enthalten. Die Modellvorstellung klärt weder den konkreten Datenrahmen noch Aufbewahrung, Löschung, Zugriffsrechte oder einen deutschen beziehungsweise europäischen Compliance-Status. Das muss vor dem produktiven Einsatz im jeweiligen Konto- und Vertragsmodell geprüft werden.
Ein nützlicher Schritt, aber kein autonomer Sprachassistent
Gemini 3.5 Transcribe kann Sprache für Meetings, Diktate und Supportgespräche brauchbarer machen, weil es nicht bei der bloßen Worterkennung stehen bleiben will. Die technische Dokumentation beschreibt die dafür nötigen Bausteine und Grenzen recht klar: Live und Aufzeichnung sind getrennte Wege, Smart und Verbatim unterschiedliche Ergebnisse, Sprecherdaten und Zeitstempel sind keine Live-Funktion.
Der nächste belastbare Nachweis wäre ein unabhängiger deutscher Test mit Fachvokabular, Zahlen, Eigennamen, Hintergrundlärm und mindestens drei Sprechern. Bis dahin ist die sinnvolle Rolle klarer umrissen: als assistierte Transkriptionsstufe mit menschlicher Abnahme – nicht als Ersatz für Originalaudio oder als Freigabe für automatische Entscheidungen.
Quellen und weiterführende Informationen
- Google: Intelligent transcription with Gemini 3.5 Transcribe
- Google AI for Developers: Audio transcription
- Google AI for Developers: Live transcription with Gemini Live API
- Artificial Analysis: Google Gemini – Speech-to-Text-Vergleich
- Ars Technica: Google announces Gemini 3.5 Transcribe
Hinweis: Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft. Stand: 2026-08-27.