Ein Gespräch aufnehmen und anschließend durchsuchen, ohne die Audiodatei für die Erkennung an einen Cloud-Dienst schicken zu müssen: Das ist mit lokal ausgeführten Sprachmodellen möglich. FluidVoice Labs hat dafür die Gewichte seines Modells Fluid Speech Pro veröffentlicht. Es wandelt Sprache in Text um und unterstützt nach Angaben der Entwickler 25 europäische Sprachen, darunter Deutsch.
Das Modell steht auf Hugging Face unter der Lizenz CC BY 4.0 bereit. Die Veröffentlichung der offenen Gewichte datiert eine Fachchronik auf den 13. November; die Modellkarte selbst nennt November 2026. Die Dateien richten sich vor allem an Entwickler und Menschen, die sie in eine Anwendung einbauen oder selbst ausführen möchten. Ein herunterladbares Modell ist noch kein fertiges Aufnahmeprogramm.
Vom Tonsignal zum durchsuchbaren Text
Bei der automatischen Spracherkennung verarbeitet Software eine Aufnahme und gibt die erkannten Wörter als Text aus. Fluid Speech Pro baut laut Modellkarte auf Nvidias Parakeet TDT 0.6B v3 auf. Das Modell erkennt die Sprache automatisch und ergänzt Satzzeichen und Großschreibung. Je nach verwendeter Version lassen sich außerdem Zeitmarken für Wörter oder Abschnitte ausgeben. Das hilft etwa, eine Textstelle später in der Aufnahme wiederzufinden.
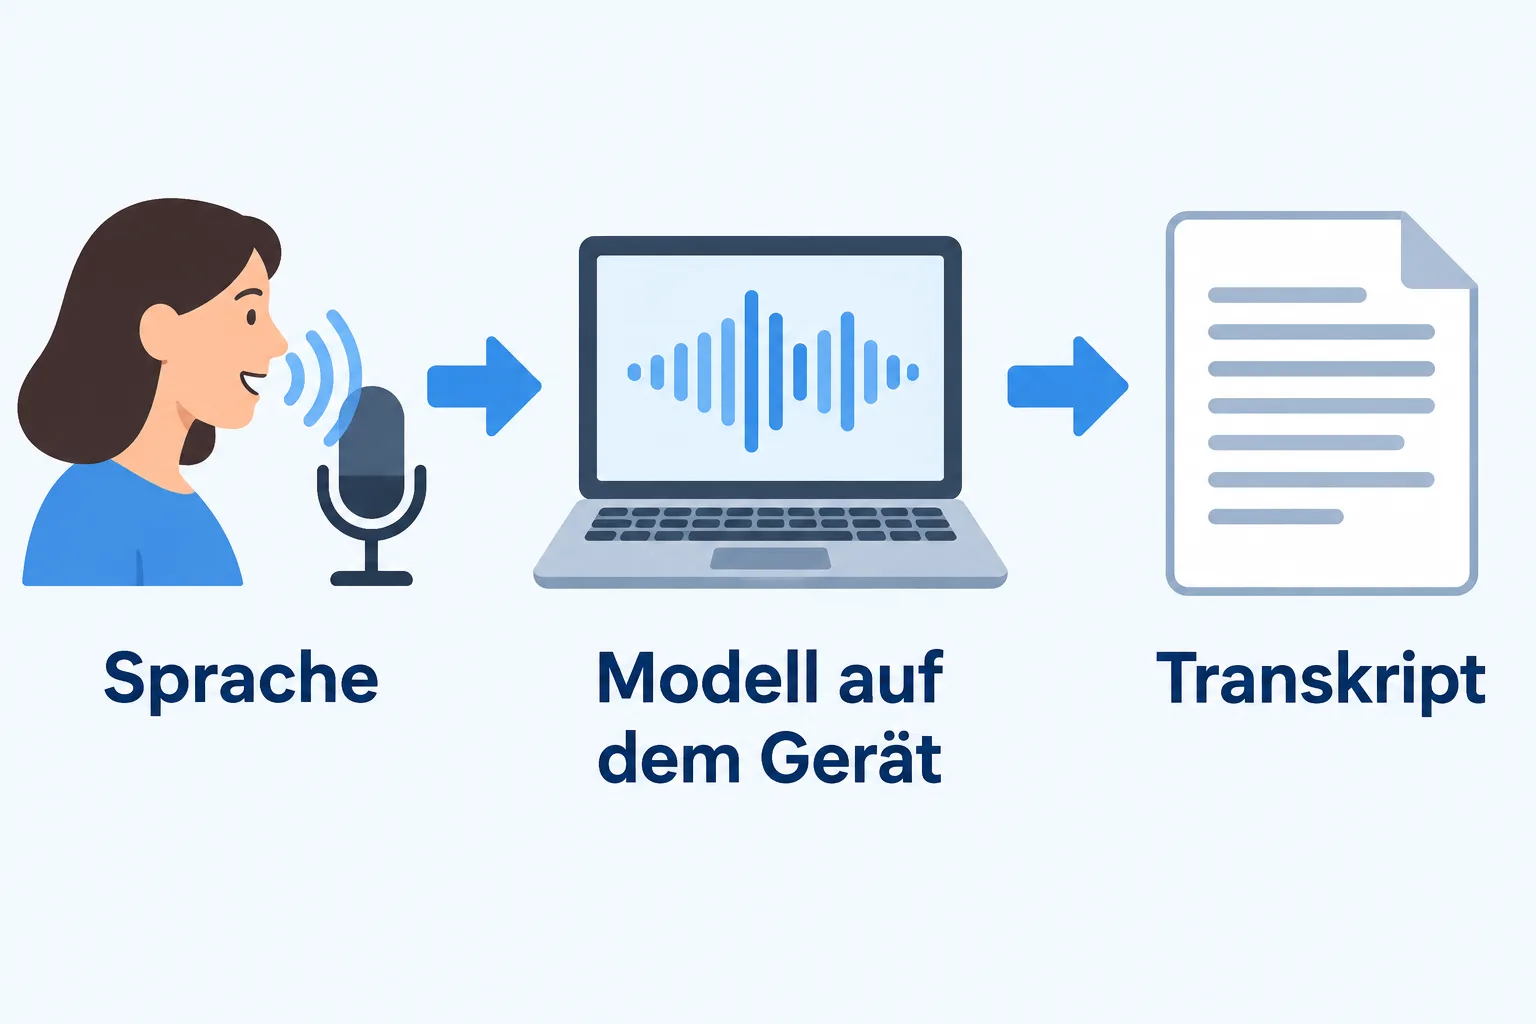
Die Entwickler nennen rund 630 Millionen Parameter. Das sind gelernte Zahlenwerte, mit denen das Modell eingehende Audiodaten verarbeitet. Die Anzahl allein sagt weder, wie schnell es auf einem bestimmten Rechner läuft, noch wie zuverlässig es ein Gespräch versteht. Entscheidend sind auch die Software, die Hardware und die Aufnahme.
Welche Version für welches Gerät?
Die Modellkarte beschreibt mehrere Varianten. Die Referenzfassung mit NeMo und Transformers richtet sich unter anderem an Systeme mit Nvidia-Grafikprozessor. Daneben gibt es eine ONNX-Variante für Prozessoren, eine MLX-Version für Macs mit Apple Silicon und eine GGUF-Version für die C++-Umgebung parakeet.cpp. Eine Core-ML-Fassung ist für Apple-Anwendungen vorgesehen. Die Funktionen sind nicht überall identisch: Zeitmarken und der bereinigende Modus gehören beispielsweise zur NeMo-Referenzfassung; die GGUF-Version führt den bereinigenden Modus nicht auf.
Für Entwickler bedeutet das: Sie können eine passende Laufzeit auswählen, müssen aber Installation und Einbindung selbst prüfen. Wer eine fertige Anwendung verwendet, sollte in deren Einstellungen nachsehen, wo die Aufnahme verarbeitet und gespeichert wird. Die Möglichkeit, das Modell lokal zu betreiben, macht nicht automatisch jede App mit diesem Modell zu einer Anwendung ohne Datenübertragung.
Was die Fehlerquote aussagt
FluidVoice berichtet im eigenen Produktbeitrag eine durchschnittliche Wortfehlerrate von 6,06 Prozent über neun Testdatensätze. Diese Kennzahl vergleicht die erkannten Wörter mit einem Referenztranskript; fehlende, zusätzliche und falsch erkannte Wörter gehen in die Bewertung ein. Die Zahl beschreibt den verwendeten Testmix und ist keine feste Fehlerquote für jede deutsche Aufnahme.
Das zeigt schon die Spannweite der vom Anbieter aufgeführten Einzelwerte: Für einen Gesprächsdatensatz meldet FluidVoice 12,80 Prozent, für einen anderen Test deutlich weniger. Umgebung, Sprechweise, Fachbegriffe und Aufnahmequalität können das Ergebnis verändern. Gerade Namen und Zahlen sollten deshalb beim Gegenlesen mit dem Ton abgeglichen werden. Das gilt besonders, wenn aus einem Transkript eine verbindliche Aussage werden soll.
Glätten oder wörtlich festhalten?
Ein optionaler „Clean Mode“ entfernt laut Modellkarte Füllwörter und Wiederholungen. Das kann eine Notiz leichter lesbar machen. Für ein Protokoll, bei dem jedes gesprochene Wort zählt, sollte die Funktion ausgeschaltet bleiben. Auch dann bleibt ein automatisches Transkript eine maschinelle Interpretation der Aufnahme und sollte bei wichtigen Stellen überprüft werden.
Die offenen Gewichte schaffen einen zusätzlichen Weg für lokale Transkription. Ob er praktisch passt, hängt davon ab, ob das eigene Gerät die gewählte Version ausführen kann und welche Funktionen die verwendete Anwendung tatsächlich anbietet.
Quellen
- FluidVoice Labs: Fluid Speech Pro, Modellkarte, November 2026.
- FluidVoice Labs: Introducing Fluid Speech Pro, November 2026.
- Hotwired: Voice AI, Woche 46, 13. November 2026.
Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft.