Neun richtige Lösungen bei zehn Aufgaben sind ein auffälliges Ergebnis. Im dritten First-Proof-Test erreichte das KI-System ProofCouncil genau diesen Wert. Ein direkter Test von GPT-6 Astra kam auf sieben richtige Lösungen, berichten die Organisatoren in ihrer Mitteilung vom 14. Oktober. Die Aufgaben stammten aus der mathematischen Forschung und wurden von Fachleuten bewertet.
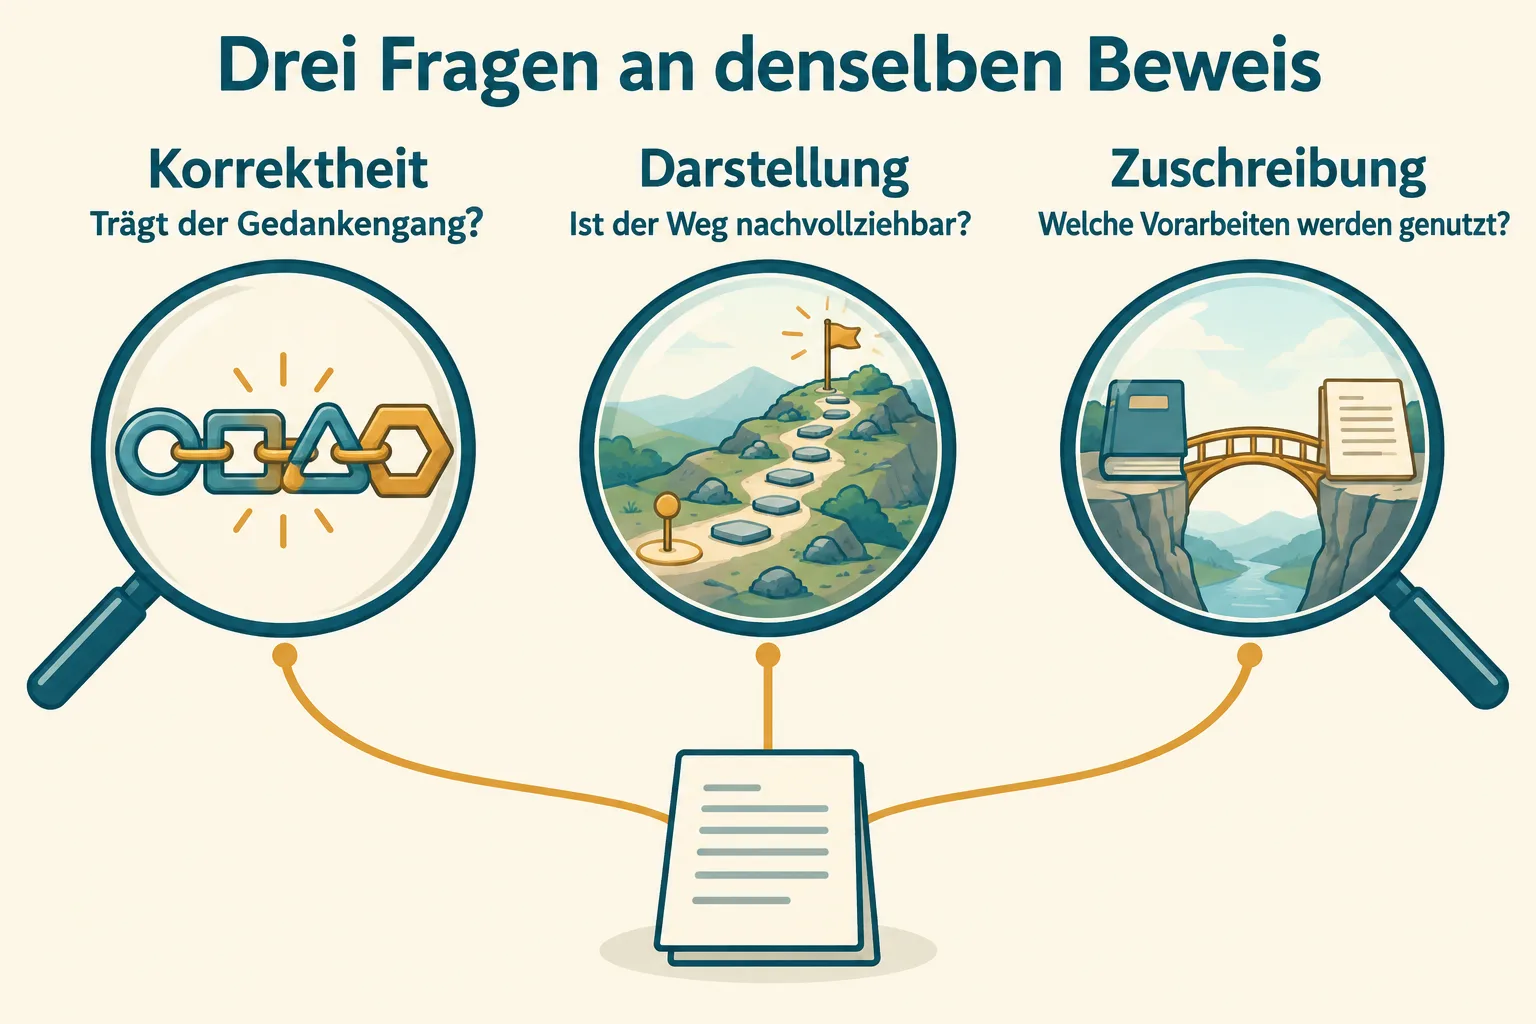
Die interessanteste Frage beginnt hinter dieser Trefferzahl: Was braucht es, damit eine richtige Lösung für die Forschung tatsächlich verwendbar wird? First Proof bewertet deshalb Korrektheit, Darstellung und Zuschreibung vorhandener Arbeiten getrennt. Diese drei Eigenschaften betreffen unterschiedliche Teile derselben wissenschaftlichen Arbeit.
Ein Beispiel mit drei verschiedenen Antworten
Nehmen wir eine einfache, selbst gewählte Behauptung: Die Summe zweier ungerader ganzer Zahlen ist gerade. Man kann sie an einigen Zahlen ausprobieren. Drei plus fünf ergibt acht, sieben plus neun ergibt sechzehn. Beide Beispiele passen zur Behauptung. Ein Beweis muss erklären, weshalb sie für jedes erlaubte Zahlenpaar gilt.
Dazu schreiben wir die erste ungerade Zahl als zwei mal eine ganze Zahl plus eins, die zweite ebenso. Beim Addieren entsteht zweimal die Summe der beiden ganzen Zahlen plus zwei. Die gesamte Summe besitzt damit den Faktor zwei und ist gerade. Der Gedankengang deckt alle Fälle ab, die in der Behauptung genannt wurden.
Man könnte dieselbe Überlegung auch in einer einzigen Formel ausdrücken. Für geübte Leser wäre das wahrscheinlich ausreichend. Einem Einsteiger hilft die Erklärung, weshalb jede ungerade Zahl diese Form hat und was der Faktor zwei bedeutet. Die Wahrheit der Behauptung ändert sich dadurch nicht. Ihre Zugänglichkeit schon.
Auf Forschungsniveau werden Voraussetzungen und Zwischenschritte anspruchsvoller. Der grundlegende Unterschied bleibt: Ein Argument kann richtig sein und trotzdem viel zusätzliche Arbeit verlangen, bevor jemand anderes es nachvollziehen kann. Die Qualität der Darstellung entscheidet mit darüber, wie leicht sich sein Ergebnis verwenden lässt.
Warum ein Literaturverweis Teil des Arguments sein kann
Mathematische Forschung baut auf vorhandenen Ergebnissen auf. Ein Beweis kann einen früheren Satz nutzen, statt ihn vollständig neu herzuleiten. Dafür muss der Verweis zum tatsächlich benötigten Ergebnis passen. Auch dessen Voraussetzungen müssen am richtigen Ort erfüllt sein.
Ein frei erfundenes Beispiel zeigt die Gefahr: Eine Lösung beruft sich auf einen Satz über stetige Funktionen. Wenn die behandelte Funktion eine Sprungstelle besitzt, hilft der passende klingende Literaturverweis nicht weiter. Das zitierte Werkzeug passt dann nicht zu diesem Teil der Aufgabe. Die Prüfung des Bezugs gehört zur Prüfung des Gedankengangs.
Zuschreibung erfüllt außerdem eine zweite Aufgabe. Sie macht erkennbar, welcher Teil bereits bekannt war und welchen neuen Beitrag die vorliegende Lösung liefert. Für Menschen, die auf dem Ergebnis aufbauen möchten, ist diese Landkarte oft ebenso wertvoll wie die letzte Zeile des Beweises.
Im aktuellen Test wurden bei GPT-6 Astra vier von zehn Lösungen mit angemessenen Literaturbezügen bewertet, bei ProofCouncil sieben von zehn. Die Unterschiede zwischen richtiger Lösung und passender Zuschreibung sind damit in den berichteten Ergebnissen konkret sichtbar. Beide Bewertungen stellen eine andere Frage an den abgegebenen Text.
Getestet wird auch der Weg um das Modell
Die offizielle Beschreibung der dritten Testrunde nennt die eingesetzten Systeme und ihre zugrunde liegenden Modelle. Bei ProofCouncil gehört zusätzliche Software zum Aufbau. Eine solche Umgebung wird häufig Harness genannt. Sie organisiert, wie Modelle aufgerufen werden und wie ihre Arbeit in einen größeren Ablauf eingebettet ist.
Das verändert den Gegenstand eines Vergleichs. Ein einzelner Modellaufruf und ein System mit mehreren Arbeitsphasen sind unterschiedliche Arbeitsweisen. Die zusätzliche Organisation kann beispielsweise dazu dienen, einen Ansatz auszuarbeiten und später erneut zu betrachten. Was ein bestimmtes System tatsächlich tut, lässt sich an seiner veröffentlichten Software und den Protokollen untersuchen.
Ein Vergleich mit menschlicher Arbeit hilft: Eine Person, die einmal spontan eine Lösung niederschreibt, arbeitet unter anderen Bedingungen als eine Gruppe mit Zeit für Überarbeitung. Das heißt nicht automatisch, dass die Gruppe erfolgreicher ist. Es bedeutet, dass man den Ablauf kennen muss, um das Ergebnis einzuordnen.
Für einen Anwender wäre deshalb eine praktische Frage, welches Gesamtverfahren er einsetzen könnte. Dazu gehören verfügbare Rechenzeit, Aufwand und die Art des zurückgegebenen Ergebnisses. Der Modellname allein beschreibt diese Kombination nur teilweise.
Eine klare Aufgabe macht Ergebnisse vergleichbar
First Proof ließ fünf Systeme zehn Aufgaben bearbeiten. Nach der Mitteilung hatte jedes System 24 Stunden Zeit und arbeitete ohne menschlichen Eingriff. Rund 30 Fachleute begutachteten anonymisierte Lösungen. Die Aufgaben waren von Menschen bereits gelöst, ihre Lösungen zuvor aber nicht öffentlich gemacht worden.
Dieser Aufbau schafft einen definierten Vergleichsraum. Die Systeme erhalten konkrete Probleme; die Bewertung betrachtet die abgegebenen Lösungen. Wer die Ergebnisse nachvollziehen möchte, findet auf der Batch-Seite Verweise auf menschliche und KI-generierte Lösungen, Berichte der Gutachter und Systemprotokolle.
Eine Trefferquote bekommt ihren Sinn aus genau dieser Umgebung. Zehn Aufgaben bilden eine konkrete Sammlung. Andere Fachgebiete, längere Lösungswege oder eine anders formulierte Aufgabe können andere Anforderungen stellen. Für die Weiterentwicklung ist deshalb interessant, welche Schritte gelungen sind und wo ein System Unterstützung braucht.
Auch der Verzicht auf eine Antwort gehört zum Umgang mit Schwierigkeit. Die neue Runde verwendet negative Wertungen, um falsche Antworten unattraktiver zu machen. Ein System muss damit entscheiden, wann es eine Lösung abgibt und wann es besser bei einem offenen Ergebnis bleibt. Das verbindet Leistungsfähigkeit mit der Einschätzung der eigenen Ausgabe.
Für die menschliche Prüfung kann auch die Reihenfolge der Erklärung viel ausmachen. Ein Text, der zuerst das Ziel eines Hilfsschritts nennt, gibt dem Leser einen Orientierungspunkt. Derselbe Schritt kann ohne diese Einordnung wie eine unerklärliche Rechnung wirken. Gute Darstellung macht daher nicht bloß vorhandene Sätze freundlicher; sie legt den Aufbau des Arguments frei.
Unser einfaches Zahlenbeispiel zeigt das im Kleinen. Sobald klar ist, dass die Teilbarkeit durch zwei bewiesen werden soll, ist die Darstellung ungerader Zahlen als „zweimal etwas plus eins“ verständlich motiviert. In einem langen Beweis übernehmen Definitionen und Zwischenziele diese Führung. Je besser sie zum Gedankengang passen, desto leichter kann ein anderer Mensch gezielt nach einer Lücke suchen oder einen brauchbaren Teil übernehmen.
Was nach einer richtigen Lösung noch passiert
Stellen wir uns vor, ein Forscher erhält einen korrekten, aber schwer lesbaren Beweis. Er muss Begriffe zuordnen, ausgelassene Übergänge ergänzen und verwendete Sätze nachschlagen. Erst dann kann er beurteilen, welche Teile sich für seine eigene Frage eignen. Die Zeitersparnis hängt somit auch von der Form der Übergabe ab.
Ein gut geschriebener Beweis legt seine Voraussetzungen früh offen. Er erklärt, welche Zwischenbehauptung gerade gezeigt wird und weshalb sie den nächsten Schritt ermöglicht. Dadurch können Leser den Gedankengang lokal prüfen, anstatt bei jeder Zeile das gesamte Argument neu zusammensetzen zu müssen.
Diese Arbeit der verständlichen Darstellung hat einen eigenen Wert. Ein Ergebnis, dessen Mechanismus klar wird, kann neue Fragen anregen. Man erkennt vielleicht, welche Voraussetzung abgeschwächt werden könnte oder an welcher Stelle sich ein ähnlicher Ansatz einsetzen lässt. Nachvollziehbarkeit unterstützt damit auch die nächste Forschungsidee.
Der Bericht zur dritten Runde beschreibt die getrennte Bewertung ausdrücklich als Teil seiner Methodik. Der Maßstab passt zu dieser praktischen Nutzung: Mathematische Korrektheit sagt, ob das Argument trägt. Darstellung und Zuschreibung helfen anderen Menschen, daraus verlässlich weiterzuarbeiten. Die neun richtigen Lösungen sind ein starker Teil des Ergebnisses. Wie viel nutzbare Forschungsarbeit daraus entsteht, zeigt sich auch an den übrigen beiden Teilen.
Quellen
- First Proof Foundation: Third Batch Press Release, 14.10.2026. https://1stproof.org/third-batch-press-release.html
- First Proof Foundation: Third Batch Benchmark, Aufbau und ergänzende Materialien. https://1stproof.org/third-batch.html
- Mohammed Abouzaid, Nikhil Srivastava, Rachel Ward, Lauren Williams: First Proof Third Batch, Version 1, 14.10.2026. https://hexagonmath.org/2610.00244Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft.