In einem Filmarchiv lässt sich nach dem Wort „Hund“ suchen. Ob die Suche auch einen Clip findet, in dem ein Hund bellt, hängt davon ab, was der Index über den Clip weiß. Eine herkömmliche Textsuche braucht dafür etwa eine Beschreibung oder eine Transkription, in der ein passendes Wort steht. Googles Modell EmbeddingGemma 2 bietet einen anderen Weg. Es kann geschriebenen Text, Bilder, Ton und Video in Zahlenfolgen abbilden, die eine Suchanwendung miteinander vergleicht. Google hat am 17. November auf den technischen Bericht zum bereits veröffentlichten Modell aufmerksam gemacht.
Der entscheidende Schritt ist die gemeinsame Darstellung. Eine Anfrage und ein Foto haben zunächst weder dieselbe Struktur noch dieselben Zeichen. Werden beide in vergleichbare Zahlen übersetzt, kann eine Suchanwendung ihre Nähe bewerten. Wie gut das klappt, hängt von der Bedeutung ab, die das Modell im Training mit diesen Zahlen zu verbinden gelernt hat.
Der Index speichert die Lage eines Inhalts im Suchraum
Ein Embedding ist eine Zahlenfolge, die ein Modell aus einem Inhalt berechnet. Man kann sich jede Zahl als eine Koordinate vorstellen. Bei zwei Koordinaten ließe sich die Folge auf Papier als Punkt einzeichnen. EmbeddingGemma 2 erzeugt laut Modellkarte standardmäßig 768 Koordinaten. Der Vergleich funktioniert rechnerisch nach einem ähnlichen Prinzip, auch wenn sich so viele Dimensionen nicht darstellen lassen.
Beim Aufbau eines Archivs berechnet die Anwendung eine solche Folge für jedes sinnvoll ausgewählte Stück Inhalt. Das kann ein Dokumentabsatz sein, ein Bild oder ein Ausschnitt aus einem längeren Video. Später wandelt sie die Anfrage ebenfalls in eine Zahlenfolge um. Der Suchindex ordnet die gespeicherten Einträge danach, wie ähnlich ihre Darstellung der Anfrage ist. Dabei zählt die Beziehung der Zahlen untereinander. Eine einzelne Zahl steht normalerweise weder für „Hund“ noch für eine bestimmte Farbe.
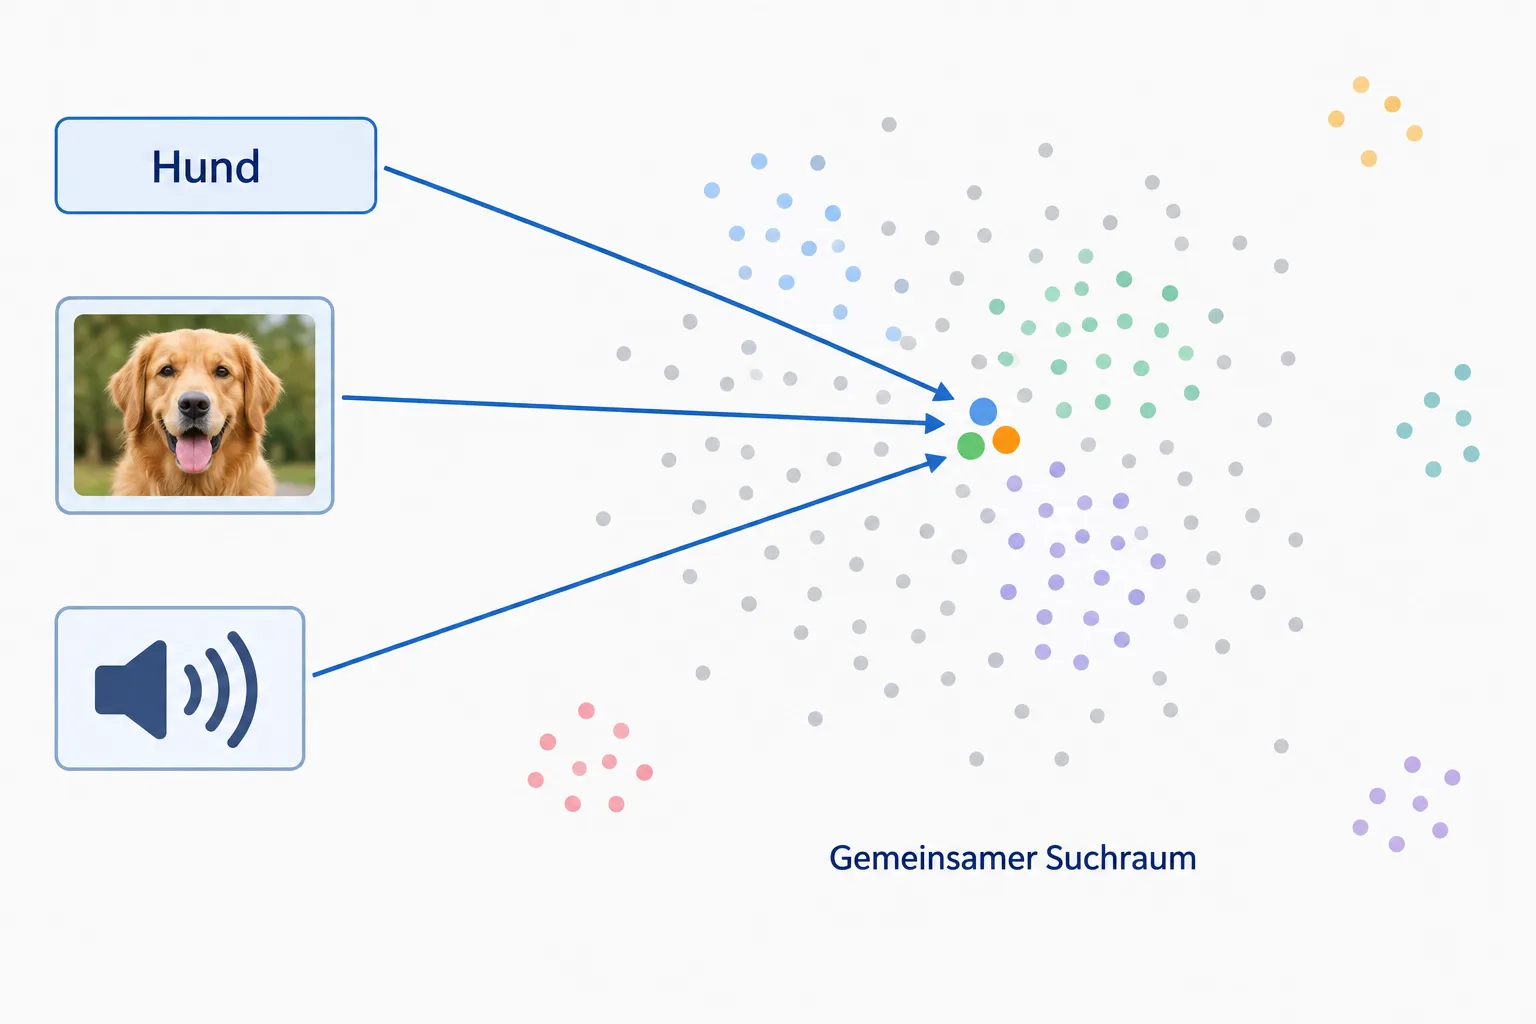
Wie Bild und Audio im selben Raum landen
Text, Bilder und Audio lassen sich am Eingang nicht gleich behandeln. Ein Bild besteht aus Bildpunkten, ein Audiosignal ändert sich in der Zeit, und Text wird in kleinere Zeichenfolgen zerlegt. EmbeddingGemma 2 verbindet deshalb eine gemeinsame Textbasis mit Modulen für Bild und Ton. Die Modellkarte beziffert den gesamten Umfang auf 740 Millionen trainierbare Größen. Wer nur ein Textarchiv aufbaut, kann laut Google die für sein Vorhaben entbehrlichen Module weglassen.
Die verschiedenen Eingaben sollen am Ende in denselben Suchraum passen. Das Team beschreibt in seinem technischen Bericht, wie es das Modell in mehreren Stufen für verschiedene Medien und Suchaufgaben trainiert hat. Am Beispiel des Hundes könnten eine passende Bildaufnahme und ein Ton mit Bellen im Suchraum näher an einer passenden Anfrage liegen als eine beliebige Aufnahme aus einer Werkstatt. Das ist eine Möglichkeit der Darstellung. Die Suchanwendung erhält eine Rangfolge von Ähnlichkeiten, auf deren Basis sie Kandidaten auswählt.
Bei einem längeren Video kommt eine weitere Entscheidung hinzu. Wer den gesamten Inhalt als einzigen Eintrag erfasst, bekommt einen Punkt für das Ganze. Wenn ein wichtiges Geräusch nur kurz vorkommt, kann es in dieser Darstellung an Bedeutung verlieren. Wird ein Video in Abschnitte zerlegt, kann die Suche einzelne Momente besser getrennt behandeln. Dafür entstehen mehr Einträge, und die Anwendung muss entscheiden, wie sie Treffer aus derselben Datei zusammenfasst.
Warum weniger Zahlen den Index kleiner machen
In einem großen Archiv fallen die Koordinaten für jeden Eintrag an. Werden von einem Vektor nur die ersten 128 statt 768 Koordinaten gespeichert, braucht die Liste bei gleicher Zahlendarstellung ein Sechstel des reinen Koordinatenspeichers. Metadaten und die Suchstruktur kommen hinzu. Der Platzbedarf des gesamten Systems schrumpft deshalb nicht zwingend um den gleichen Faktor.
Google hat das Modell so ausgelegt, dass auch gekürzte Darstellungen verwendbar bleiben. Neben 128 stehen laut Dokumentation 256 und 512 Dimensionen zur Wahl. Der Gewinn an Speicherplatz hat einen möglichen Preis. Wenn weniger Koordinaten zur Verfügung stehen, kann sich die Rangfolge sehr ähnlicher Inhalte verschieben. Wie deutlich das passiert, hängt unter anderem davon ab, welche Medien verglichen werden und wie fein die Suche unterscheiden soll. Die Modellkarte weist Ergebnisse für unterschiedliche Längen und Aufgaben getrennt aus.
Woran ein eigener Test ansetzen kann
Für ein Archiv mit Produktbildern kann es reichen, ähnliche Artikel zuverlässig in die erste Treffergruppe zu bringen. Bei einer Tonaufnahme, in der ein bestimmtes Geräusch für wenige Sekunden auftritt, zählen andere Kriterien. Ein Suchtest für das erste Archiv sollte prüfen, ob nahe verwandte Produkte auseinandergehalten werden. Ein Test für das zweite sollte messen, ob der richtige Abschnitt gefunden wird. Die besten Vergleichsdaten sind dafür einige echte Suchanfragen mit bekannten Treffern.
Ein gemeinsamer Zahlenraum spart Arbeit, wenn dieselbe Suchanfrage über mehrere Medien hinweg funktionieren soll. Die Qualität hängt weiterhin daran, welche Teile einer Datei indexiert werden, welche Vektorlänge eingesetzt wird und was ein Mensch als relevanten Treffer betrachtet. Google liefert mit EmbeddingGemma 2 einen Baustein für diese Suche. Erst die Entscheidungen im Archiv machen daraus eine Anwendung, die auf ein Wort tatsächlich mit dem passenden Bild oder Ton antwortet.
Quellen
- Google DeepMind, EmbeddingGemma 2 model card
- Henrique Schechter Vera et al., EmbeddingGemma 2: Unified and Efficient Multimodal Representations (arXiv v2), 2026-11-09
- Google, Read the EmbeddingGemma 2 technical report, 2026-11-17
Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft.