Ein KI-Modell kann offen verfügbar sein, während die Software für seinen effizienten Betrieb weitgehend hinter verschlossenen Türen bleibt. DeepSeek öffnet nun einen Teil dieses Maschinenraums: Seit dem 20. Oktober ist DeepInfer öffentlich zugänglich. Das Framework steuert die Berechnungen hinter DeepSeek V4.1 Flash. Für Entwickler wird damit sichtbar, wie aus einem gespeicherten Modell ein Strom von Antworten entsteht – und warum dafür mehr nötig ist als ein Download der Modellgewichte.
Die Gewichte enthalten die beim Training erlernten Zahlenwerte. Sie legen fest, wie das Modell Eingaben verarbeitet. Die Betriebssoftware organisiert dagegen die Arbeit: Welche Anfrage kommt wann an die Reihe? Auf welchen Chips wird gerechnet? Welche bereits berechneten Zwischenergebnisse lassen sich weiterverwenden? Gerade wenn viele Menschen gleichzeitig eine KI nutzen, bestimmen diese Entscheidungen mit, wie lange sie auf Antworten warten und wie viel Rechenleistung der Anbieter benötigt.
Eine Antwort entsteht in zwei verschiedenen Arbeitsphasen
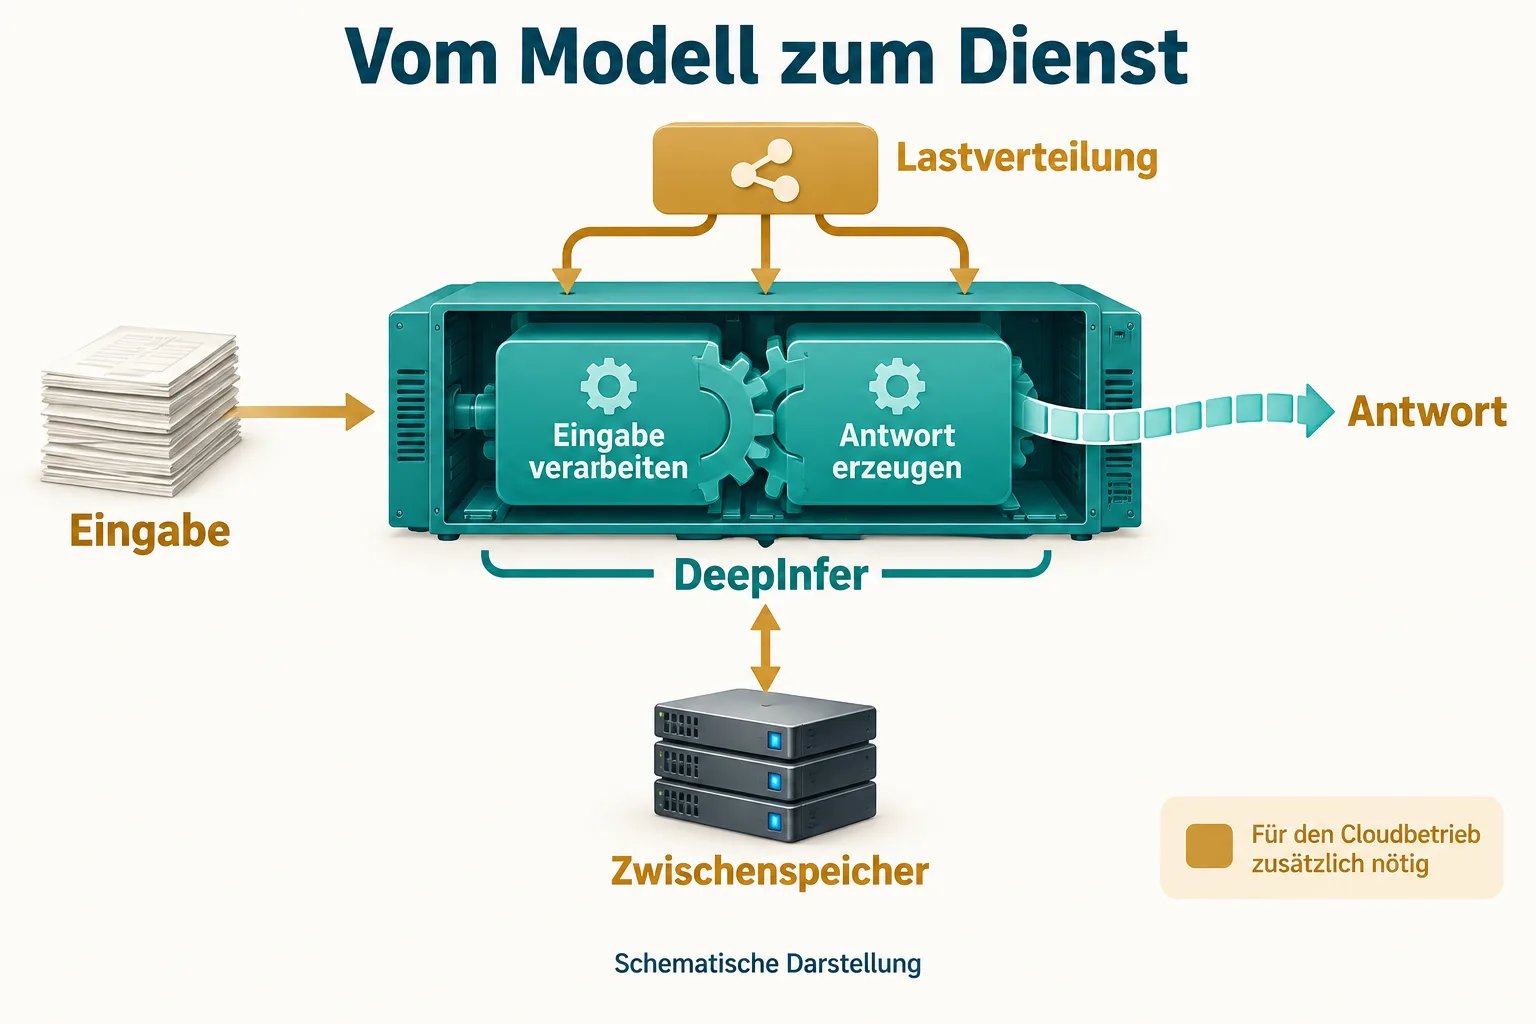
DeepSeek beschreibt in seiner technischen Erläuterung zum Betrieb eine wichtige Arbeitsteilung. Zunächst verarbeitet das System die Eingabe samt vorhandenem Gesprächskontext. Diese Phase heißt Prefill. Danach erzeugt es die Antwort schrittweise, Abschnitt für Abschnitt in kleinen Texteinheiten, den Tokens. Diesen Teil nennen Entwickler Decode. Beide Phasen beanspruchen die Hardware unterschiedlich und können deshalb auf getrennte Rechnergruppen verteilt werden.
Bei längeren Gesprächen steckt viel Arbeit bereits im verarbeiteten Kontext. Ein sogenannter KV-Cache bewahrt dafür berechnete Zwischenwerte auf. Wird derselbe Anfang später erneut gebraucht, kann das System darauf zurückgreifen. Anschaulich entspricht das einem Arbeitsplatz, auf dem die benötigten Unterlagen schon sortiert liegen: Die nächste Aufgabe beginnt mit dem vorhandenen Stand. Für einen großen Dienst müssen diese Unterlagen allerdings zuverlässig gespeichert, gefunden und rechtzeitig zum passenden Rechner gebracht werden.
Weniger Leerlauf zwischen den Rechenschritten
Auch innerhalb des Rechenkerns lohnt der Blick auf die Abläufe. Während ein Grafikprozessor am aktuellen Schritt arbeitet, kann der Hauptprozessor bereits den nächsten planen. DeepInfer überlappt diese Tätigkeiten durch asynchrones Scheduling. Der Zweck ist leicht verständlich: Teure Rechenchips sollen möglichst wenig Zeit damit verbringen, auf Verwaltungsarbeit zu warten.
Ein weiterer Baustein heißt DSpark. Dabei werden mögliche Fortsetzungen zunächst als Entwurf erzeugt und anschließend überprüft. DeepSeek beschreibt eine Planung, die berücksichtigt, welche vorgeschlagenen Tokens voraussichtlich angenommen werden. So konzentriert sich die Überprüfung auf aussichtsreiche Fortsetzungen. Ob und wie stark das einen konkreten Betrieb beschleunigt, hängt von dessen Hardware und Anfragen ab.
Offener Code für anspruchsvolle Hardware
Der Zugang richtet sich an Betreiber mit entsprechender Infrastruktur. Die aktuelle Kompatibilitätsliste nennt NVIDIA-Grafikprozessoren der Klasse SM100 und Huawei Ascend 950. Vorgesehen sind Linux und Python 3.12, ergänzt um die passende Softwareplattform CUDA 13 beziehungsweise CANN 9.2. Als unterstütztes Modell führt DeepSeek V4.1 Flash auf.
Die mitgelieferten Beispiele zeigen eine lokale Ausführung von Anfragen. Das Modell kann beim ersten Start aus dem Hugging-Face-Repository heruntergeladen oder aus einem vorhandenen lokalen Verzeichnis geladen werden. „Offline-Inferenz“ bezeichnet hier diesen Ausführungsmodus; der erste Modelldownload benötigt gegebenenfalls weiterhin eine Netzwerkverbindung.
Für einen vollständigen Cloud-Dienst fehlen in der Freigabe unter anderem das KV-Cache-System und die Lastverteilung zwischen mehreren parallelen Instanzen. DeepSeek erläutert deren Architektur, hält Teile des Codes aber wegen der engen Verbindung zur eigenen Infrastruktur noch zurück. Betreiber müssen diese Ebene ergänzen. Dabei sind zwei Ebenen zu unterscheiden: Im Modell bearbeiten spezialisierte Teilnetze, sogenannte Experten, bestimmte Rechenaufgaben. Deren Verteilung auf Chips gehört bereits zum Kern. Die Verteilung ganzer Nutzeranfragen zwischen mehreren laufenden Instanzen ist eine zusätzliche Aufgabe des Dienstes.
DeepInfer steht unter der Apache-Lizenz 2.0. Damit wird ein weiterer Teil der KI-Infrastruktur einsehbar und veränderbar. Der praktische Gewinn liegt im Zugang zu konkreten Betriebsverfahren: Entwickler können nachvollziehen, wie DeepSeek Rechenarbeit organisiert, und darauf aufbauen. Modell, Rechenkern und verlässlich erreichbarer Dienst bleiben dabei drei eigene Aufgaben.
Quellen
- DeepSeek-AI: DeepInfer, Repository und README; erste öffentliche Codefassung vom 20. Oktober 2026, abgerufen am 21. Oktober 2026.
- DeepSeek-AI: DeepSeek V4.1 Flash Inference Deployment Q&A; aktualisiert am 20. Oktober 2026, abgerufen am 21. Oktober 2026.
- DeepSeek-AI: Examples: Offline inference und Benchmark; abgerufen am 21. Oktober 2026.
- DeepSeek-AI: DeepInfer: Apache License 2.0; abgerufen am 21. Oktober 2026.
Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft.