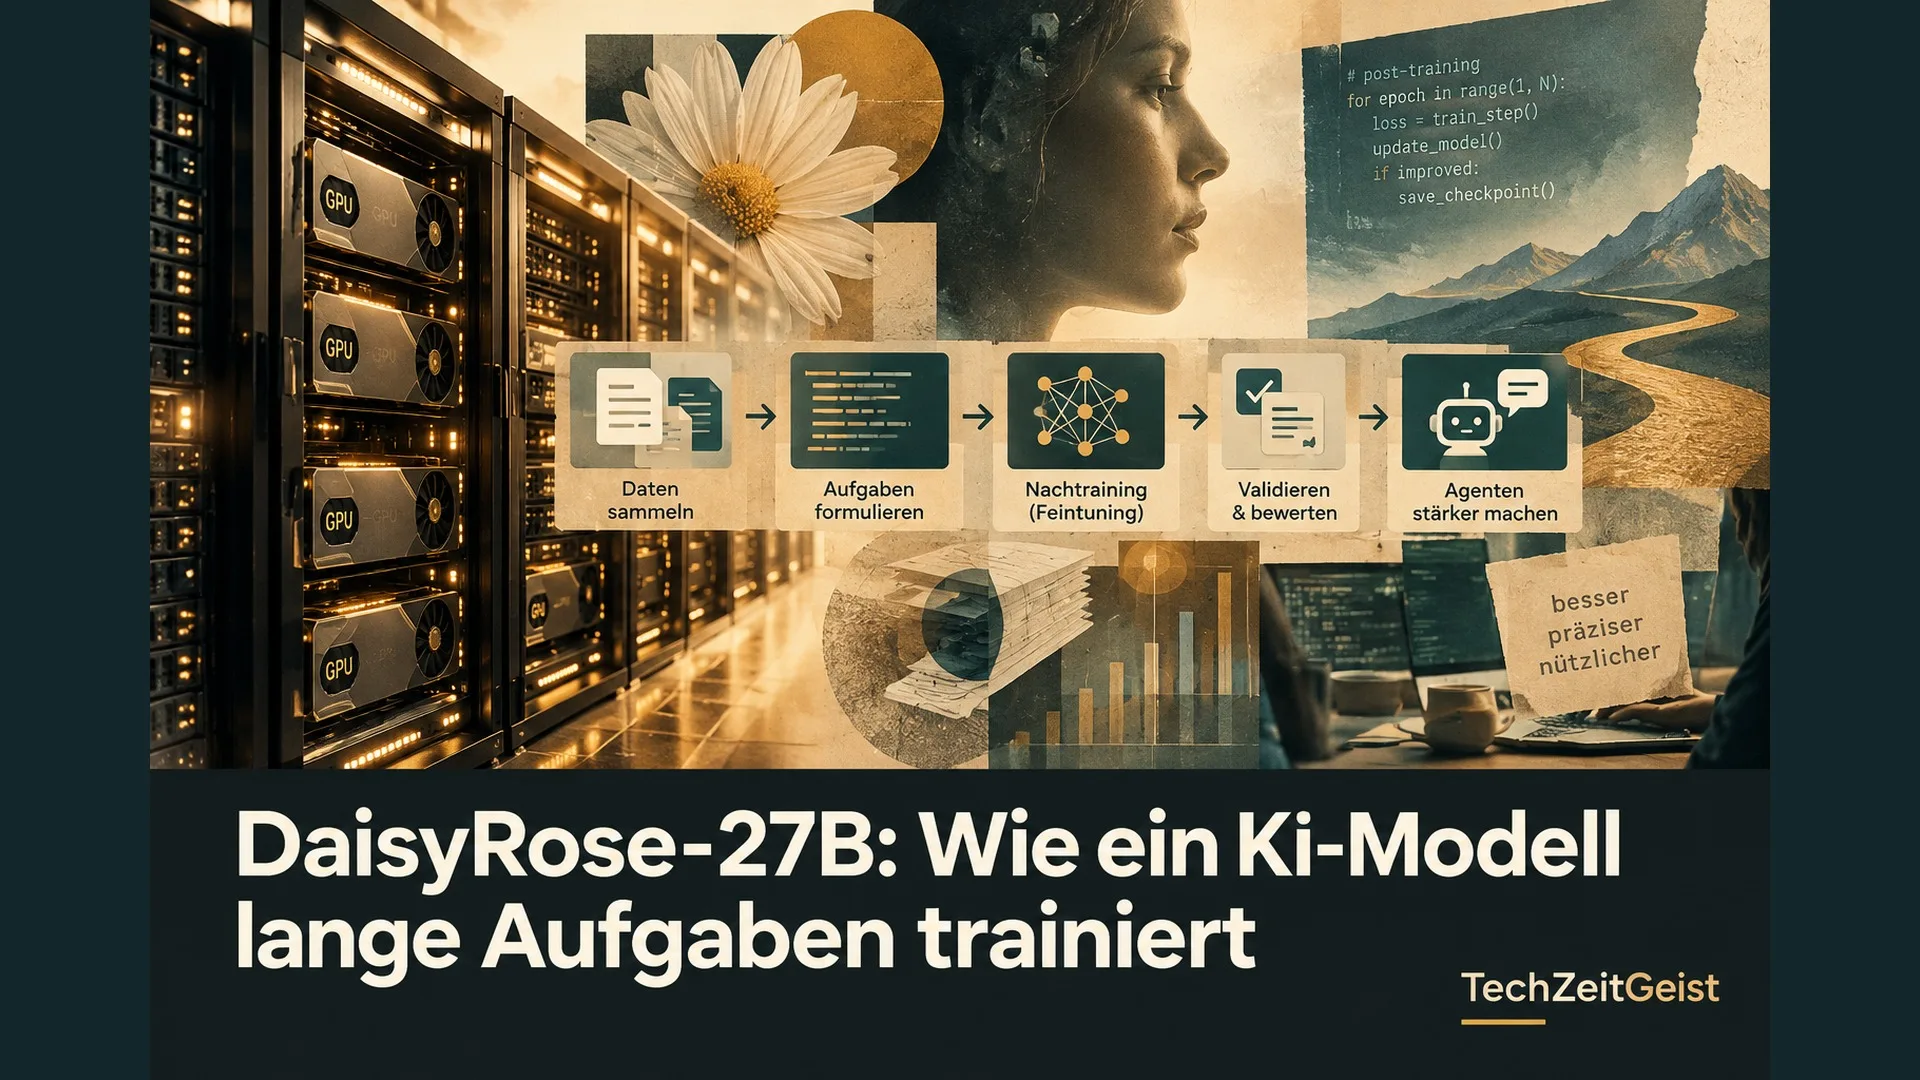
Ein KI-Agent soll nicht nur eine Frage beantworten, sondern eine Aufgabe in mehreren Schritten bearbeiten: Dateien untersuchen, Befehle ausführen und Ergebnisse prüfen. Für solche längeren Abläufe hat RadixArk sein Modell DaisyRose-27B nachtrainiert. Die am 18. November vorgestellte Variante baut auf Qwen3.8-27B auf und ist mit offen verfügbaren Modellgewichten erhältlich.
Das Neue liegt vor allem in der Art der Übungsaufgaben. Das Team nutzte nach eigenen Angaben rund 1.200 ausgewählte Aufgaben und verstärkendes Lernen. Dabei wird das Verhalten des Modells anhand der Ergebnisse seiner Versuche angepasst. Eine Trainingssitzung konnte insgesamt bis zu eine Million Tokens umfassen. Das bedeutet allerdings nicht, dass das Modell eine Million Tokens gleichzeitig im Blick behält.
Eine lange Aufgabe passt nicht vollständig ins Fenster
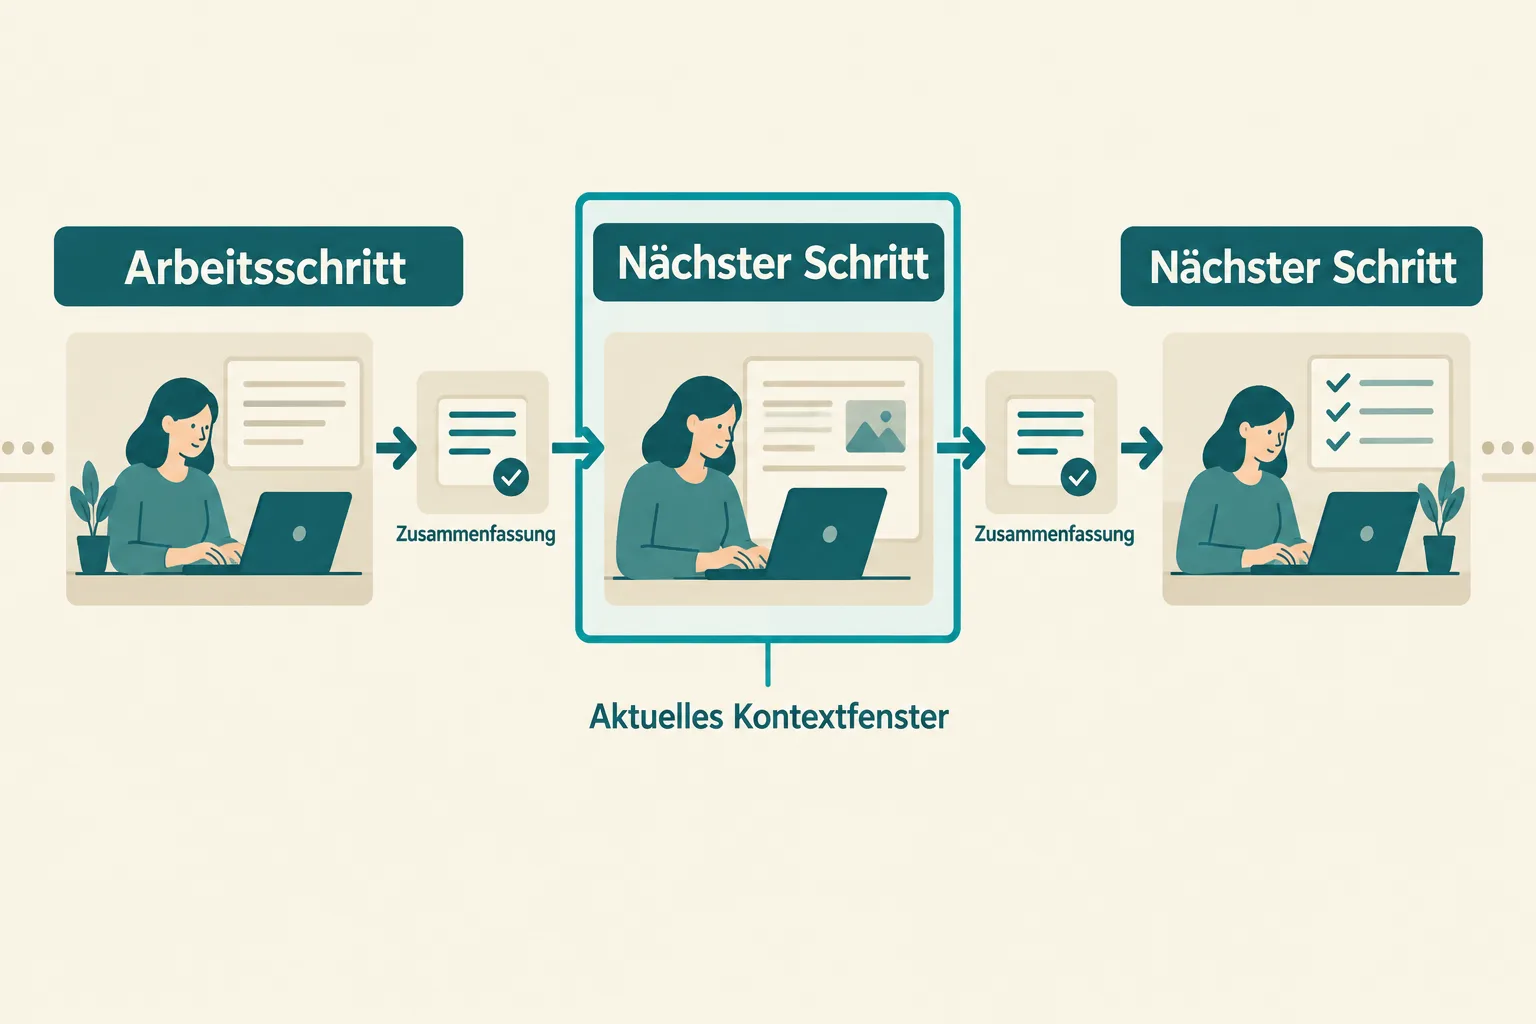
Ein Token ist ein Textbaustein; je nach Sprache und Inhalt kann er ein Wort, einen Wortteil oder ein Zeichen darstellen. Das Kontextfenster begrenzt, wie viel Information das Modell bei einem einzelnen Verarbeitungsschritt berücksichtigen kann. DaisyRose behält laut Modellkarte das Fenster des Ausgangsmodells: 262.144 Tokens.
Um längere Arbeitsläufe zu bewältigen, fasst die umgebende Software frühere Teile des Verlaufs zusammen und reicht diese Zusammenfassung weiter. Man kann sich das wie ein Arbeitsprotokoll vorstellen: Statt jedes Detail einer langen Sitzung erneut vorzulegen, enthält der nächste Schritt eine verdichtete Darstellung. Welche Informationen in der Zusammenfassung stehen, beeinflusst, was dem Modell später zur Verfügung steht.
Üben mit überprüfbaren Aufgaben
RadixArk und sein Partner Eigent AI wählten nach ihrem Entwicklerbericht Aufgaben aus Bereichen wie Softwareentwicklung und Wissenschaft. Jede sollte einen Fehler ansprechen, den das Ausgangsmodell machte, und mehrere voneinander abhängige Schritte verlangen. Die Entwickler überprüften außerdem, ob sich eine Aufgabe bestehen ließ, ohne das eigentliche Problem zu lösen.
Die Versuche liefen in abgeschotteten Arbeitsumgebungen, sogenannten Sandboxes. Dort konnte der Agent Befehle ausführen und Dateien bearbeiten; anschließend wurde das Ergebnis bewertet. Das ist für das Training bedeutsam, weil die Rückmeldung an eine überprüfbare Aufgabe gebunden ist. Eine gut bewertete Übungsumgebung ersetzt dennoch nicht die Prüfung eines konkreten Einsatzes.
Für den Trainingslauf setzte RadixArk nach eigenen Angaben 144 H200-Grafikprozessoren über 18 Tage ein. 128 davon erzeugten Versuche mit dem Agenten, während 16 das Modell anhand abgeschlossener Abläufe weitertrainierten. Das Team aktualisierte die Modellgewichte während des laufenden Betriebs. Der Aufwand zeigt, dass frei verfügbare Gewichte nicht bedeuten, dass ihre Herstellung ohne erhebliche Rechenressourcen möglich war.
Was die Testwerte zeigen und was nicht
Der Anbieter veröffentlicht Ergebnisse für mehrere Tests, darunter Aufgaben an einer Kommandozeile und Programmieraufgaben. Für DaisyRose nennt er bei Terminal Bench 4.1 einen Wert von 12,0 Prozent. Die Modellkarte erklärt, dass der Test über acht Wiederholungen je Aufgabe gemittelt wurde und eine Softwareumgebung mit Zusammenfassungen verwendete.
Bei der Gegenüberstellung mit dem Ausgangsmodell ist Vorsicht nötig: Die Modellkarte führt für Qwen3.8-27B in dieser Tabelle einen Wert aus Terminal Bench 4.0 auf. Der häufig genannte Vergleich mit 5,6 Prozent ist damit kein sauberer Vergleich derselben Testversion. Auch die übrigen Werte sind Angaben der Entwickler; wie sich das Modell bei einer bestimmten Aufgabe schlägt, hängt von Testaufbau, Werkzeugen und Einstellungen ab.
Offene Gewichte, praktische Grenzen
DaisyRose behält laut Modellkarte unter anderem die Bildverarbeitung und die Architektur des Ausgangsmodells. Die Gewichte stehen unter Apache 2.0 in mehreren Genauigkeitsformaten bereit. Das BF16-Paket benötigt nach Angaben des Entwicklers etwa 52 Gigabyte für die Gewichte; andere Formate sind kleiner und stellen teils besondere Anforderungen an die Hardware. Wer das Modell selbst betreiben möchte, muss zusätzlich den Speicherbedarf der Ausführung berücksichtigen.
Für Nutzer ist damit vor allem die Trennung zweier Größen wichtig: Eine lange Folge von Arbeitsschritten kann durch Zusammenfassungen über das einzelne Kontextfenster hinausreichen. Wie zuverlässig die so erhaltenen Informationen eine Aufgabe tragen, muss sich am jeweiligen Einsatz zeigen.
Quellen
- RadixArk: DaisyRose-27B: Pushing the Frontier of Post-Training Efficiency, 18. November 2026
- RadixArk: Modellkarte DaisyRose-27B
Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft.