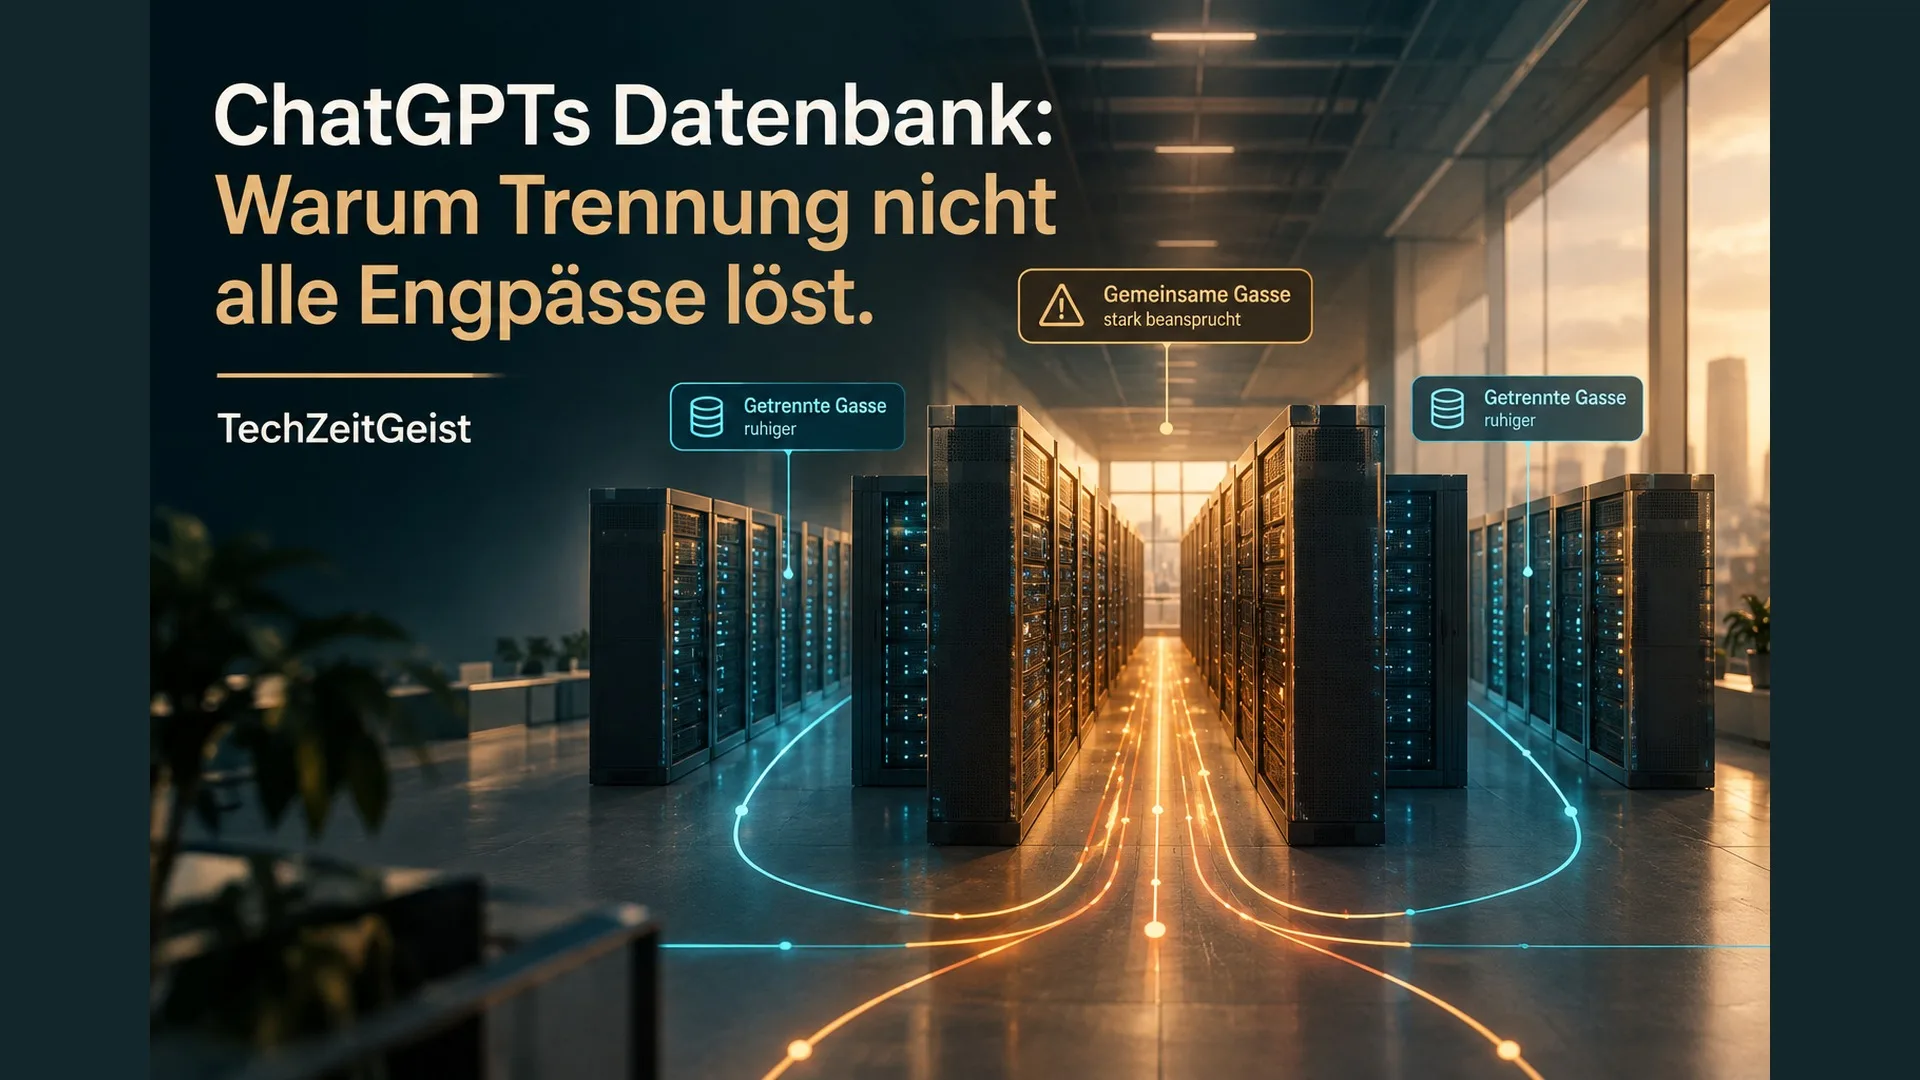
Eine Anmeldung kann an einer Funktion scheitern, die man selbst gar nicht benutzt. Wenn beide auf dieselbe knappe Datenbankkapazität zugreifen, reicht die Last des Nachbarn für einen gemeinsamen Engpass. Genau solche Störungen beschreibt OpenAI in einem neuen Bericht über seine Speicherplattform Habitat. Der zunächst naheliegende Ausweg, wichtige Dienste stärker zu trennen, brachte allerdings eigene Probleme mit sich.
Die interessante Frage lautet deshalb: Wie viel Gemeinsamkeit verträgt eine Datenbank? Eine gute Antwort muss zwei Dinge zusammenbringen. Sie soll verhindern, dass eine große Hintergrundaufgabe den Zugang zum Produkt beeinträchtigt. Gleichzeitig soll freie Kapazität dort helfen können, wo gerade mehr Arbeit anfällt. Zwischen diesen Zielen verläuft die eigentliche Architekturentscheidung.
Warum der Nachbar beim Anmelden mit am Tisch sitzt
OpenAI schildert im Engineering-Bericht vom 23. Oktober 2026 einen Weg durch drei Betriebsmodelle: zunächst gemeinsam genutzte Container in Azure Cosmos DB, danach mehr getrennte Container und schließlich wieder gemeinsame Nutzung als Standard, ergänzt um Schutzmechanismen. In der frühen Variante konnten weniger zentrale Produktfunktionen Anmeldungen und Registrierungen stören. Die Trennung begrenzte solche Folgen, machte aber die Planung für neue Produktstarts aufwendiger. Das ist ein Rückblick auf den Umbau der Infrastruktur.
Das allgemeine Problem heißt „Noisy Neighbor“, also lauter Nachbar. Dabei teilen mehrere Nutzer oder Dienste Betriebsmittel, etwa Rechenzeit oder Datenbankdurchsatz. Ihre gespeicherten Inhalte können sauber getrennt sein, während ihre Anfragen um dieselbe Leistung konkurrieren. Außerdem braucht es keinen einzelnen extremen Verbraucher: Viele mäßig aktive Nachbarn können gemeinsam dieselbe Grenze erreichen. Entscheidend ist, wann ihre Arbeit zusammenkommt.
Anschaulich ist das ein Gebäude mit getrennten Wohnungen und einem gemeinsamen Aufzug. Die Wohnungsschlüssel regeln den Zutritt. Der Umzug im fünften Stock bestimmt trotzdem mit, wie lange andere Bewohner auf den Aufzug warten. Für die Fehlersuche sind das zwei verschiedene Fragen: Wer darf an welche Daten, und wer bekommt wann wie viel Rechenleistung?
Freier Platz ist noch keine freie Leistung
Bei Cosmos DB gibt es dafür eine wichtige Unterscheidung. Daten mit demselben Partitionsschlüssel bilden eine logische Partition. Mehrere solcher Gruppen können auf einer physischen Partition liegen, auf der die Leistung bereitgestellt wird. Die Microsoft-Dokumentation zur Partitionierung beschreibt außerdem: Im herkömmlichen Modell mit provisioniertem Durchsatz wird das Leistungsbudget gleichmäßig auf die physischen Partitionen verteilt.
Damit wird die örtliche Verteilung der Arbeit wichtig. Ein vereinfachtes, fiktives Rechenbeispiel: Ein Container bekommt 12.000 Leistungseinheiten pro Sekunde. Bei zwei physischen Partitionen entfallen rechnerisch 6.000 auf jede. Wächst der Datenbestand so weit, dass es vier Partitionen werden, bleiben bei unverändertem Gesamtbudget 3.000 je Partition. Eine dort konzentrierte Last von 4.000 passt nun nicht mehr in den Anteil. Andere Partitionen können gleichzeitig freie Reserven haben.
Die Rechnung veranschaulicht den Effekt, sie bildet keinen konkreten ChatGPT-Vorfall ab. Vor allem sagt „mehr Speicher“ hier etwas anderes als „mehr Durchsatz“. Die Verteilung der Daten und die Verteilung der Anfragen müssen gemeinsam betrachtet werden.
Diese Leistungseinheiten heißen Request Units, kurz RU. Microsoft fasst darin den Aufwand für Prozessor, Ein- und Ausgabe sowie Arbeitsspeicher zusammen. Ein gezielter kleiner Lesezugriff kostet anders als eine aufwendige Suche. RU pro Sekunde lassen sich daher nicht einfach als Zahl von Nutzeranfragen lesen. Zwei Dienste mit derselben Anfragenzahl können die Datenbank sehr unterschiedlich beanspruchen. Wer nur Anfragen zählt, übersieht womöglich den teureren Nachbarn.
Eigene Räume begrenzen den Schaden
Eine stärkere Trennung schafft Grenzen für solche Störungen. Das allgemeine Bulkhead-Prinzip verwendet dafür das Bild von Schotten in einem Schiff: Wird ein Abteil beschädigt, soll das Wasser nicht alle anderen erreichen. In Software können getrennte Ressourcenpools verhindern, dass ein überlasteter Dienst auch die Arbeitsmittel anderer Dienste vollständig belegt.
Die Grenze muss allerdings am tatsächlichen Engpass liegen. Zwei getrennte Warteschlangen helfen wenig, wenn dahinter derselbe erschöpfte Ressourcenpool wartet. Umgekehrt kann schon eine gezielte Trennung an einer besonders empfindlichen Stelle nützlich sein, ohne jeden Bestandteil des Systems zu duplizieren. Architektur besteht hier auch darin, den möglichen Ausbreitungsweg einer Störung zu verstehen.
Der Gegenbefund kommt aus dem Betrieb: Eine isolierte Umgebung besitzt zunächst nur ihre eigene Reserve. Ein Produktstart kann dort einen sehr großen Sprung gegenüber der Testlast verursachen. OpenAI berichtet, dass Teams für neue Funktionen Kapazität vorab bereitstellen mussten und dies teilweise versäumten. Die stärkere Isolation verlagerte damit einen Teil des Zuverlässigkeitsproblems in die Zusammenarbeit und Planung der Teams.
Auch Microsofts Architekturleitfaden für gemeinsame Datenhaltung beschreibt den grundsätzlichen Tausch: Gemeinsame Ressourcen können Kosten und Verwaltungsaufwand senken. Dedizierte Datenressourcen bieten mehr Trennung, erzeugen aber zusätzlichen Betriebsbedarf. Welche Variante passt, hängt auch von unterschiedlichen Anforderungen an Wiederherstellung, Verfügbarkeit oder Speicherort ab. Eine einzige Antwort für alle Dienste wäre bequem, würde diese Unterschiede aber übergehen.
Ein zweites Gedankenexperiment macht den Unterschied sichtbar. Drei erfundene Dienste benötigen gerade 20, 20 und 60 Einheiten Leistung. Zusammen sind das 100. Ein gemeinsamer Vorrat von 120 Einheiten könnte diese Last aufnehmen. Werden stattdessen drei unveränderliche Vorräte von jeweils 40 eingerichtet, kommt der dritte Dienst an seine Grenze, während die beiden anderen je 20 übrig haben. Das gesamte bereitgestellte Budget ist in beiden Fällen gleich groß.
Das Beispiel setzt voraus, dass der gemeinsame Vorrat tatsächlich von allen drei Diensten nutzbar ist und keine weitere lokale Grenze greift. Es zeigt den Vorteil beweglicher Reserve. Die Kehrseite erscheint sofort, wenn einer der Dienste ungebremst sehr viel mehr verlangt: Dann braucht auch der gemeinsame Vorrat eine Regel, die andere schützt. Trennung beantwortet die Frage, wo eine Grenze verläuft. Gemeinsame Nutzung beantwortet die Frage, wer freie Leistung ausleihen darf. Eine belastbare Lösung muss beides festlegen.
Wer warten darf, braucht weniger eigene Reserve
Zwischen vollständiger Teilung und vollständiger Trennung liegt eine weitere Möglichkeit: Das System unterscheidet dringende von verschiebbarer Arbeit. Eine Anmeldung braucht rasch eine Antwort. Ein großer Datenexport lässt sich eher zurückstellen. Bei Cosmos DB kann prioritätsbasierte Ausführung unter hoher Last zunächst Anfragen niedriger Priorität drosseln. Microsoft beschreibt dies als Best-Effort-Verfahren ohne eigene Leistungsgarantie. Die Priorität hilft bei der Verteilung vorhandener Kapazität; sie vergrößert diese nicht.
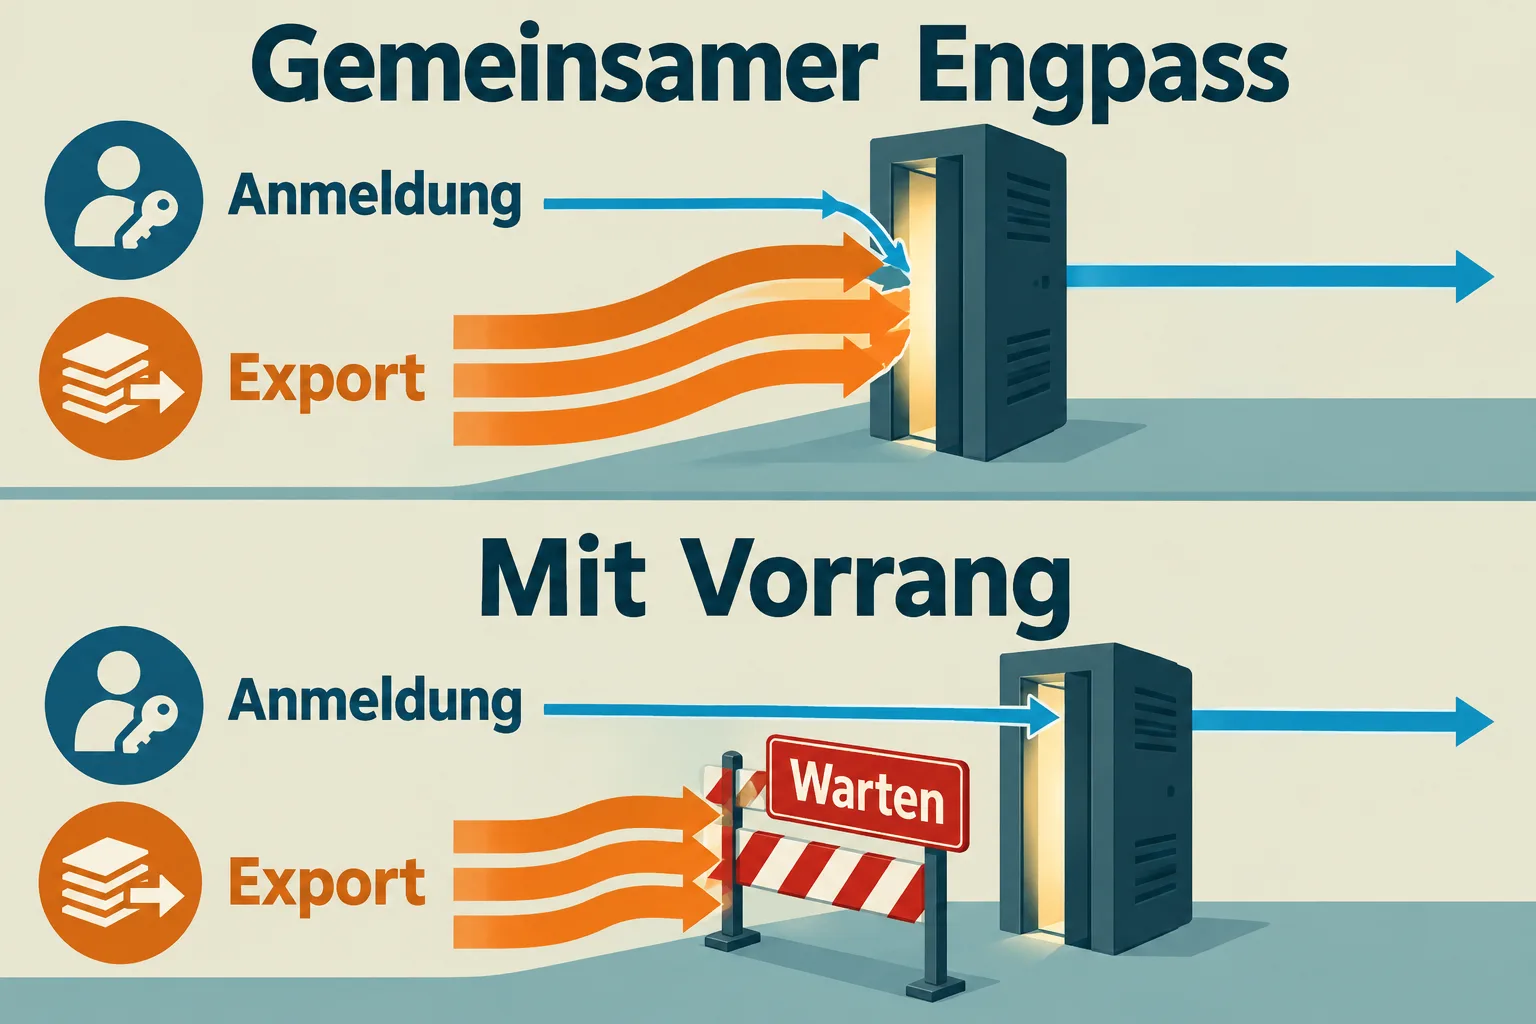
Das allgemeinere Drosselungsprinzip begrenzt den Ressourcenverbrauch, bevor Überlast das gesamte System beeinträchtigt. Mehr Kapazität bereitzustellen kostet Zeit und Geld. Zurückstellen oder zeitweise Einschränken weniger wichtiger Arbeit kann diese Zeit überbrücken. Die Warteschlange verschiebt dabei die Arbeit in die Zukunft. Kommt dauerhaft mehr hinein, als abgearbeitet werden kann, bleibt der Engpass bestehen.
Daraus ergibt sich eine praktische Reihenfolge für die Analyse: Zuerst den tatsächlichen gemeinsamen Engpass finden, dann die schützenswerte Arbeit bestimmen und schließlich entscheiden, wo eine feste Grenze oder ein Vorrang sinnvoll ist. Die Zahl der Datenbanken allein sagt wenig darüber aus, wie zuverlässig sich das Produkt anfühlt. Entscheidend ist, welche Arbeit im entscheidenden Moment warten muss.
Quellen
- Jon Lee, Hrachya Hakobyan und Chaomin Yu, OpenAI: Rapidly scaling online storage to serve over 1 billion ChatGPT users (Part II), 23. Oktober 2026.
- Microsoft Learn: Partitioning and horizontal scaling in Azure Cosmos DB; Request Units in Azure Cosmos DB; Priority-based execution. Abgerufen am 24. Oktober 2026.
- Microsoft Azure Architecture Center: Noisy Neighbor antipattern; Bulkhead pattern; Throttling pattern; Architectural approaches for storage and data in multitenant solutions. Abgerufen am 24. Oktober 2026.
Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft.