Ein 3D-Generator liefert brauchbare Formen, scheitert aber immer wieder am selben Detail? Dann kann eine gezielte Anpassung sinnvoll sein. Mit LoRA trainieren Sie kleine Zusatzbausteine für ein bestehendes Modell, statt sämtliche Modellgewichte neu zu lernen. Voraussetzung sind passende 3D-Beispiele, genügend Rechenleistung und ein Test mit Objekten, die das Training nicht gesehen hat.
Der Aufwand lohnt sich vor allem, wenn viele ähnliche Objekte gebraucht werden und der Fehler regelmäßig auftritt. Für ein einzelnes Modell kann es schneller sein, die Geometrie von Hand zu korrigieren. Der folgende Ablauf nutzt TRELLIS.2 als Beispiel: Eine Anleitung von Hugging Face zeigt, wie sich der Generator auf Schuhe spezialisiert. Die Schritte sind eine Orientierung für eigene Experimente, kein allgemeines Rezept für jedes 3D-Modell.
Erst das Problem eingrenzen
Beginnen Sie mit einigen Ergebnissen des unveränderten Modells. Welches Detail ist tatsächlich falsch: die grobe Form, eine Vertiefung oder die Oberfläche? Halten Sie Eingabebilder und Ergebnisse fest. So lässt sich später beurteilen, ob das Training den betreffenden Fehler verbessert und nicht bloß anders aussehende Objekte erzeugt.
Im Beispiel wirkten generierte Schuhe zunächst plausibel, ihre Sohlen entsprachen aber nicht immer der Vorlage. Das Team nahm daher die Geometrie ins Visier. TRELLIS.2 verarbeitet ein Eingabebild in mehreren Schritten: Es leitet eine grobe Struktur ab, ergänzt die detaillierte Form und erzeugt anschließend Material und Oberfläche. Am Ende steht ein texturiertes 3D-Netz, ein sogenanntes Mesh.
Ein Mesh beschreibt ein Objekt über Punkte und verbundene Flächen. Wenn vor allem die Form ungenau ist, muss nicht automatisch auch die Oberflächenstufe verändert werden. Genau diese Entscheidung prägt den Aufwand und die Daten, die Sie benötigen.
Was LoRA verändert
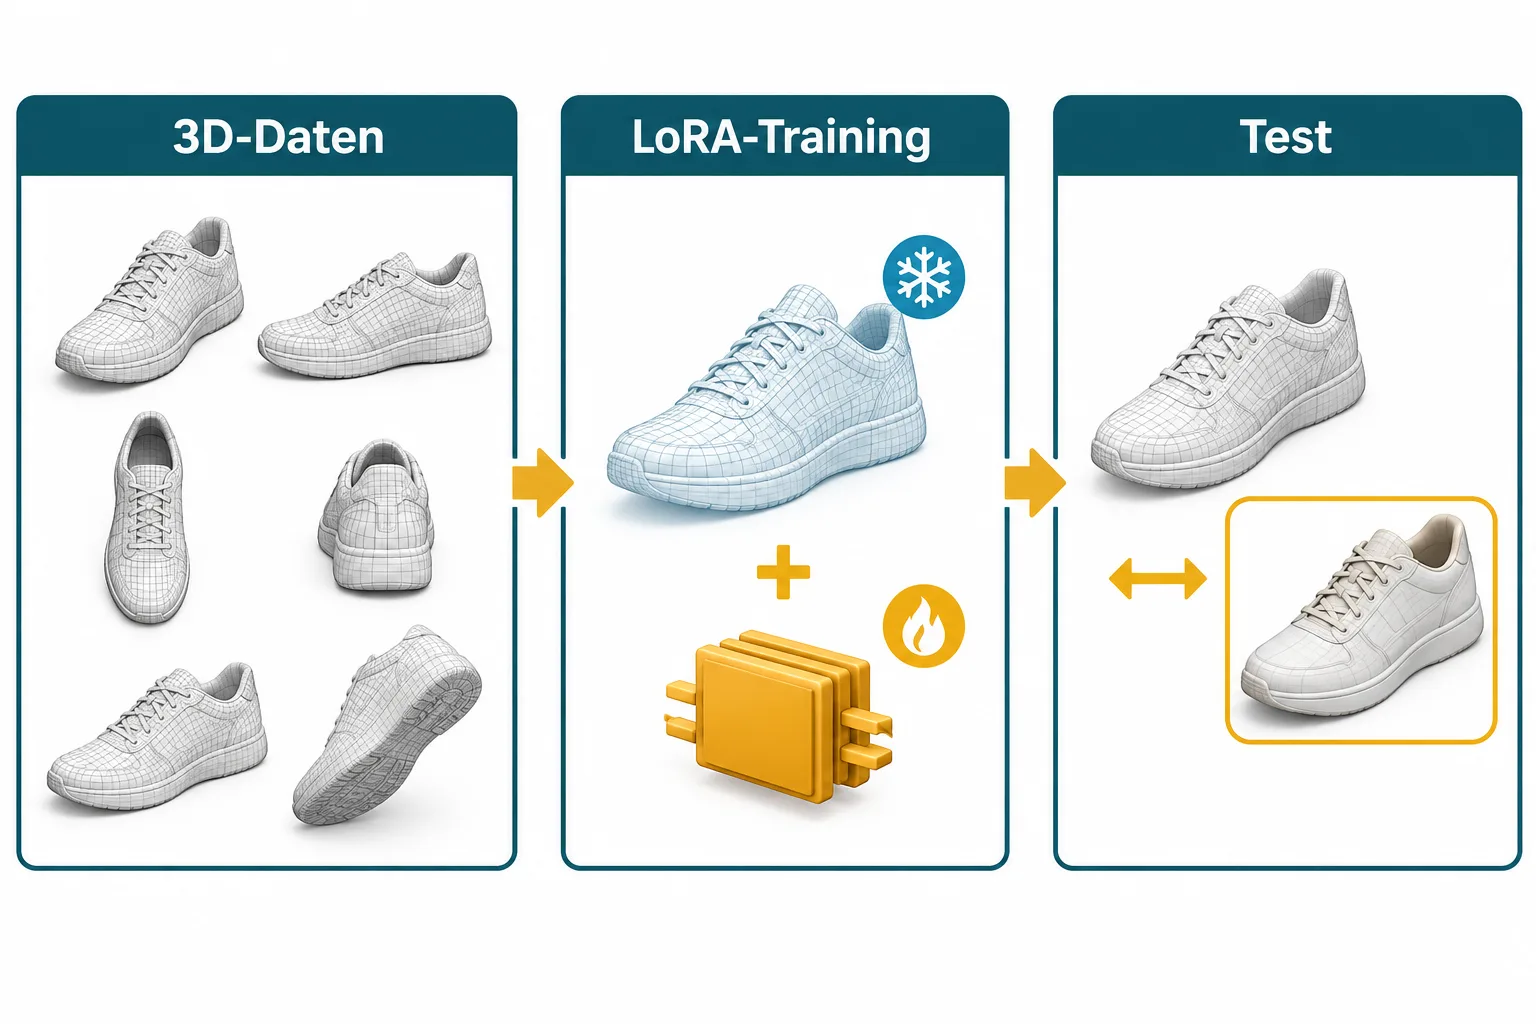
LoRA steht für Low-Rank Adaptation. Vereinfacht kommen kleine trainierbare Matrizen zu Teilen des Modells hinzu; die ursprünglichen Gewichte bleiben eingefroren. Das Training verändert also die Zusatzbausteine, während das Basismodell erhalten bleibt. Die ursprüngliche LoRA-Arbeit beschreibt das Verfahren für Sprachmodelle; das Prinzip lässt sich auch in anderen passenden Architekturen einsetzen.
Weniger trainierbare Parameter bedeuten allerdings nicht, dass ein großer 3D-Generator auf jeder Grafikkarte trainierbar wird. Das Basismodell und weitere Verarbeitungsschritte brauchen ebenfalls Speicher und Rechenzeit. Prüfen Sie daher zuerst die Anforderungen des konkreten Projekts und vergleichen Sie sie mit Ihrer eigenen Hardware oder einem Cloud-Angebot.
Geeignete Beispiele vorbereiten
Für die Anleitung verwendete das Team 188 Schuhobjekte aus Google Scanned Objects. Davon blieben neun für die Auswertung zurück; mit 179 wurde trainiert. Pro Objekt erzeugte die Vorbereitung 16 Ansichten. Diese Bilder dienen als Eingaben, während die zugehörige 3D-Form das Lernziel liefert. Das Zurückhalten ganzer Objekte ist wichtig: Ein Test mit lediglich einer anderen Ansicht desselben Trainingsobjekts beantwortet eine andere Frage.
Für eigene Daten suchen Sie entsprechend eine zusammenhängende Objektklasse und achten darauf, dass die Beispiele zum gewünschten Ergebnis passen. Dokumentieren Sie, welche Dateien im Training und welche im Test liegen. Klären Sie vor einem Upload die Nutzungsrechte und ob die Daten in die gewählte Umgebung dürfen. Ein privates Repository kann die Sichtbarkeit begrenzen; die Verantwortung für die Daten bleibt bei Ihnen.
Die Anleitung setzt für eigene Datensätze Meshes im Hugging Face Hub voraus. Für den beschriebenen Ablauf werden außerdem ein Konto, ein Zugriffstoken und Zugang zum Bildmodell DINOv3 benötigt. Das Token gehört in die vorgesehene Geheimnisverwaltung, nicht in veröffentlichte Befehle oder Dateien.
Struktur und Form getrennt trainieren
Im Schuhversuch trainierte das Team zwei Adapter: einen für die grobe Struktur und einen für die detaillierte Geometrie. Die Materialstufe blieb unverändert. Der Grund lag auch in den Daten: Die vorhandenen Farbkarten enthielten bereits Beleuchtung und waren keine getrennten Materialkarten für das Texturtraining. Wer mit solchen Bildern dennoch die Materialstufe trainiert, könnte Beleuchtung mit Oberflächeneigenschaften vermischen.
Hugging Face stellt dafür getrennte Container für Vorbereitung und Training bereit. Die dokumentierten Wege laufen über Hugging Face Jobs oder lokal mit Docker und geeigneter GPU. Zuerst werden Meshes und Ansichten vorbereitet und in die internen Trainingsdaten umgewandelt. Danach starten separate Trainingsläufe für Struktur und Form. Gespeicherte Zwischenstände ermöglichen es, den Verlauf zu verfolgen und einen geeigneten Stand später zu vergleichen.
Planen Sie vor dem Start ein Budget und kontrollieren Sie die aktuellen Preise des gewählten Dienstes. Im veröffentlichten Beispiel dauerte die Vorbereitung für 188 Objekte rund eine Stunde auf einer A100 mit 80 Gigabyte Speicher. Die beiden Trainingsläufe benötigten auf dieser Hardware laut den Autoren 7,2 und 3,6 Stunden. Diese Werte beschreiben das Experiment; eigene Daten, Einstellungen und Hardware können andere Laufzeiten ergeben. Ein Preis lässt sich daraus ohne den jeweils gültigen Tarif nicht seriös ableiten.
Ergebnisse vergleichen, nicht nur Verluste
Eine sinkende Trainingskennzahl zeigt zunächst, wie sich das Trainingsziel entwickelt. Sie sagt nicht allein, ob die ausgegebene Form für Ihren Zweck besser ist. Vergleichen Sie daher dieselben zurückgehaltenen Eingaben mit und ohne Adapter. Drehen Sie die Ergebnisse und prüfen Sie gerade die Details, die den Anstoß für das Training gegeben haben. Bei Bedarf können geometrische Kennzahlen den Sichtvergleich ergänzen.
Im veröffentlichten Schuhversuch lag der durchschnittliche F-Score für die neun Testobjekte beim Basismodell bei 0,276 und mit beiden Adaptern bei 0,803. Die Kennzahl verbindet, vereinfacht gesagt, die Nähe der erzeugten Oberfläche zur Referenz mit deren Abdeckung. In diesem kleinen Versuch schnitt die angepasste Version bei allen neun Schuhen besser ab. Daraus folgt noch keine entsprechende Verbesserung für Möbel, Fahrzeuge oder andere Datensätze.
Prüfen Sie außerdem, ob die Anpassung andere Fähigkeiten verschlechtert. Ein spezialisiertes Modell kann für die gewählte Objektklasse nützlich sein, während das Basismodell für andere Motive besser passt. Bewahren Sie deshalb Basismodell, Adapter und Testbeispiele getrennt auf. So können Sie bei einer neuen Aufgabe den passenden Stand auswählen und den Vergleich wiederholen.
Wann die Alternative einfacher ist
Wenn nur wenige einzelne Objekte korrigiert werden müssen, bietet die manuelle Bearbeitung einen direkten Weg: Sie ändern die betroffene Stelle und prüfen das Ergebnis. Ein LoRA ist eher ein wiederverwendbares Werkzeug für wiederkehrende Aufgaben. Es verlangt zusätzliche Vorbereitung und liefert trotzdem generierte Geometrie, die für den vorgesehenen Einsatz geprüft werden muss.
Die Entscheidung beginnt deshalb nicht beim Trainingsbefehl, sondern bei einem messbaren Fehler und einem passenden Datensatz. Erst wenn ein Vergleich mit zurückgehaltenen Beispielen zeigt, dass der Adapter für Ihre Aufgabe hilft, ist der zusätzliche Aufwand nachvollziehbar begründet.
Quellen
- Hugging Face: The Definitive Fine-Tuning Guide for 3D Generation Models, 12. November 2026.
- Hu und weitere: LoRA: Low-Rank Adaptation of Large Language Models, 2021.
- Microsoft: TRELLIS.2 Repository.
Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft.