Zwei Rechner haben zusammen mehr Speicher und Rechenleistung als einer. Trotzdem muss eine KI-Antwort auf dem Verbund nicht doppelt so schnell erscheinen. Sobald beide Geräte an derselben Berechnung arbeiten, müssen sie sich abstimmen und Zwischenergebnisse austauschen. Der zusätzliche Rechner kann ein größeres Modell ermöglichen oder mehr Anfragen bewältigen. Das ist ein anderer Gewinn als eine halbierte Wartezeit. Wer die Ziele trennt, versteht Leistungsangaben für kleine KI-Verbünde deutlich besser.
NVIDIA hat am 2. Oktober neben einer DGX-Spark-Variante mit 64 Gigabyte Speicher auch DGX Spark Sync vorgestellt. Die beschriebene Verbindung zweier Systeme mit jeweils 128 Gigabyte nutzt 200-Gigabit-Ethernet. Für eine bestimmte Testkonfiguration nennt das Unternehmen eine 1,7-fache Beschleunigung. Dieser Herstellerwert zeigt ein konkretes Ergebnis, keine allgemeine Skalierungsregel für beliebige Modelle und Aufgaben. NVIDIA
Der interessante technische Punkt liegt zwischen den Geräten. Ein Kabel verbindet zwei Computer, macht aus ihnen aber noch keinen einzigen Rechner mit gleich schnell erreichbarem Speicher. Die Software muss die Arbeit passend aufteilen. Der gewonnene Spielraum und die dafür nötige Kommunikation bestimmen gemeinsam, wie sich der Verbund anfühlt.
Ein größeres Modell ist zunächst ein Kapazitätsgewinn
Stellen wir uns ein Modell vor, dessen benötigte Daten nicht in den verfügbaren Speicher eines einzelnen Geräts passen. Eine unterstützte Verteilung kann diese Grenze verschieben: Teile liegen und rechnen auf verschiedenen Geräten. Damit wird eine Aufgabe überhaupt ausführbar, die zuvor nicht in dieser Form möglich war. Die erste Verbesserung lautet dann „passt“, nicht „antwortet schneller“.
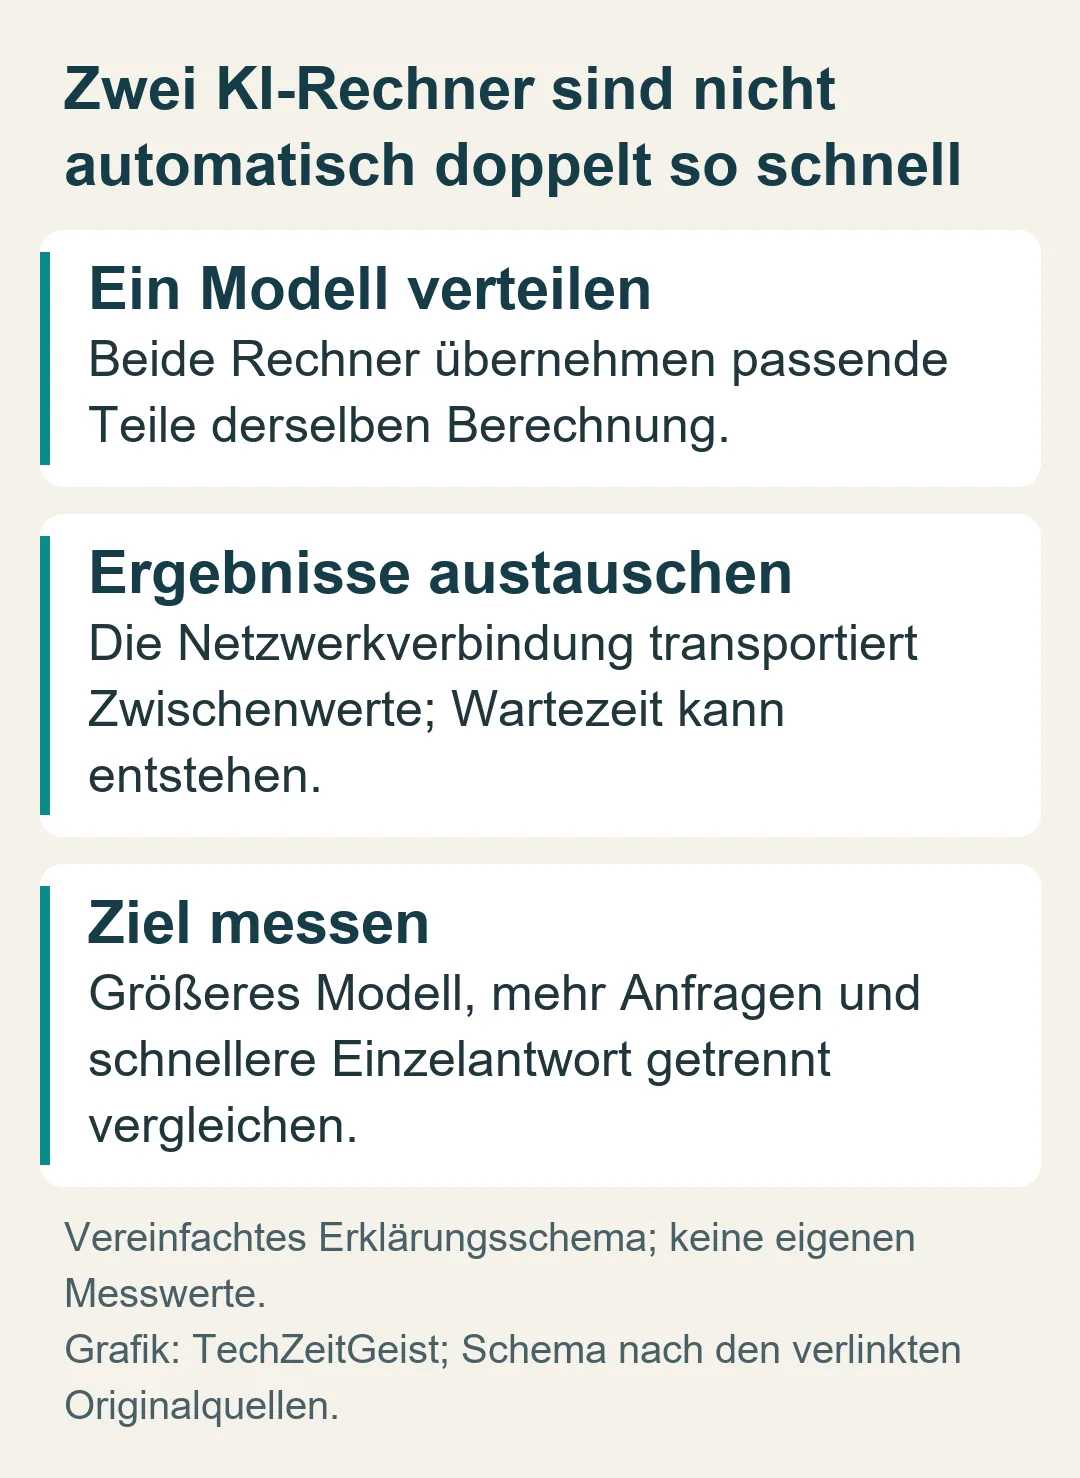
Die Dokumentation von Hugging Face beschreibt Tensorparallelismus als Aufteilung einer Modellschicht auf mehrere Beschleuniger. Sie können gleichzeitig an Teilberechnungen arbeiten, müssen ihre Ergebnisse aber austauschen. Das Modell und die Software brauchen dafür einen passenden Verteilungsplan. Die Dokumentation betont insbesondere schnelle Kommunikation innerhalb eines Rechnerverbunds; sie ist keine Leistungszusage für die konkrete Spark-Verbindung über zwei Geräte. Hugging Face
Auch zusammengezählter Speicher ist keine vollständig nutzbare Modellgröße. Die Laufzeit benötigt weitere Daten und Arbeitsbereiche. Bei vielen Sprachmodellen kommen Zwischenergebnisse für den bisherigen Kontext hinzu. Ein Teil des Speichers kann also für die Ausführung gebraucht werden, während ein anderer Teil die Gewichte trägt. Wie genau das aufgeteilt wird, hängt von der gewählten Umsetzung ab.
Gemeinsames Rechnen verlangt gemeinsame Ergebnisse
Eine vereinfachte Analogie hilft: Zwei Menschen addieren verschiedene Teile einer langen Zahlenliste. Die Teilaufgabe erledigen sie parallel. Für das Gesamtergebnis müssen ihre Summen anschließend zusammengeführt werden. Wenn der Weg zum Austausch viel Zeit kostet, fällt der Zeitgewinn kleiner aus als die Verdopplung der Helfer vermuten lässt.
In verteilter KI gibt es dafür festgelegte Kommunikationsoperationen. NVIDIA beschreibt beispielsweise AllReduce: Werte der beteiligten Geräte werden kombiniert, und jedes erhält das Gesamtergebnis. Andere Operationen verteilen Daten oder sammeln Teilstücke. Welche benötigt werden, folgt aus der Aufteilung der Berechnung. NVIDIA NCCL
Damit hängt die Ausführung nicht nur an den Rechenwerken. Relevant sind auch die Menge ausgetauschter Daten und der Zeitpunkt, zu dem ein Gerät auf ein Ergebnis des anderen warten muss. Eine hohe nominelle Netzwerkgeschwindigkeit beseitigt diese Abhängigkeit nicht. Sie kann den Austausch beschleunigen, aber nicht automatisch jeden gemeinsamen Schritt entfallen lassen.
Der Hersteller nennt für Sync eine schnelle direkte Verbindung. Um ihren praktischen Vorteil beurteilen zu können, braucht man trotzdem die genaue Aufgabe. Ein Test mit großen gemeinsam bearbeiteten Daten kann anders ausfallen als ein kurzer Dialog, dessen einzelne Ausgabeschritte wenig parallele Arbeit bieten. Aus einem einzigen Verhältnis entsteht deshalb keine universelle Tabelle „ein Gerät gegen zwei Geräte“.
Einfache Zeitrechnung zeigt die Grenze
Ein bewusst erfundenes Rechenbeispiel macht das sichtbar. Nehmen wir eine Aufgabe, die auf einem Gerät zehn Zeiteinheiten benötigt. Acht davon lassen sich ideal auf zwei Geräte verteilen, zwei bleiben unverändert. Die reine Bearbeitung würde dann vier plus zwei, also sechs Zeiteinheiten dauern. Kommt eine weitere Einheit für Abstimmung hinzu, sind es sieben. Das Ergebnis wäre schneller, aber nicht doppelt so schnell.
Das Beispiel ist kein Benchmark und beschreibt auch nicht die internen Abläufe von Spark Sync. Es isoliert lediglich die Logik: Nur teilbare Arbeit profitiert unmittelbar von zusätzlicher paralleler Hardware. Unveränderte Arbeit und Kommunikation bleiben im Gesamtbudget. Je nach Aufgabe können diese Anteile ganz verschieden sein.
Auch der Vergleichspunkt zählt. Ein großes Modell, das vorher teilweise auf langsamere Ausweichwege angewiesen war, kann durch zusätzliche Kapazität stark profitieren. Ein kleineres Modell, das bereits bequem auf einem Gerät läuft, hat andere Voraussetzungen. Beide Messungen können korrekt sein und dennoch sehr unterschiedliche Beschleunigungen zeigen. Ohne die Ausgangsbedingungen ist die Verhältniszahl schwer zu interpretieren.
Noch ein Vergleich hilft beim Lesen von Leistungszahlen: Zwei Versuche können denselben Ausgabedurchsatz erreichen und sich für den Nutzer trotzdem anders anfühlen. Im einen beginnt die Antwort früh und erscheint anschließend langsam. Im anderen dauert die Vorbereitung länger, danach folgt die Ausgabe zügig. Der Gesamtwert allein macht diesen Unterschied unsichtbar.
Für einen Dialog zählt deshalb auch der Beginn der Antwort. Bei einer umfangreichen Stapelaufgabe kann dagegen die Zeit bis zum Abschluss aller Ergebnisse wichtiger sein. Das sind unterschiedliche Nutzungssituationen, keine Widersprüche in der Messung. Ein brauchbarer Bericht nennt, welcher davon sein Wert beschreibt. So lässt sich zusätzliche Hardware mit einem konkreten Arbeitsziel verbinden statt mit einer abstrakten Erwartung an das doppelte Gerät.
Mehr Anfragen und schnellerer Dialog sind verschiedene Ziele
Ein Team könnte zwei Rechner auch für getrennte Aufgaben nutzen. Dann muss nicht jede einzelne Antwort gemeinsam berechnet werden. Der zweite Rechner kann zusätzlichen Nutzern oder unabhängigen Aufgaben dienen. Ein größerer Gesamtdurchsatz ist für den Betrieb wertvoll, selbst wenn sich die Antwortzeit eines einzelnen Gesprächs kaum verändert. Dieses allgemeine Organisationsbeispiel ist keine Zusage einer bestimmten Sync-Betriebsart.
Bei einem gemeinsamen Modell kann außerdem die Länge des Kontexts den Speicherbedarf verändern. Die Transformers-Dokumentation erklärt, dass ein dynamischer KV-Cache während der Verarbeitung wächst. Speicherarme Varianten tauschen unter anderem Kapazitätsbedarf gegen zusätzliche Arbeit oder Datentransport. Deshalb gehören Eingabelänge und Laufzeitkonfiguration in einen brauchbaren Leistungsvergleich. Hugging Face
Ein kurzer Testprompt und die Auswertung eines langen Dokuments stellen verschiedene Anforderungen. Dasselbe Modell kann in beiden Fällen starten, aber unterschiedlich viel Reserve und unterschiedlich lange Bearbeitung benötigen. Die Angabe der Modellgröße allein verrät daher weder den vollständigen Speicherbedarf noch die Wartezeit im eigenen Arbeitsablauf.
Die Gegenposition bleibt berechtigt: Manche Aufgaben lassen sich sehr gut verteilen, und zusätzliche Hardware kann deutlich helfen. Der Kommunikationsaufwand ist kein Argument gegen einen Verbund. Er ist ein Argument dafür, den Gewinn passend zu messen. Wer nur auf das theoretische Doppel schaut, könnte eine nützliche Erweiterung unterschätzen oder eine unpassende Anschaffung überschätzen.
Ein aussagekräftiger Vergleich hält deshalb Modell, Datenformat, Eingabelänge und Zahl gleichzeitiger Anfragen fest. Danach werden mindestens drei Fragen getrennt beantwortet: Welche Aufgabe passt in den Speicher? Wie lange wartet ein einzelner Nutzer? Wie viel Arbeit erledigt das System insgesamt? Erst zusammen erklären diese Größen, was der zweite Rechner bringt. Das Kabel ist die Voraussetzung für Zusammenarbeit; die passende Aufgabenverteilung entscheidet über ihren Nutzen.
Quellen
- NVIDIA: Local AI: DGX Spark 64GB and NVIDIA DGX Spark Sync (2026-10-02)
- Hugging Face: Tensor parallelism for inference
- NVIDIA NCCL: Collective Operations
- Hugging Face: KV cache strategies, version4.50.0
Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft.