OpenAI führt ein unsichtbares Wasserzeichen für bestimmte Textausgaben ein. API-Kunden können es seit dem 5. Oktober für ausgewählte Modelle einschalten; dort bleibt es standardmäßig deaktiviert. In der Europäischen Union soll es in den kommenden Wochen geeigneten Textausgaben von ChatGPT und Codex hinzugefügt werden. Für Leser ist eine zweite Entscheidung ebenso wichtig: Der zugehörige Detektor wird zum Start nicht allgemein öffentlich angeboten. OpenAI
OpenAI begründet das gestufte Vorgehen mit europäischen Vorgaben zur Herkunftskennzeichnung und mit den Grenzen der Technik. Zunächst können sich Forscher und Fachorganisationen für den Detektorzugang bewerben. Der angekündigte Start betrifft damit die Erzeugung eines Signals und einen begrenzten Prüfkreis. Er bedeutet nicht, dass schon jeder beliebige Absatz auf einer öffentlichen Prüfseite untersucht werden kann.
Ein Muster in der Wortwahl
Das Verfahren heißt textGrain. Es setzt nach Darstellung des Unternehmens ein statistisches Signal in die Wortwahl des Modells. Anders als ein sichtbarer Aufdruck soll das Wasserzeichen beim gewöhnlichen Lesen nicht auffallen. Der Detektor sucht anschließend nach dem passenden Muster in einem Textabschnitt. OpenAI
Das unterscheidet den Ansatz von einem Etikett neben einem Artikel. Ein sichtbarer Hinweis kann vom Herausgeber angebracht und beim Kopieren weggelassen werden. Ein statistisches Muster steckt dagegen im erzeugten Text selbst. Es lässt sich allerdings ebenfalls verändern: Wenn jemand Sätze umformuliert oder einen Text übersetzt, bleibt die ursprüngliche Wortwahl nicht vollständig erhalten.
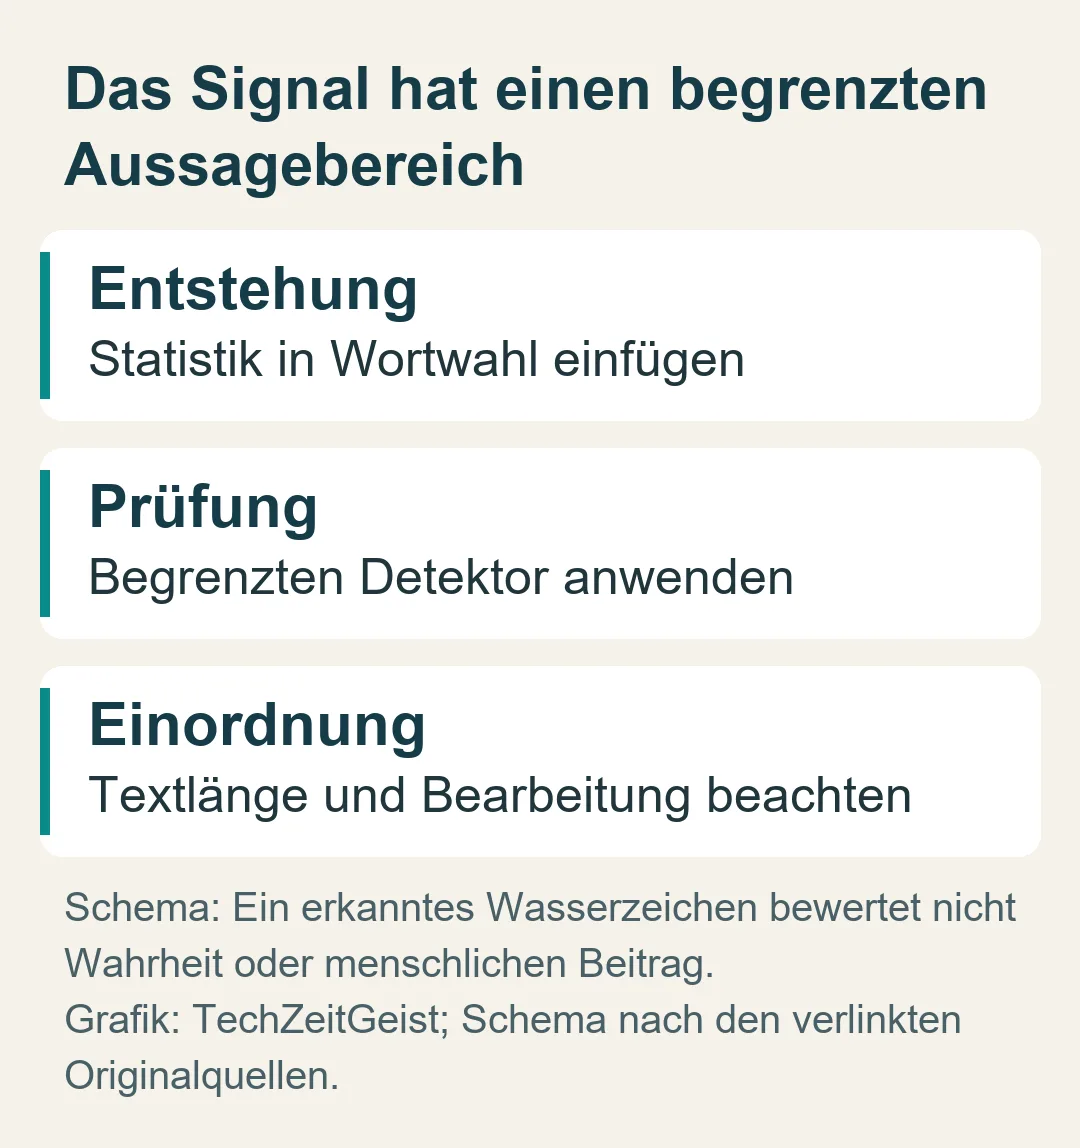
Die technische Frage ist daher nicht nur, ob ein Signal eingefügt werden kann. Es geht auch darum, welche Spuren nach einem realen Arbeitsablauf übrig bleiben. Eine lange ursprüngliche Antwort, ein kurzer Auszug und eine stark überarbeitete Fassung sind unterschiedliche Prüfsituationen. Ein Dienst, der sie alle mit derselben Sicherheit bewertet, müsste diese Sicherheit für jede Situation belegen.
Ein Fund beantwortet eine begrenzte Frage
OpenAI weist auf mögliche Fehlalarme und übersehene Wasserzeichen hin. Kurze Texte und stark eingeschränkte Formulierungen sind schwieriger zu prüfen; Bearbeitung kann die Erkennung schwächen. Die veröffentlichten Auswertungen stammen vom Anbieter. Teile der dargestellten Tests beziehen sich auf englische Antworten, weshalb ihre Ergebnisse nicht ohne Weiteres als Messwert für jeden deutschen Text gelten. OpenAI
Für den Umgang mit einem späteren Befund ist der Unterschied zwischen Signal und Bewertung entscheidend. Ein erkanntes Muster betrifft die mögliche Beteiligung eines bestimmten Systems. Ob ein Text sorgfältig recherchiert ist, ob Menschen seine Argumentation verändert haben oder ob seine Aussagen stimmen, muss anhand des Inhalts untersucht werden. Diese Fragen entstehen auch bei einem Text ohne erkanntes Muster.
Ein Beispiel macht den Unterschied greifbar: Eine Person kann einen automatisch erzeugten Absatz fachlich korrigieren und in einen eigenen Bericht einbauen. Ein anderes Dokument kann völlig ungeprüft übernommen sein. Wenn beide ein Signal enthalten, sagt das Signal allein nichts über die Qualität der redaktionellen Arbeit. Dafür wären Quellen, nachvollziehbare Prüfungen und die tatsächlich vertretenen Aussagen relevant.
Was sich für Nutzer zuerst ändert
Für API-Anwendungen liegt die erste konkrete Entscheidung bei der Aktivierung des angekündigten Verfahrens. In EU-Versionen von ChatGPT und Codex ist dagegen ein schrittweiser Rollout vorgesehen. Welche Ausgaben geeignet sind und welche Modelle unterstützt werden, gehört zur jeweiligen Umsetzung. Die Ankündigung rechtfertigt kein Versprechen, alle alten und neuen Texte seien künftig gleichermaßen identifizierbar.
Für Schulen, Redaktionen oder Unternehmen ergibt sich daraus vor allem eine methodische Aufgabe: Ein mögliches Prüfwerkzeug sollte nicht als automatische Entscheidung über Personen oder Urheberschaft eingesetzt werden. Wer einen Text beurteilen muss, braucht neben einem technischen Signal eine begründete Betrachtung des konkreten Falls. Das gilt besonders, wenn Folgen für eine einzelne Person daran hängen.
Der Start erweitert die Verfahren zur Textherkunft um ein neues anbieterspezifisches Signal. Sein Nutzen hängt daran, wie zuverlässig es unter alltäglichen Bedingungen bleibt und wie Ergebnisse erklärt werden. Die begrenzte Freigabe des Detektors hält diese Erprobung zunächst in einem ausgewählten Kreis. Eine allgemein verfügbare, unabhängig geprüfte Erkennung für beliebige KI-Texte lässt sich aus der Veröffentlichung nicht ableiten.
Quellen
Für diesen Artikel wurden KI-gestützte Recherche- und Editierwerkzeuge verwendet. Der Inhalt wurde redaktionell geprüft.